5.1 统计信息管理
5.1 统计信息管理
本节摘要:优化器靠统计信息选执行计划,统计过期选错计划。本节讲清楚统计信息采集、自动更新、直方图、统计与执行计划关系,让优化器选对计划。
统计信息是什么
统计信息:表的行数、列值分布、基数、直方图等。优化器用统计估算查询成本,选执行计划。
统计影响:
- 用哪个索引(选择性高低判断)。
- JOIN 顺序(小表驱动大表)。
- JOIN 算法(Nested Loop/Hash/Merge)。
- 行数估算(影响内存分配、是否临时表)。
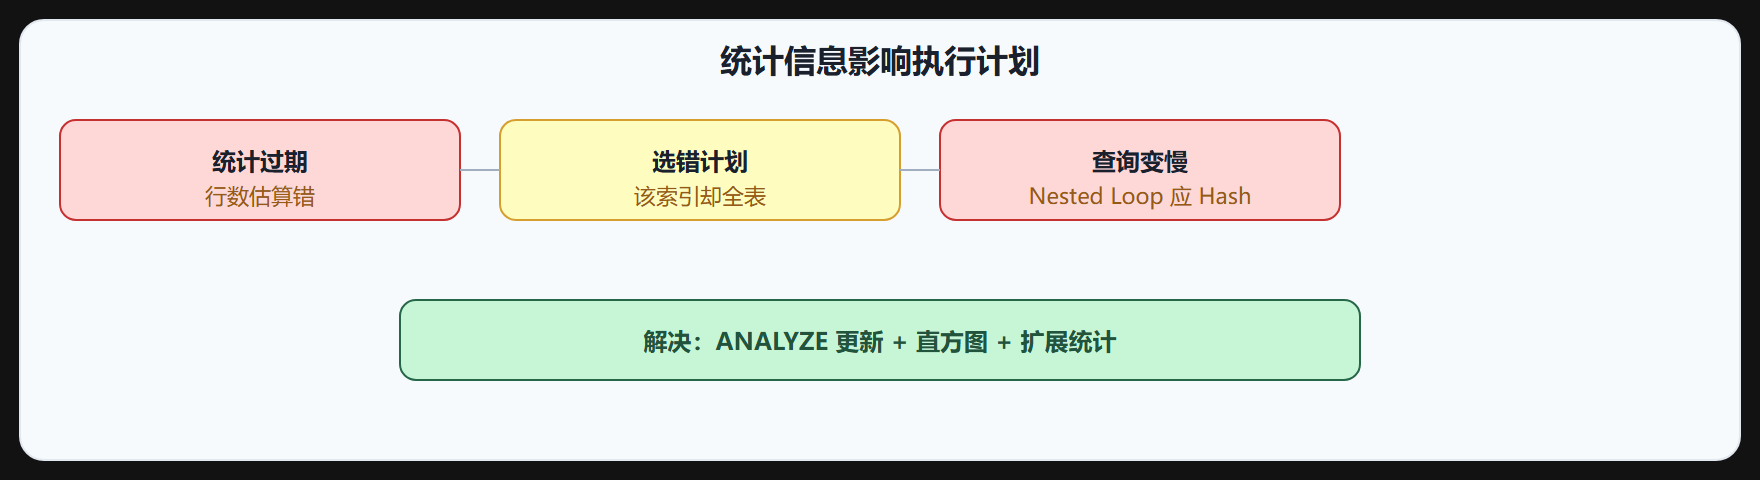
统计过期→估算错→选错计划(如该用索引却全表,该 Hash 却 Nested Loop)。
MySQL 统计信息
采集:
- ANALYZE TABLE t——手动更新统计。
- 自动采集——表数据变化超阈值自动更新(innodb_stats_auto_recalc=ON 默认)。
- 采样——innodb_stats_persistent_sample_pages(默认 20 页),采样页多则准但慢。
持久化:
- innodb_stats_persistent=ON(默认)——统计存磁盘,重启不丢。
- OFF——存内存,重启重新采集。
直方图(MySQL 8.0+):
- ANALYZE TABLE t UPDATE HISTOGRAM ON col——对非索引列建直方图。
- 优化器用直方图估算非索引列选择性。
- 适合:非索引列常用于 WHERE 过滤,但选择性不均(如 status 多数 active 少数 inactive)。
问题:
- 统计过期——大表采样少页,统计不准。
- 数据分布变——统计未及时更新。
- 解决:定期 ANALYZE、调采样页、用直方图。
PostgreSQL 统计信息
采集:
- ANALYZE t——手动更新。
- autovacuum 自动 ANALYZE(autovacuum_analyze_threshold/scale_factor 触发)。
- 采样——default_statistics_target(默认 100,列级可调),值大采样多准但慢。
统计视图:
- pg_stats——列统计(most_common_vals、histogram_bounds 等)。
- pg_class.reltuples——表行数估算。
扩展统计(PG 10+):
- CREATE STATISTICS——多列统计(函数依赖、MCV、NDV)。
- 解决多列组合选择性估算不准(如 WHERE a=? AND b=? 单列统计不准)。
问题:
- 统计过期——autovacuum 跟不上。
- 大表统计慢——采样多。
- 解决:调 autovacuum 参数、手动 ANALYZE、扩展统计。
Oracle 统计信息
采集:
- DBMS_STATS.GATHER_TABLE_STATS/GATHER_SCHEMA_STATS。
- 自动采集——自动统计收集任务(夜间窗口)。
- 采样——ESTIMATE_PERCENT(AUTO_SAMPLE_SIZE 自动)。
直方图:
- METHOD_OPT——'FOR COLUMNS SIZE N col'(N 桶数)。
- 数据分布不均列建直方图。
绑定变量窥视:
- 首次执行用绑定值选计划,后续用同计划。
- 可能选错——不同绑定值最优计划不同。
- 11g+ 自适应游标共享(ACS)解决。
统计信息管理实践
1. 定期更新
- 定期 ANALYZE——如每天/每周低峰期。
- 大表单独 ANALYZE——避免全库慢。
- 自动更新 + 手动补充——自动跟不上时手动。
2. 监控统计新鲜度
- 看最后分析时间——MySQL information_schema.TABLES、PG pg_stat_user_tables。
- 数据变化大但统计旧——手动更新。
3. 调采样
- 大表调高采样——更准但慢。
- 小表全量采样——准且快。
- 按表调(MySQL 列级 sample_pages、PG 列级 statistics_target)。
4. 直方图
- 非索引列常用于 WHERE——建直方图。
- 数据分布不均——直方图帮优化器判断。
5. 扩展统计
- 多列组合 WHERE——建扩展统计(PG CREATE STATISTICS、Oracle 多列统计)。
6. 锁定统计
- Oracle 可锁定统计——防自动采集覆盖手动调优的统计。
- 谨慎用——锁定后数据变统计不变。
统计与执行计划
统计过期导致执行计划问题:
问题1:该用索引却全表
- 统计显示表小(行数少)→优化器判全表快。
- 实际表大→全表慢。
- 解决:更新统计。
问题2:JOIN 顺序错
- 统计显示 A 表大 B 表小→B 驱动 A。
- 实际 A 小 B 大→应 A 驱动 B。
- 解决:更新统计或 hint。
问题3:行数估算错
- 统计显示过滤后 100 行→用 Nested Loop。
- 实际 100 万行→Nested Loop 慢,应 Hash。
- 解决:更新统计、直方图、扩展统计。
问题4:参数嗅探
- 首次执行用某参数选计划,后续不同参数用同计划可能慢。
- 解决:重新编译、参数提示、ACS(Oracle)。
⚠️ 常见误读:以为"统计自动更新就不用管"。自动更新有阈值和延迟,大表或数据突变时可能跟不上。要监控统计新鲜度,必要时手动 ANALYZE。
💡 关键直觉:统计信息(表行数/列分布/基数/直方图)优化器用来选计划(索引/JOIN 顺序/算法/行数估算),过期选错计划。MySQL(ANALYZE TABLE 手动/innodb_stats_auto_recalc 自动/innodb_stats_persistent_sample_pages 采样页调高准/持久化/8.0 直方图 UPDATE HISTOGRAM 非索引列选择性)。PG(ANALYZE/autovacuum 自动/default_statistics_target 采样列级可调/pg_stats 视图/扩展统计 CREATE STATISTICS 多列组合)。Oracle(DBMS_STATS/自动夜间/ESTIMATE_PERCENT/直方图 METHOD_OPT/绑定变量窥视+ACS)。管理:定期 ANALYZE(每天/每周低峰,大表单独)、监控最后分析时间(数据变旧则手动)、调采样(大表调高/小表全量)、直方图(非索引 WHERE 列/分布不均)、扩展统计(多列 WHERE)、锁定统计谨慎。统计过期问题:该索引却全表/JOIN 顺序错/行数估算错(Nested Loop 应 Hash)/参数嗅探(首次选计划后续慢,重新编译/ACS)。
本节要点回顾
- 统计信息:表行数/列分布/基数/直方图,优化器用统计估算成本选计划(索引/JOIN 顺序/算法 Nested Loop/Hash/Merge/行数估算)。过期选错计划(该索引却全表/JOIN 顺序错/行数错选错算法)。
- MySQL:ANALYZE TABLE 手动、innodb_stats_auto_recalc 自动(阈值触发)、innodb_stats_persistent_sample_pages 采样页(默认 20 调高准但慢)、innodb_stats_persistent 持久化、8.0 直方图(UPDATE HISTOGRAM 非索引列选择性,分布不均列)。
- PostgreSQL:ANALYZE 手动、autovacuum 自动(analyze_threshold/scale_factor 触发)、default_statistics_target 采样(默认 100 列级可调)、pg_stats 视图、扩展统计 CREATE STATISTICS(多列组合函数依赖/MCV/NDV,解决 WHERE a=? AND b=? 单列不准)。
- Oracle:DBMS_STATS 采集、自动夜间窗口、ESTIMATE_PERCENT AUTO_SAMPLE_SIZE、直方图 METHOD_OPT、绑定变量窥视(首次绑定值选计划)+11g ACS 自适应游标共享。
- 管理实践:定期 ANALYZE(每天/每周低峰,大表单独)、监控最后分析时间(information_schema.TABLES/pg_stat_user_tables,数据变旧手动)、调采样(大表调高准慢/小表全量)、直方图(非索引 WHERE 列分布不均)、扩展统计(多列 WHERE)、锁定统计谨慎(防自动覆盖手动)。
- 统计过期问题:该索引却全表(统计显示表小实际大)、JOIN 顺序错(统计显示 A 大 B 小实际反)、行数估算错(统计 100 行用 Nested Loop 实际 100 万应 Hash)、参数嗅探(首次参数选计划后续不同参数慢,重新编译/参数提示/ACS)。
统计信息的三级时效策略
统计信息管理可以组织成三级时效策略。一级,自动收集的基线:开启自动统计,覆盖大部分常规表——它的盲区是大表(采样慢、触发滞后)与写入突增的表(统计落后于数据形态)。二级,重点表的手动窗口:核心大表配置专属的低峰手动收集,控制采样比例在"估算精度与收集成本"的甜点(大表可适度降低采样率,配合直方图补关键列的分布信息)。三级,变更触发的即时更新:批量导入、归档删除这类让数据形态剧变的操作后,脚本化地主动更新相关表统计——等自动机制追上来之前,优化器已经在错误统计上跑了几个小时的烂计划。三级策略之外,配一个监控维度:统计信息年龄与执行计划突变的相关性——当某查询的执行计划忽然翻转,先查它涉及表的统计时间戳,多数"玄学变慢"在这个时间戳上能找到答案。统计信息是优化器的眼睛,本章把它放在维护章第一位,因为它是唯一"坏了不报警、只默默变蠢"的组件。
直方图与相关性:统计的进阶补丁
统计信息管理的进阶话题是两个补丁:直方图与列相关性。直方图:当某列数据严重倾斜(状态列九成是"已完成"),均匀分布的假设让优化器对"状态等于异常"的选择性估算离谱(以为要扫很多行其实只有几行,或反之)——给倾斜列建直方图,估算立刻回到现实;判断哪列需要直方图的方法是"高频过滤列的选择性偏差",数据质量巡检时顺手统计。列相关性:独立列的假设在"城市与邮编"这类强相关列上失效,组合条件的行数估算偏差指数放大——部分库提供相关性统计,没有这个能力的就靠改写(把强相关条件合并为派生列)或手工修正。两个补丁的维护成本都不高(收集统计时顺带),但收益常常惊人——很多"优化器突然变笨"的悬案,破案钥匙就藏在倾斜列的直方图缺失里。进阶补丁的适用判断同样简单:统计信息新鲜、执行计划仍频繁误判时,来这两个方向找答案。
统计信息的监控指标
统计章收官给三个监控指标,把统计健康度变成可观测的数字。指标一,统计年龄:每张核心表的统计信息距上次收集的时长,超过业务变化周期(如一周)标黄——简单粗暴但有效。指标二,估算偏差率:抽样慢查询的"估算行数与实际行数"的比值,对数刻度统计——偏差两倍以上即统计质量不合格,这是最直接的证据型指标。指标三,计划翻转次数:同一查询指纹的执行计划变化频率,频繁翻转(周内多次)几乎必然指向统计不稳定或数据倾斜——配合第 6 小节的直方图补丁使用。三个指标进监控面板后,统计信息管理就从"定期做一下"的模糊任务变成"指标驱动的精确运维"——优化器的眼睛健康了,整个数据库的决策质量才有地基。
统计自动化的兜底脚本
统计章给一个兜底脚本的设计要点——自动化统计失效时的最后防线。触发器三件套:变更量触发(批量导入后自动触发目标表收集)、时间兜底(超过阈值未收集的表进清单)、异常联动(执行计划翻转告警联动收集)。执行侧三原则:低峰调度、采样率按表分级(核心表高采样、日志表低采样)、失败重试加告警(静默失败的统计任务比没有更糟——它给人"已经做了"的错觉)。脚本虽小,五脏俱全——它把统计管理从"依赖平台特性"变成"自己的可控资产",平台换版本时它依然工作。维护工作的最高境界就是这种"自动化里兜底、兜底里有告警"的层层设防——不是不信任平台,是不信任任何单点。
补一句团队协作的建议:把"统计信息质量"纳入发布流程的检查项——大版本上线清单里加一行"涉及大表结构与批量数据的变更,确认统计收集策略已触发";一行检查项的成本近零,防的却是"发布后优化器集体失明"这种最难排查的慢性病。维护的多数最佳实践,本质都是把关键动作挂到已有的流程节点上,让制度替人记忆。
统计信息的版本升级专项
补一个专项场景:数据库大版本升级后的统计信息重置。升级常带来统计口径与优化器行为的双重变化(收集算法、估算模型的调整),历史最优的执行计划在新版本里可能集体失效——所以版本升级的检查清单里,"全量重收集核心表统计加执行计划对比"要作为固定项。具体动作:升级前导出代表性查询的计划清单,升级后重收集统计再逐一对比计划变化,异常翻转的查询逐条定因(统计差异还是优化器行为差异)——这套对比法把版本升级从"祈祷式切换"变成"有证据的迁移"。多数升级后的性能悬案,病根都埋在统计与计划没有被系统性对照的那一步——专项的意义就是把这个坑从路径上移走。