5.5 健康检查与容量规划
5.5 健康检查与容量规划
本节摘要:等故障才发现问题就晚了。本节讲清楚健康巡检指标、巡检流程、容量规划、趋势预测,让数据库主动健康管理。
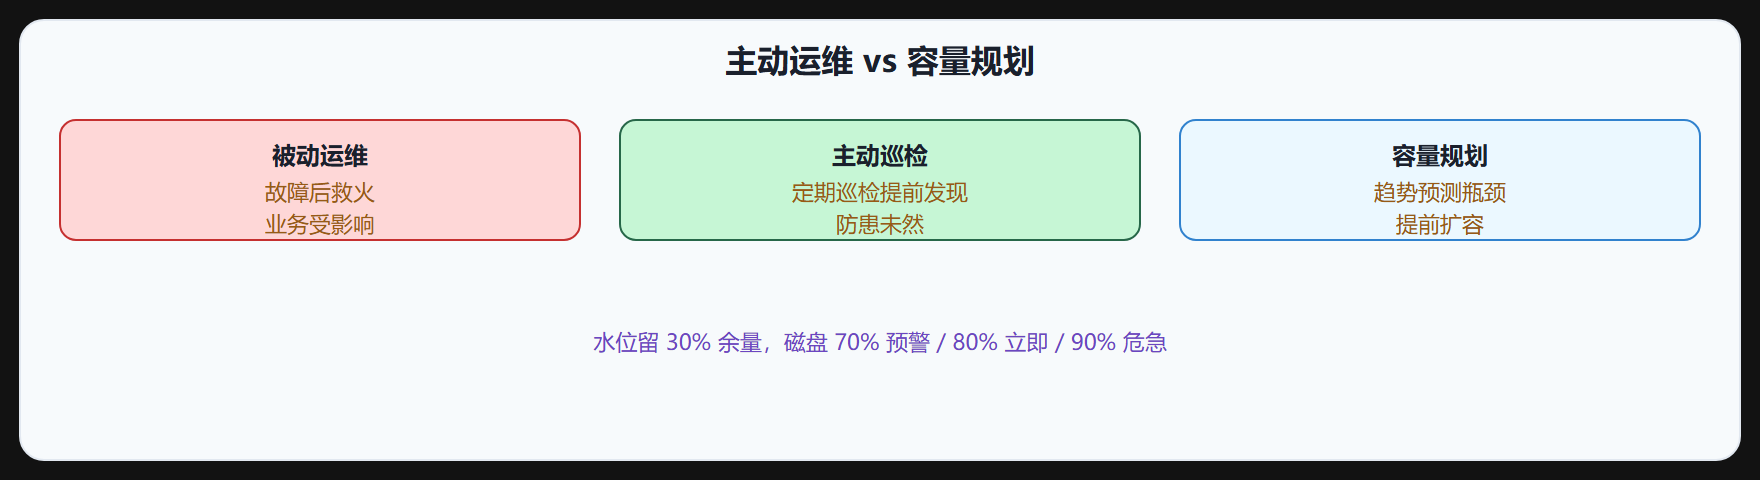
健康检查理念
被动运维:故障后处理——救火,业务受影响。
主动运维:定期巡检——发现问题提前处理,防患未然。
健康检查目标:
- 发现潜在问题——慢查询增长、空间不足、连接紧张。
- 评估性能趋势——退化早期预警。
- 规划容量——提前扩容避免瓶颈。
健康检查指标
1. 性能指标
- QPS/TPS——吞吐,趋势看增长。
- P50/P95/P99 延迟——响应,趋势看退化。
- 缓冲池命中率——应 >99%。
- 慢查询数/耗时——慢查询趋势。
2. 资源指标
- CPU 使用率——应 <70%(留余量)。
- 内存使用——缓冲池 + 应用,不 swap。
- 磁盘 IO——利用率、等待、队列。
- 磁盘空间——剩余空间,趋势。
- 网络——带宽、延迟。
3. 数据库指标
- 连接数——当前 vs max,接近上限告警。
- 锁等待——锁等待数/时长。
- 事务/锁等待——长事务、死锁。
- 复制延迟——主从延迟。
- 错误数——错误日志数量/类型。
4. 存储指标
- 表大小——增长趋势。
- 索引大小——增长趋势。
- 碎片率——DATA_FREE/总大小。
- 死元组(PG)——n_dead_tup。
巡检流程
1. 自动巡检
- 监控系统(Prometheus/Zabbix/Datadog)采集指标。
- 仪表盘可视化(Grafana)。
- 阈值告警——超阈值自动告警。
2. 定期人工巡检
- 每日——看告警、慢查询、错误日志。
- 每周——看趋势、容量、性能退化。
- 每月——深度巡检、容量规划、优化复盘。
3. 巡检报告
- 当前状态——指标快照。
- 趋势分析——环比/同比变化。
- 异常/风险——发现的问题。
- 建议——优化/扩容/调整。
容量规划
容量规划:预测未来资源需求,提前准备。
1. 数据增长
- 监控表大小增长趋势——月增多少 GB。
- 预测何时到瓶颈——如磁盘 80% 预警,按增长算何时到。
- 提前扩容——在瓶颈前扩磁盘/分库。
2. 流量增长
- QPS/TPS 增长趋势——业务增长带动。
- 预测何时到瓶颈——CPU/IO/连接上限。
- 提前扩容——加机器/读写分离/分片。
3. 资源水位
- CPU/内存/IO/磁盘水位——留 30% 余量。
- 水位高——扩容或优化。
- 水位低——可缩容省成本(云)。
4. 扩容方案
- 垂直扩容——升级机器(CPU/内存/磁盘),简单但有上限。
- 水平扩容——加机器(读写分离/分片/集群),复杂但无限。
- 云弹性——按需扩缩容(RDS 自动扩容)。
趋势预测
1. 线性预测
- 按历史增长率线性外推——简单,假设增长稳定。
- 如磁盘月增 10GB,剩 100GB,约 10 个月到。
2. 周期性预测
- 考虑业务周期——如电商大促季增长快。
- 按周期预测——大促前提前扩容。
3. 异常检测
- 增长突变——如突然增长快,可能数据异常或业务变化。
- 提前预警——异常增长调查原因。
4. 容量预警
- 磁盘 70% 预警——开始规划扩容。
- 80% 紧急——立即扩容。
- 90% 危急——可能影响业务。
健康检查工具
1. 监控系统
- Prometheus + Grafana——通用,自定义指标。
- Zabbix——传统,agent 采集。
- Datadog/New Relic——商业 APM 全栈。
- 云监控——AWS CloudWatch/阿里云监控。
2. 数据库巡检工具
- MySQL:pt-mysql-summary、MySQLTuner 脚本。
- PostgreSQL:pgbadger(日志分析)、pgstatspack。
- Oracle:AWR/ADDM 报告。
- SQL Server:DMV 查询、健康检查脚本。
3. 自动化
- 脚本定期巡检——生成报告。
- 阈值告警——自动通知(邮件/钉钉/Slack)。
- 自动扩容——云数据库自动扩容策略。
⚠️ 常见误读:以为"等告警再处理"。告警是已出问题,可能已影响业务。主动巡检+趋势预测提前发现,防患未然。
💡 关键直觉:主动运维(定期巡检提前处理)vs 被动运维(故障后救火)。健康指标——性能(QPS/TPS、P50/P95/P99 延迟趋势、缓冲池命中率 >99%、慢查询趋势)、资源(CPU <70% 留余量、内存不 swap、IO 利用率/等待/队列、磁盘空间剩余趋势、网络)、数据库(连接数 vs max 接近告警、锁等待、长事务死锁、复制延迟、错误数)、存储(表/索引大小增长趋势、碎片率 DATA_FREE、PG 死元组)。巡检流程——自动(Prometheus/Zabbix/Datadog 采集+Grafana 仪表盘+阈值告警)+定期人工(每日告警/慢查询/错误,每周趋势/容量/退化,每月深度/规划/复盘)+报告(快照/趋势/异常/建议)。容量规划——数据增长(月增 GB 预测瓶颈时间提前扩)、流量增长(QPS/TPS 业务带动预测 CPU/IO/连接瓶颈)、资源水位(留 30% 余量高扩低缩)、扩容方案(垂直升级简单有上限/水平加机器复杂无限/云弹性按需)。趋势预测——线性外推(月增 10GB 剩 100GB 约 10 月)、周期性(大促季增长快提前扩)、异常检测(突变调查)、容量预警(磁盘 70% 规划/80% 立即/90% 危急)。工具——Prometheus+Grafana/Zabbix/Datadog/云监控、pt-mysql-summary/MySQLTuner/pgbadger/AWR/DMV、自动化脚本报告+阈值告警+云自动扩容。
健康检查要点
- 健康检查理念:主动运维(定期巡检提前处理防患未然)vs 被动运维(故障后救火业务受影响)。目标发现潜在问题/评估性能趋势/规划容量提前扩容。
- 指标:性能(QPS/TPS 吞吐趋势、P50/P95/P99 延迟退化趋势、缓冲池命中率 >99%、慢查询数/耗时)、资源(CPU <70% 留余量、内存不 swap、磁盘 IO 利用率/等待/队列、磁盘空间剩余趋势、网络带宽延迟)、数据库(连接数 vs max 接近告警、锁等待数/时长、长事务/死锁、复制延迟、错误数)、存储(表/索引大小增长趋势、碎片率 DATA_FREE/总大小、PG n_dead_tup)。
- 巡检流程:自动(Prometheus/Zabbix/Datadog 采集+Grafana 仪表盘+阈值告警)+定期人工(每日告警/慢查询/错误日志,每周趋势/容量/性能退化,每月深度巡检/容量规划/优化复盘)+报告(当前快照/趋势分析/异常风险/优化扩容建议)。
- 容量规划:数据增长(监控表大小月增 GB,预测瓶颈时间提前扩磁盘/分库)、流量增长(QPS/TPS 业务增长预测 CPU/IO/连接瓶颈提前加机器/读写分离/分片)、资源水位(留 30% 余量,高扩容或优化低缩容省成本)、扩容方案(垂直升级简单有上限/水平加机器复杂无限/云弹性按需)。
- 趋势预测:线性外推(历史增长率,月增 10GB 剩 100GB 约 10 月)、周期性(业务周期大促季增长快提前扩)、异常检测(突变增长调查原因)、容量预警(磁盘 70% 规划/80% 立即扩/90% 危急影响业务)。
- 工具:监控系统(Prometheus+Grafana 通用自定义/Zabbix 传统 agent/Datadog New Relic 商业 APM/云监控 CloudWatch)、数据库巡检(pt-mysql-summary/MySQLTuner/pgbadger/pgstatspack/AWR ADDM/DMV)、自动化(脚本定期报告/阈值告警邮件钉钉 Slack/云自动扩容策略)。
健康分:把检查表变成数字
健康检查的进阶形态是把几十项检查聚合成一个可追踪的"健康分"。设计方法:把检查项分四组(性能水位、可靠性保障、维护时效、容量余量),每组若干指标各配权重与分档规则(绿黄红),加权合成总分;总分与分组得分每周记录,形成趋势线。健康分的价值不在绝对数值,在两处:纵向趋势——分数缓慢下滑预示慢性病(碎片累积、统计老化、容量逼近),在报警前就进入视野;横向对比——多套数据库环境用同一标尺打分,资源与管理注意力可以按分数精准投放。落地提示:评分规则要公开透明(每项怎么算的写在 Wiki),否则分数会退化成没有公信力的装饰;季度回顾时修订权重——上季度暴露的盲区应该变成这季度的检查项。健康分体系是维护工作从"救火队"升级为"经营体"的标志:你管理的不再是一堆告警,而是一个有账面、有趋势、可优化的资产组合。
容量红线与升级触发器
容量规划的收官是把"何时行动"写成明确的触发器,而不是靠感觉。三条容量红线(越线即启动扩容流程):CPU 峰值利用率连续一周超过七成(排队延迟开始非线性上升)、缓冲池工作集覆盖度跌破九成(热数据开始挤兑)、存储余量低于三倍月增长(留给扩容采购的窗口不足)。升级触发器的分级:黄线触发评估(上会讨论、方案比选、预算申请),红线触发执行(预案已备、窗口排期、直接开工)——两级触发的意义是把"扩容决策"从救火节奏变成项目管理节奏。触发器之外的年度校准:每年一次回到第 1 章的饱和点实验,重新标定红线数值——业务形态变了,红线的位置也要跟着变。这套机制的最终目的是一句朴素的话:让容量问题永远出现在计划表上而不是故障报告里。
从健康检查到运维自动化
健康章收官指一条演进路线:从人工检查到运维自动化。阶段一,清单驱动:人工按检查表巡检——起步必经,也是感受指标含义的唯一途径。阶段二,脚本驱动:检查项脚本化,定时执行输出报告——效率十倍,但解读仍靠人。阶段三,指标驱动:检查项全部指标化进监控,异常自动告警——检查从"定期看"变成"持续盯"。阶段四,预案驱动:常见异常配自动处置(统计过期自动收集、碎片超阈值自动排期、容量触线自动开单)——人只处理例外。四个阶段的推进节奏由信任积累决定:每个自动化动作必须先人工做够百次、预案验证过十次——跳级自动化的代价是"自动化的错误执行得更快"。这条路走完,一个 DBA 管理的实例数从几十台升到上千台——不是靠加班,是靠把重复的判断固化成系统。运维自动化的终点不是无人化,是人的注意力只用于真正的未知。
容量报告的一页纸模板
健康章收官给容量报告的一页纸模板——给管理层看的版本。第一块,水位现状:三项核心资源的峰值水位与红线(绿黄红三色)——一眼看清离极限多远。第二块,趋势与预测:按当前斜率,各资源到达黄线红线的预计时点——给决策一个倒计时。第三块,方案与价格:到顶前的可选项(扩容、优化、架构改造)各自的价格与收益——把技术问题翻译成投资决策。第四块,本次建议:明确的一句话建议与截止时间——报告要能被批准,先要能被读完。一页纸模板的深层价值:它强迫容量思考从"指标罗列"升级为"决策支持"——当你的容量报告开始被引用进预算会议,容量管理就完成了从技术职能到经营职能的跃迁,这也是 DBA 职业价值的天花板所在。
最后送一个沟通心法:容量报告里永远同时呈现"已做的优化"与"剩余的水位"——只讲水位显得在要资源,只讲优化显得没问题;两者并列讲的是完整的故事:"我们努力挤出了三个月,这是证据,也是请你决策的原因"。容量管理一半是工程,一半是叙事,后者常被工程师轻视,却常是资源能不能批下来的关键。