6.1 CPU与内存硬件选型
6.1 CPU与内存硬件选型
本节摘要:数据库靠 CPU 算、靠内存缓存。本节讲清楚 CPU 核数/频率/架构选型、内存容量/带宽/类型、NUMA 亲和,让硬件匹配数据库负载。
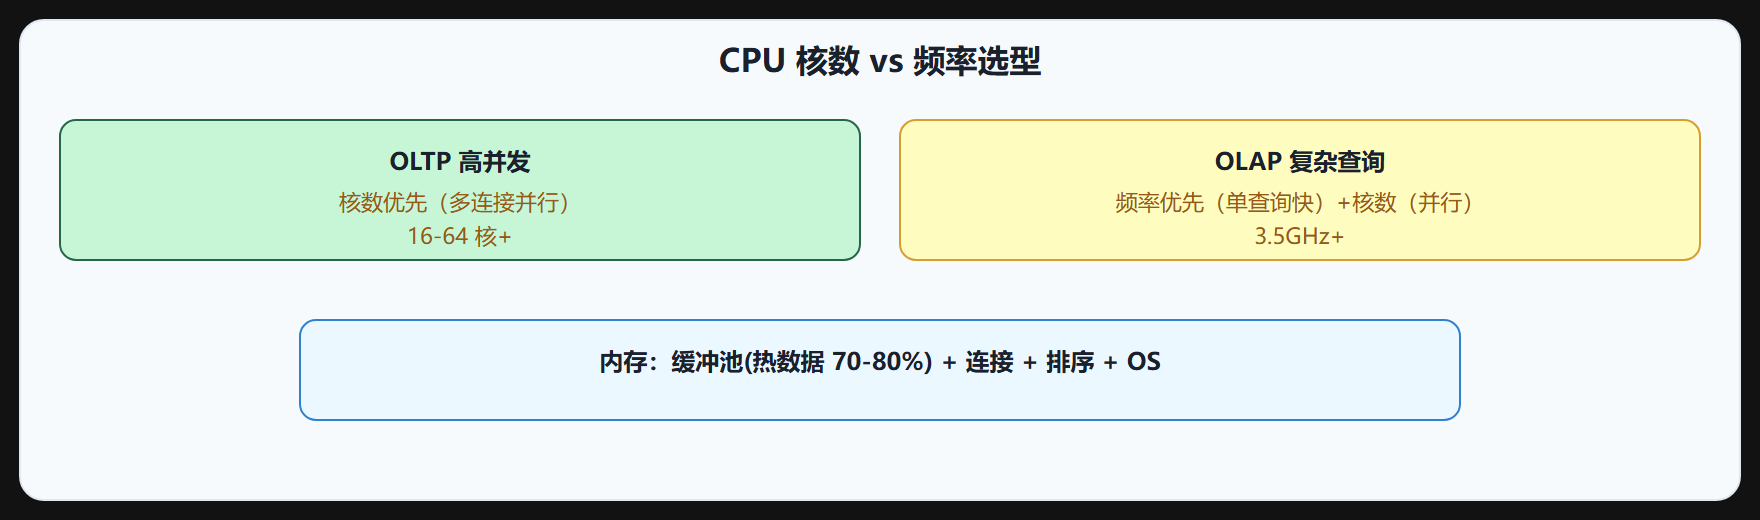
CPU 对数据库的影响
数据库 CPU 用途:
- 查询解析/优化——每查询 CPU。
- 执行——计算、聚合、排序、JOIN。
- 并发——多连接多线程,多核并行。
- 后台——刷脏页、purge、VACUUM、复制。
CPU 瓶颈表现:
- CPU 使用率高(>80%)——计算密集查询或并发多。
- 慢查询 CPU 高——复杂查询/聚合/排序。
- 上下文切换多——连接/线程太多。
CPU 核数 vs 频率
核数:
- 多核——并发处理多连接/查询。
- OLTP 高并发——多核重要(每连接一线程/进程)。
- OLAP 复杂查询——多核并行查询(PG 并行查询、MySQL 8.0 并行)。
- 推荐:生产 16-64 核,高并发 64+。
频率:
- 高频——单查询快(CPU 主频决定单线程速度)。
- 串行查询(无并行)——高频重要。
- 推荐:基础 2.5GHz+,高频 3.5GHz+(延迟敏感)。
权衡:
- OLTP 高并发——核数优先(多连接并行)。
- OLAP 单查询复杂——频率优先(单查询快)+ 核数(并行查询)。
- 多数场景——核数和频率平衡,现代 CPU 多核高频都有。
CPU 架构
x86(Intel/AMD):
- 主流,生态成熟。
- Intel Xeon/AMD EPYC 服务器级。
- AVX 指令集——加速某些计算。
ARM:
- AWS Graviton、阿里云倚天、华为鲲鹏。
- 性价比好(成本/性能比优)。
- 数据库已支持(MySQL/PG/Oracle ARM 版)。
选择:
- 成本敏感——ARM 性价比。
- 兼容性优先——x86。
- 云上按需选实例类型。
内存对数据库的影响
内存用途:
- 缓冲池——缓存数据(最重要,见 4.1)。
- 排序/聚合——work_mem/sort_buffer。
- 连接——每连接内存。
- 系统——OS 文件缓存(PG 依赖)。
内存不够:
- 缓冲池小——命中率低,读盘多。
- swap——比读盘还慢,严重退化。
- OOM——进程被杀。
内存容量选型
估算:
- 缓冲池——热数据大小(如热数据 50GB,缓冲池 50-70GB)。
- 连接内存——每连接 1-10MB × 连接数。
- 排序/聚合——work_mem × 并发查询 × 每查询操作数。
- OS 和其他——留 20-30%。
例:
- 热数据 100GB → 缓冲池 100-140GB(MySQL 70-80%)。
- 500 连接 × 5MB = 2.5GB。
- 排序 64MB × 50 并发 × 3 操作 = 9.6GB。
- 总约 150GB,选 192GB 机器留余量。
原则:内存宁多勿少(缓冲池大命中率高),但要算总内存避免 OOM。
内存带宽与类型
带宽:
- 多核同时访问内存——带宽瓶颈。
- 大服务器(多 socket)——内存带宽重要。
- OLAP 大扫描——带宽敏感。
类型:
- DDR4——主流,频率 2400-3200MHz。
- DDR5——新一代,带宽更高。
- ECC——纠错,服务器必选(防数据错误)。
配置:
- 多通道——插满所有通道最大化带宽。
- 对称插——每 CPU 对称插内存(NUMA)。
NUMA 与亲和
NUMA(Non-Uniform Memory Access):
- 多 CPU 服务器,每 CPU 有本地内存。
- 访问本地内存快,跨 CPU 访问远端内存慢。
问题:
- 数据库进程跨 NUMA 访问内存——慢。
- 缓冲池跨 NUMA 分散——访问不一致。
优化:
- NUMA 亲和——绑数据库进程到某 NUMA 节点,用本地内存。
- numactl --membind / --cpunodebind——绑定。
- innodb_numa_interleave=ON(MySQL)——缓冲池交错分配跨 NUMA。
- PG:numactl 启动,或内核 numad。
注意:
- 单 NUMA 节点够——绑本地。
- 跨 NUMA——交错分配平衡。
- 监控 NUMA 命中——numastat 看本地/远端访问。
CPU/内存监控
CPU:
- top/htop——CPU 使用率、负载。
- vmstat——上下文切换、运行队列。
- mpstat -P ALL——每核使用。
- 高 CPU + 高上下文切换——连接/线程多,调连接池。
内存:
- free -g——内存使用、swap。
- vmstat——swap in/out。
- numastat——NUMA 命中。
- 高 swap——内存不够,加内存或调参数。
⚠️ 常见误读:以为"核数越多越好"。核多但频率低,单查询慢;连接少但核多,浪费。按负载选——OLTP 核数优先,OLAP 频率+核数,平衡。
💡 关键直觉:CPU 用途(查询解析优化/执行计算聚合排序 JOIN/并发多连接多核/后台刷脏 purge VACUUM 复制)。核数 vs 频率——核数多并发(OLTP 高并发 16-64 核+),频率高单查询快(OLAP 串行 3.5GHz+),OLTP 核数优先 OLAP 频率+核数并行。架构(x86 主流 Xeon/EPYC AVX,ARM Graviton/倚天/鲲鹏性价比数据库已支持,成本敏感 ARM 兼容 x86)。内存用途(缓冲池最重要/排序聚合 work_mem/连接每连接/OS 文件缓存 PG 依赖)。容量估算(缓冲池热数据大小 70-80% MySQL+连接 1-10MB×连接+排序 work_mem×并发×操作+OS 留 20-30%,宁多勿少算总避免 OOM)。带宽类型(多核同时访问带宽瓶颈,DDR4 2400-3200/DDR5 更高,ECC 纠错服务器必选,多通道插满对称插)。NUMA(多 CPU 本地内存快远端慢,亲和绑本地 numactl/innodb_numa_interleave 交错,监控 numastat 本地/远端)。监控(CPU top/vmstat 上下文切换/mpstat 每核,内存 free/vmstat swap/numastat NUMA,高 swap 加内存)。
本节要点回顾
- CPU 影响:查询解析优化/执行(计算聚合排序 JOIN)/并发(多连接多核)/后台(刷脏 purge VACUUM 复制)。瓶颈:CPU >80% 计算密集或并发多,慢查询 CPU 高,上下文切换多连接线程多。
- 核数 vs 频率:核数多并发(OLTP 高并发多连接一线程,16-64 核+),频率高单查询快(OLAP 串行无并行,2.5GHz+ 基础 3.5GHz+ 延迟敏感)。OLTP 核数优先,OLAP 频率+核数(并行查询),平衡。
- 架构:x86(Intel Xeon/AMD EPYC 主流生态成熟 AVX),ARM(AWS Graviton/阿里云倚天/华为鲲鹏性价比数据库已支持 MySQL/PG/Oracle ARM 版)。成本敏感 ARM,兼容性优先 x86,云按实例类型选。
- 内存用途:缓冲池(最重要缓存数据)、排序/聚合(work_mem/sort_buffer)、连接(每连接 1-10MB)、OS 文件缓存(PG 依赖)。不够:缓冲池小命中率低读盘多、swap 比读盘慢严重退化、OOM 进程被杀。
- 容量估算:缓冲池(热数据大小,MySQL 70-80% 物理内存)、连接(1-10MB×连接数,500×5MB=2.5GB)、排序(work_mem×并发×操作,64MB×50×3=9.6GB)、OS 留 20-30%。宁多勿少但算总避免 OOM。例:热数据 100GB→缓冲池 100-140GB+连接 2.5GB+排序 9.6GB≈150GB,选 192GB。
- 带宽类型:多核同时访问带宽瓶颈(大服务器多 socket、OLAP 大扫描敏感),DDR4(2400-3200MHz 主流)/DDR5(更高),ECC(纠错服务器必选防数据错误),多通道插满最大化带宽,对称插每 CPU 对称(NUMA)。
- NUMA:多 CPU 本地内存快远端慢。问题进程跨 NUMA 访问慢、缓冲池分散。优化:NUMA 亲和绑本地(numactl --membind/--cpunodebind)、innodb_numa_interleave=ON(MySQL 缓冲池交错)、PG numactl/numad。单节点够绑本地,跨节点交错平衡,监控 numastat 本地/远端访问。
- 监控:CPU(top/htop 使用率负载、vmstat 上下文切换运行队列、mpstat -P ALL 每核,高 CPU+高切换调连接池)、内存(free -g 使用 swap、vmstat swap in/out、numastat NUMA 命中,高 swap 加内存或调参数)。
选型测算的两个公式
硬件选型不靠感觉靠测算,给两个核心公式。内存测算:目标工作集(热数据大小)加工作区预算加系统预留,三者之和向上取整到内存档位;其中热数据的估算来自缓冲命中率曲线——把命中率对缓冲池大小画成曲线,曲线的"拐点后走平"位置就是热工作集的规模,比拍脑袋准得多。CPU 测算:以当前核数与当前 CPU 利用率为基准,按业务增长目标线性外推(吞吐翻倍大致需要核数翻倍,前提是扩展性没到拐点——高并发锁竞争下加核的边际收益递减,第 4 章的连接治理做了,扩核才有效)。两个公式之外补一个频率与核数的取舍直觉:OLTP 是"大量小查询的排队系统",核数(并发能力)通常优先于单核频率;分析型负载是"少数大查询的吞吐系统",单核性能与内存带宽的权重上升——用错方向的采购是预算的常见去向。最后一句:所有测算都要留三成余量给增长与突发,满打满算的选型是给下一年的自己挖坑。
扩展性天花板:加核失效的三个征兆
硬件选型的隐藏知识是"扩展性天花板"——加核不再提速的时刻,三个征兆提前预告它。征兆一,锁等待随并发线性上升:CPU 没满但吞吐停滞、锁等待占比持续攀升——瓶颈在串行点(热点行、全局锁、序列号分配),加核前先杀串行点。征门二,上下文切换吞噬增益:CPU 的系统占比(而非用户占比)随并发上升,切换次数是核数的数十倍——连接与线程模型要治理(第 4 章),不是核数问题。征兆三,共享资源排队:内存带宽、最后级缓存、IO 队列的争用在多核下加剧,表现为"核数翻倍吞吐只加三成"的亚线性——这提示架构级的天花板(换更快的单核或重构数据访问模式)临近。识别三个征兆的日常动作:扩容评估时必看"当前并发下的加速比曲线"而不是单纯的利用率——利用率还有余量但加速比已经躺平的系统,加核就是买摆设。硬件采购的最后一课:买的不是资源数量,是资源在真实负载下的转化率。
采购清单的技术条款
硬件章收官给一份采购清单的技术条款模板——把本章知识变成谈判桌上的语言。CPU 条款:核数与主频的双指标(不只报核数)、单核性能的基准证明(同类负载的公开跑分或厂商实测)。内存条欿:容量、通道数(带宽与容量的平衡)、纠错能力(数据库场景的基本要求)。存储条款:介质类型与耐久度等级、混合读写性能(分别报读写,不只报峰值读)、掉电保护或等效机制、多路径与故障切换的实测记录。网络条款:带宽、延迟保证(对分布式场景)、冗余链路。服务条款:备件与到场时效(恢复时间目标的硬件半边)、固件更新的兼容性承诺。条款模板的价值:把"感觉这家便宜"变成"按指标比价"——服务器采购的差价常在两三成,而规格理解偏差造成的性能损失也常在两三成,专业条款两头都省。采购是物理层的最后一战,弹药就是这份清单。
硬件问答两则
问:预算有限,CPU 和内存先升哪个? 答:看第 1 章的诊断——IO 等待高且缓冲命中率低,先内存(缓存命中率是免费的性能倍增器);CPU 饱和且等待集中在计算型算子,先 CPU;都紧张时内存的边际收益通常更陡(命中率曲线的拐点效应)。问:换新服务器要注意什么兼容性陷阱? 答:三个高频坑——内核版本差异让调优参数失效或引入新默认(第 4 小节的审计在此派上用场)、新 CPU 的架构差异让原本的绑核与亲和策略错位(NUMA 拓扑变了)、存储介质的代差让 IO 参数的最优点漂移(旧参数配新盘常是错配)。迁移前跑一遍阶梯压测对新硬件重新校准,比"参数原样搬"可靠一个量级——硬件升级不只是换盒子,是把六层调优在新地基上重走一遍关键步。
最后补一句关于监控埋点的提醒:新硬件上线时把"基础性能基准"(裸盘 IO、内存带宽、网络延迟的实测值)存进台账——设备老化的判断全靠与初始基准的对比,没有初始值的"感觉变慢了"永远无法立项换新;五分钟的初始基准,是三年后硬件更新的第一份证据。
补一个能救急的冷知识:CPU 降频行为(节能模式、温度墙)会让"性能突然减半"的悬案毫无软件征兆——排查动作是把频率监控(或功耗数据)加进观测面板,看到降频再查原因(散热、电源策略、机柜温度);这个知识点的价值在于它把一类"查遍六层无果"的悬案收编进了可观测的物理世界。硬件层的观测做完频率与温度两块,六层的仪表盘才算真正完整。
收尾补一句采购沟通的话术:向管理层申请硬件升级时,永远同时呈上"软优化已做"的证据清单(索引、参数、维护的台账摘要)——它既证明你不是拿钱偷懒,也精确定义了硬件需求的边界(在软手段到顶的前提下,物理层是唯一解);证据链完整的申请,通过率与批准速度都显著更高,这是技术沟通里的复利技巧。