1.2 复杂度分析:大O、大Ω、大Θ三重刻画
1.2 复杂度分析:大 O、大 Ω、大 Θ 三重刻画
本节摘要:复杂度分析用"操作次数随输入规模的增长趋势"替代掐表,大 O 给上界、大 Ω 给下界、大 Θ 给紧确界。本节给出三者的定义与推导规则(顺序相加取最大、嵌套相乘、均摊),配可复算的操作计数实验与增长曲线对照图,并列出三类高频误读。
上一节靠计数器发现了"摆法决定底价",但每次都数一遍太原始。这节要建立一套笔算就能完成的度量术:不运行程序,只看代码结构,就能写出操作次数的增长趋势,并明白三种记号各自承诺了什么。
从一个精确计数到大 O 记号
先看一段最普通的双层循环,把它的比较次数精确数出来:
# 精确计数:内层循环执行了多少次比较 def count_ops(n): c = 0 for i in range(n): # 外层 n 趟 for j in range(i + 1, n): # 内层趟数递减:n-1, n-2, ..., 1, 0 c += 1 return c for n in (10, 100, 1000): print(n, count_ops(n)) # 输出: # 10 45 # 100 4950 # 1000 499500
规律一眼可见:总次数是 0+1+…+(n-1) = n(n-1)/2。展开成多项式是 0.5n² - 0.5n。当 n = 1000 时,低阶项与常数系数对结果的影响已经不足千分之一。大 O 记号就是刻意丢掉这些"不改变趋势"的部分:我们说这段代码是 O(n²),意思是存在常数 c 与规模 n₀,当 n 超过 n₀ 后,操作次数永远不超过 c·n²。同理:
- 大 Ω(下界):操作次数至少是 c·g(n) 量级,描述"再怎么顺利也便宜不过这条线";
- 大 Θ(紧确界):上下界吻合,增长趋势就是 g(n) 本身。
对上面那段代码,n(n-1)/2 既不超过 1·n²(n≥1 即可),又不低于 0.25·n²(n≥2 即可),所以它既是 O(n²) 也是 Ω(n²),合起来就是 Θ(n²)。面试里说"这段代码是 O(n²)"通常想表达的其实是 Θ(n²)——严格说 O 只给了上界,O(n²) 的代码也可以是线性的。
常见量级的增长速度对照
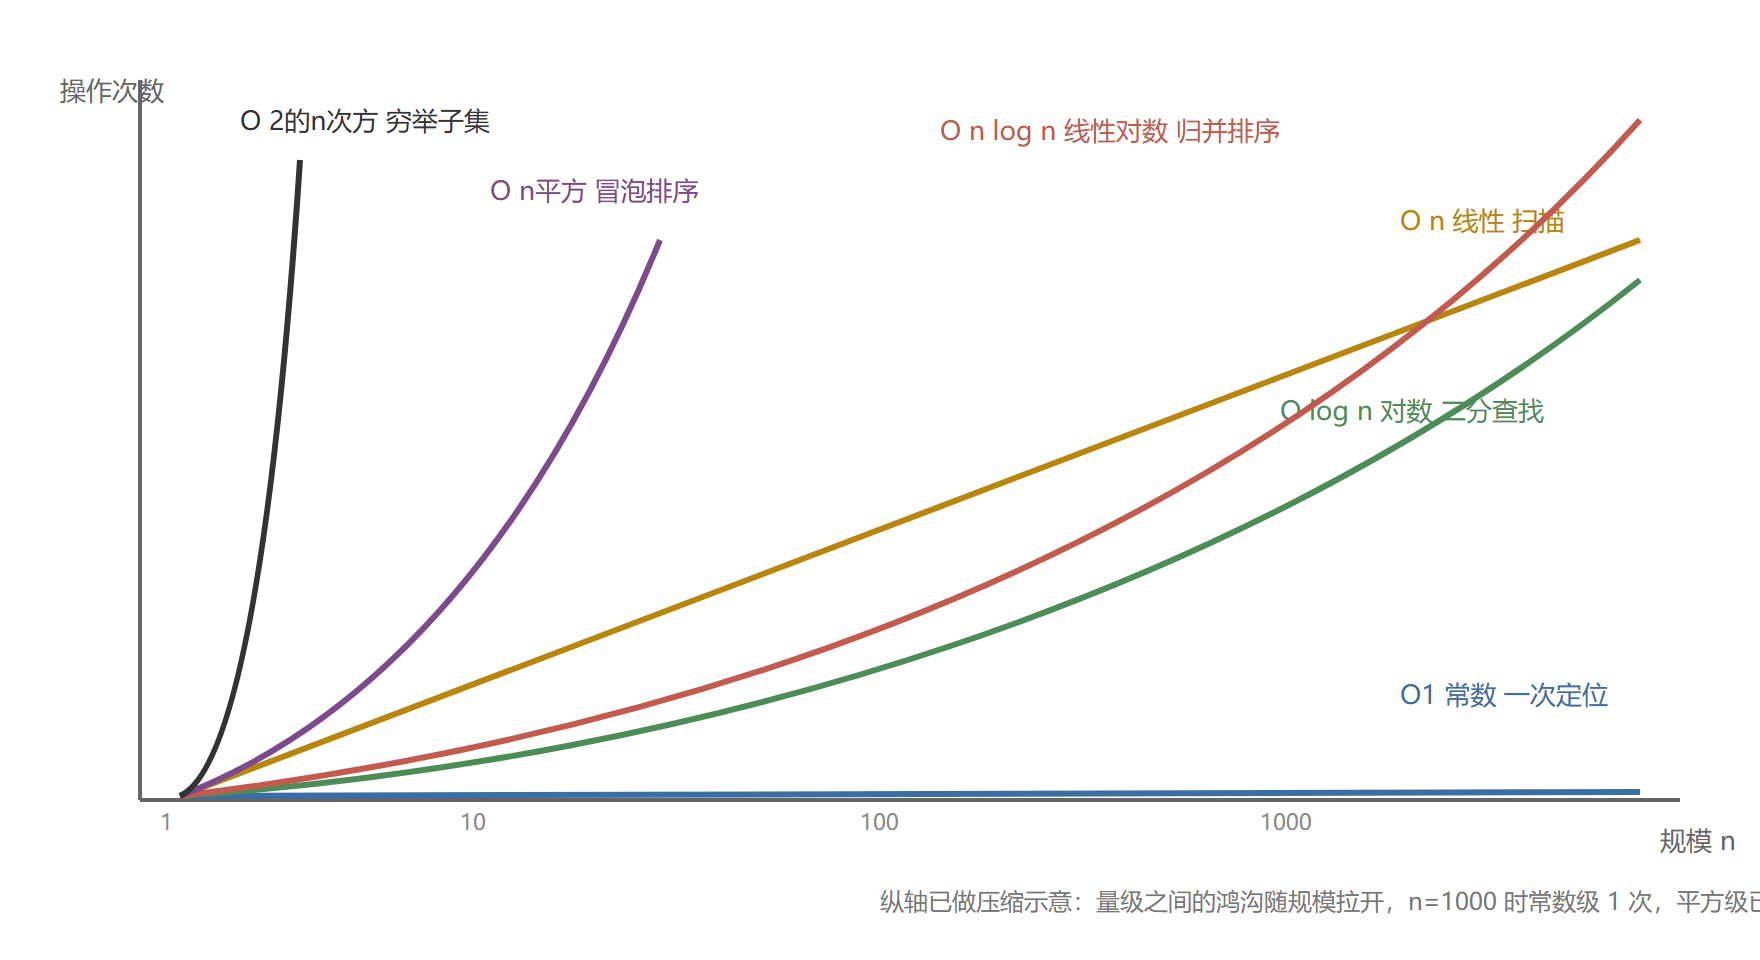
记一个直觉换算:现代 CPU 每秒可执行的基本操作在十的八九次方量级。预算一秒的话,平方级算法的规模上限大约在十万到三十万之间,对数级与线性级几乎不受限。做题或做架构时,先用这个换算反推"我的数据规模允许什么量级",往往能直接锁定结构选型。
推导三规则与三个反例
规则不多,误用不少。逐条给出正反例:
规则一:顺序执行相加,取最大项。 一段 O(n) 扫描接一段 O(n²) 排序,总代价 O(n + n²) = O(n²)。
规则二:嵌套执行相乘。 外层 n 趟、每趟内层平均 n/2 次,就是 Θ(n²),前面已数过。
规则三:循环变量跳跃时看趟数不看层数。 反例是这两段:
# 反例对照:层数相同,量级不同 def halve(n): # j 按 2 的幂前进 c = 0 j = 1 while j <= n: c += 1 j *= 2 return c # j 走过 1,2,4,... 直到超过 n,共约 log2(n) + 1 趟 def step_n(n): # j 每次加 1 c = 0 for j in range(n): c += 1 return c print("halve(1000) 趟数 =", halve(1000), ";step_n(1000) 趟数 =", step_n(1000)) # 输出:halve(1000) 趟数 = 10 ;step_n(1000) 趟数 = 1000 # 因为 2 的 10 次方 = 1024 已超过 1000,所以只有 10 趟
同样是"一个 while 一个 for",前者是对数趟、后者是线性趟。判断依据是循环变量到达边界的方式:按比例逼近(乘除)产生对数,按步长逼近(加减)产生线性。
均摊分析:把偶发的贵操作摊平。 动态数组(Python 的列表、Java 的 ArrayList)尾部追加是 O(1),靠的是容量翻倍策略。翻倍那一刻要整体搬家,是 O(n) 的贵操作;但翻倍间隔也在翻倍,摊到每次追加头上仍是常数。可以精确数出来:
# 均摊计数:动态数组从空追加 n 个元素,总共搬移多少次 def append_cost(n): capacity, moves, total = 1, 0, 0 for i in range(n): if total == capacity: # 装满则扩容:把旧元素全部搬进新容量 moves += capacity capacity *= 2 total += 1 return moves n = 1000 print("追加", n, "个元素,累计搬移 =", append_cost(n), ",均摊每次 =", append_cost(n) / n) # 输出:追加 1000 个元素,累计搬移 = 1023 ,均摊每次 = 1.023
搬移发生在容量 1、2、4、…、512 共十次扩容点,累计 1023 次,均摊到 1000 次追加上恰好略大于 1。这就是"均摊 O(1)"的来历:不是每次都便宜,而是任意连续一段操作的总代价除以次数后是常数。
走火入魔:三类高频误读
误读一:把大 O 当成"最坏情况"的同义词。 大 O 是上界的记号,可以用于最好、最坏、任何场景。快排的最坏是 O(n²)、期望是 O(n log n),两句话都在用大 O,描述的对象不同。想表达"平时也慢不到哪去"应该用期望或均摊。
误读二:常数与低阶项永远可以忽略。 渐进分析忽略常数的前提是规模足够大。小数组上插入排序赢过归并排序很常见——归并的递归与辅助数组开销在小规模时占大头,所以工业级排序实现都会在小区间切换到插入排序。量级锁方向,常数定落地。
误读三:忽视隐藏在表达式里的循环。 经典事故:循环里做字符串拼接。每次拼接都要复制整条旧串,n 次拼接的总复制量是 1+2+…+n,平方量级。计数实验:
# 隐藏的平方级:循环里拼接字符串 n = 4 chars = ["a", "b", "c", "d"] copied, s = 0, "" for ch in chars: s = s + ch # 每次新建字符串:旧内容全部复制一遍 copied += len(s) print("拼接完成:", s, ";累计复制字符数 =", copied) # 输出:拼接完成:abcd ;累计复制字符数 = 10(1+2+3+4) # 正确写法是收集到列表后一次性 join,复制量降为 n
同款事故还有:循环内每次 if x not in some_list(每次线性扫描)、循环内反复对同一列表排序。修炼心法之后,这类代码不用运行就该在眼里发红。
本节要点回顾
- 三种记号三种承诺:O 上界、Ω 下界、Θ 紧确界;说复杂度时先想清楚描述的是哪种场景;
- 推导规则:顺序相加取最大、嵌套相乘、循环变量按比例逼近产生对数;
- 均摊分析解释了动态数组追加为何算 O(1):贵操作稀疏且间隔翻倍,任意区段平均后是常数;
- 量级换算:一秒约十的八九次方次基本操作,用规模反推可接受的量级是选型的第一反应;
- 三个误读(O 不等于最坏、常数并非永远可忽略、表达式里藏着循环)都对应真实事故,值得背下来。
尺子已经造好。下一节认识第一门需要这把尺子的功法:递归——它既是后续诸多算法的骨架,也是最容易内力反噬的写法。