2.1 数组:连续内存买断了随机访问
2.1 数组:连续内存买断了随机访问
本节摘要:数组把元素紧密排在一整块连续内存里,地址可以做算术——第 i 个元素的地址等于首地址加 i 乘元素大小,所以按下标访问是严格的一步直达 O(1)。代价是插删要搬移,扩容要整体搬家。本节数清这两笔账,并解释二维数组的行优先映射与缓存放大的加成。
一段连续的内存,买断了什么
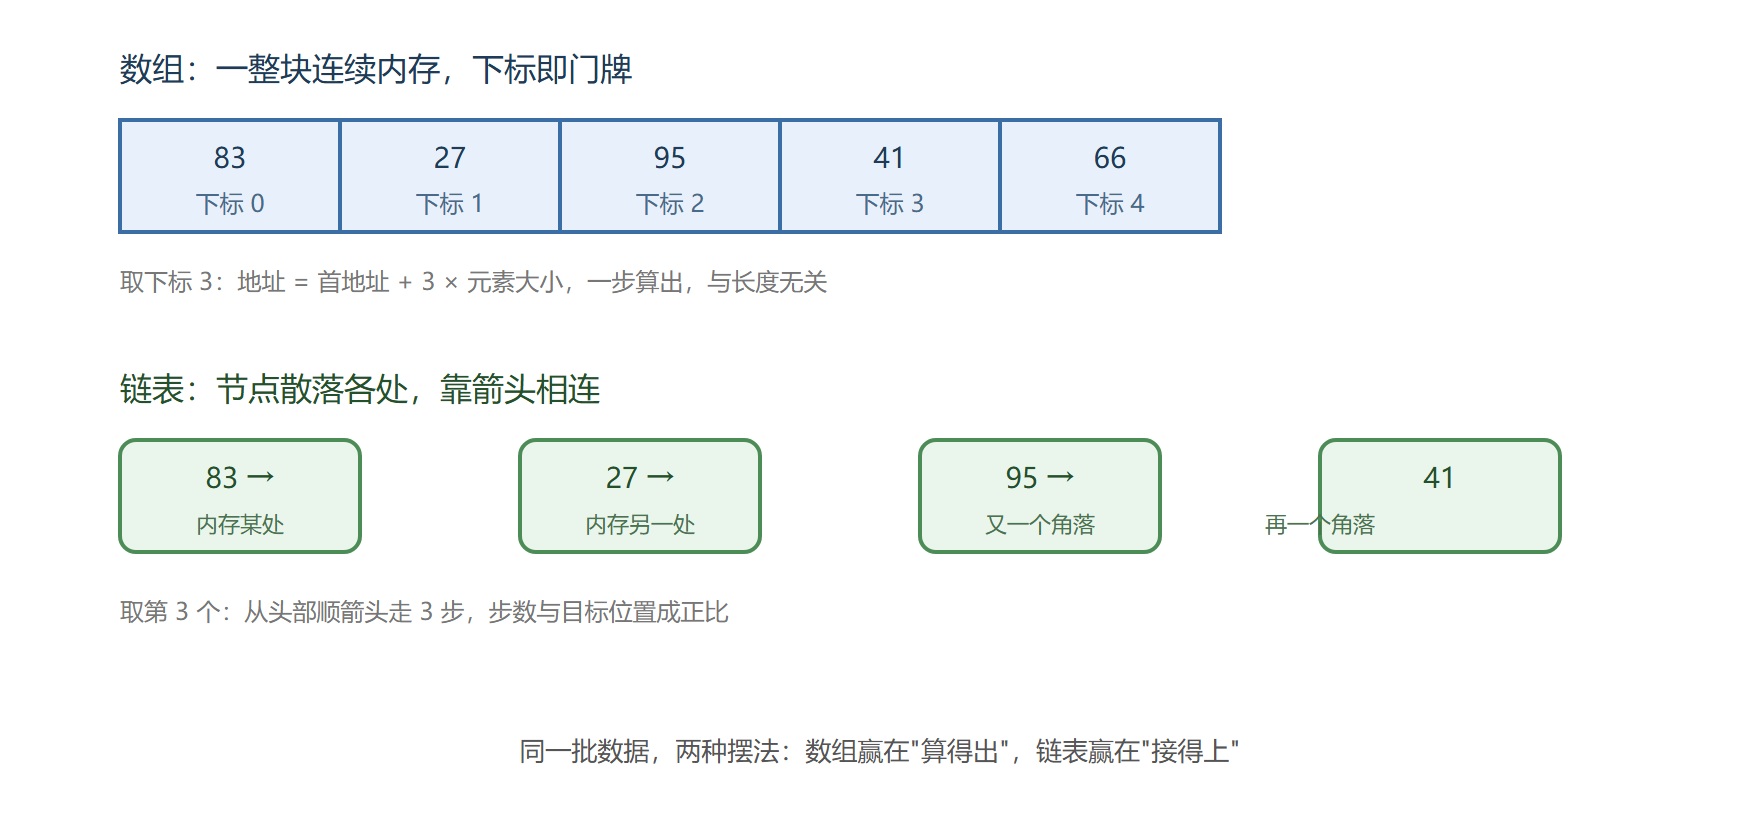
想象一排紧挨着的储物柜,柜门从零开始编号。想找 7 号柜,不需要从 1 号柜挨个走过去——门牌就是位置。数组在内存里就是这排柜子:下标与地址之间存在算术关系。设首元素地址为 base、每个元素占 size 字节,则第 i 个元素的地址恒等于 base 加上 i 乘 size。一次乘法一次加法,与数组多长无关——这就是 O(1) 随机访问的心法根基。
链表没有这层算术关系(下一节细说),想知道第 i 个元素在哪,只能从头部顺着链接走 i 步。一快一慢,根源只在"地址能不能算出来"。
数组与链表的内存布局对照
插删的账:搬移次数
连续是把双刃剑。要在下标 2 的位置插进一个新元素,2 号位之后的所有元素都得往后挪一格腾位置;删除同理,往前挪补洞。搬移次数可以直接数:
# 数一数:数组指定位置插入/删除各要搬移多少次 def insert_shift(arr, pos, val): arr.append(None) # 先扩一格 moves = 0 for i in range(len(arr) - 1, pos, -1): # 从尾部倒着搬 arr[i] = arr[i - 1] moves += 1 arr[pos] = val return arr, moves def delete_shift(arr, pos): moves = 0 for i in range(pos, len(arr) - 1): # 从删除点顺着往前补 arr[i] = arr[i + 1] moves += 1 arr.pop() return arr, moves a = [10, 20, 30, 40, 50] a, m1 = insert_shift(a, 2, 99) print("在下标 2 插入 99:", a, ",搬移次数 =", m1) # 输出:在下标 2 插入 99:[10, 20, 99, 30, 40, 50] ,搬移次数 = 3(50、40、30 各挪一次) a, m2 = delete_shift(a, 4) print("删除下标 4:", a, ",搬移次数 =", m2) # 输出:删除下标 4:[10, 20, 99, 30, 40] ,搬移次数 = 1(只剩 40 前挪)
规律:插入下标 pos 要搬 n - pos 次,删除要搬 n - pos - 1 次。最好情形(尾部操作)是 O(1),最坏(头部操作)是 O(n),平均折半仍是 O(n)。数组的正确用法是"读多写少、写集中在尾部";高频中间插删的需求,答案在链表或第 7 章的更重装备里。
尾部追加的均摊 O(1) 已在第一章 1.2 用搬移计数验证过(追加一千个元素累计搬移一千零二十三次,均摊约一次),此处只补一句心法:动态数组是"数组之骨加自动搬家之肉",Python 的 list、Java 的 ArrayList、C++ 的 vector 都是它。
二维数组:一条算术公式的延伸
二维数组并不神秘,内存本质上还是一条线,所谓"行优先存储"就是按行摊平。元素 a[i][j] 的地址等于首地址加 (i 乘列数 加 j) 乘元素大小。用下标演算验证:
# 行优先映射:二维下标如何折算成一维偏移 rows, cols = 3, 4 flat = [f"r{i}c{j}" for i in range(rows) for j in range(cols)] print("摊平后:", flat) # 输出:摊平后:['r0c0', 'r0c1', 'r0c2', 'r0c3', 'r1c0', 'r1c1', 'r1c2', 'r1c3', 'r2c0', 'r2c1', 'r2c2', 'r2c3'] def at(i, j): offset = i * cols + j # 一乘一加,O(1) return flat[offset] print("at(2, 1) =", at(2, 1), ";at(1, 3) =", at(1, 3)) # 输出:at(2, 1) = r2c1 ;at(1, 3) = r1c3 # 验证:2×4+1=9 号元素确实是 r2c1,1×4+3=7 号元素是 r1c3
这个映射还带来一件容易被低估的加成:缓存友好。按行遍历顺着内存走向访问,缓存行与预取器都在帮忙;按列遍历每次跳 cols 个元素,同一缓存行里的伙伴全被浪费。两者在量级上都是 O(n²),实测墙钟时间差出数倍是常事。排序、图遍历、动态规划填表时,"内层顺着内存走"是白捡的加速。
| 操作 | 复杂度 | 说明 |
|---|---|---|
| 按下标读/写 | O(1) | 地址算术直达 |
| 尾部追加 | 均摊 O(1) | 扩容搬家被翻倍间隔摊薄 |
| 任意位置插入/删除 | O(n) | 搬移填补空位 |
| 按值查找(无序) | O(n) | 只能扫;有序时可二分,见 5.4 节 |
| 按值查找(有序) | O(log n) | 二分查找的入场券 |
走火入魔:把 O(1) 的幻觉带出边界
**事故一:循环里用加号拼接数组。**写法 arr = arr + [x] 每次都新建整条数组,n 次追加的总搬移量是 1+2+…+n,平方量级;正解是 append(均摊常数)或一次 extend。这与第一章字符串拼接事故同源:加号造新容器,原方法改原容器。
**事故二:数组越界。**Python 会抛 IndexError 兜底,C 与 C++ 里越界读写是未定义行为,可能默默改掉相邻变量;Java 抛 ArrayIndexOutOfBoundsException。从 Python 转向系统语言的读者要补一条纪律:下标参与算术时(比如 mid 加一、i 减一),先想清楚边界会不会被穿透——第五章二分查找还会专门回到这个坑。
**事故三:误以为连续内存没有租金。**申请一亿个元素的数组,内存立刻按整块预留(C/Java)或占用(Python 按指针算);需求只到"最多几千个且稀疏"时,稀疏场景更该用哈希表或字典按需记账。数组买断的是"整块连续",用不满就是浪费。
💡 关键直觉:选数组的三问——按下标访问是不是最高频操作?总量能不能事先估个大概?中间插删是不是罕见?三问皆可,数组就是正解。
本节要点回顾
- O(1) 随机访问的根源是下标与地址的算术关系:首地址加 i 乘元素大小,与长度无关;
- 插删的账:插入搬 n - pos 次、删除搬 n - pos - 1 次,头部最坏 O(n);读多写少是数组的主场;
- 动态数组靠容量翻倍把扩容摊薄成均摊 O(1),1.2 节的搬移计数可直接复算;
- 二维数组是行优先摊平的一维数组,下标折算一乘一加;顺着内存方向遍历有缓存加成;
- 三类事故:加号拼数组、越界访问、整块内存浪费,都源于"只看见 O(1) 没看见租金"。
数组把元素锁死在连续内存里。想获得插删的自由,就得让节点散居各处、靠指针牵手——这就是下一节链表的心法。