2.5 哈希表:以空间换时间的乾坤大挪移
2.5 哈希表:以空间换时间的乾坤大挪移
本节摘要:哈希表用哈希函数把键直接换算成存储位置,不比较、不递进,一步定位,期望 O(1) 查找、插入、删除。代价有二:不同键可能算出同一位置(冲突),需要链地址法或开放寻址法善后;装载因子升高后性能下滑,需要扩容再散列。本节手工模拟两种冲突处理的全过程,算清探测次数。
不找位置,直接算位置
数组按"下标"取值是 O(1),可惜下标只是位置编号,不是业务含义。哈希表的思路是:写一个函数,把业务键换算成下标。学号取模、姓名编码、字符串多项式折叠,都是这类函数。查找时不再比较,而是重算一遍函数直达槽位——比较查找做 O(n) 或 O(log n) 的工作,被一次函数求值替代。
理想很满,现实有一根刺:键的可能性无穷多,槽位有限,两个不同键算出同一下标不可避免(鸽笼原理)。这一节的心法就围绕"冲突之后怎么办"展开。
链地址法与开放寻址法
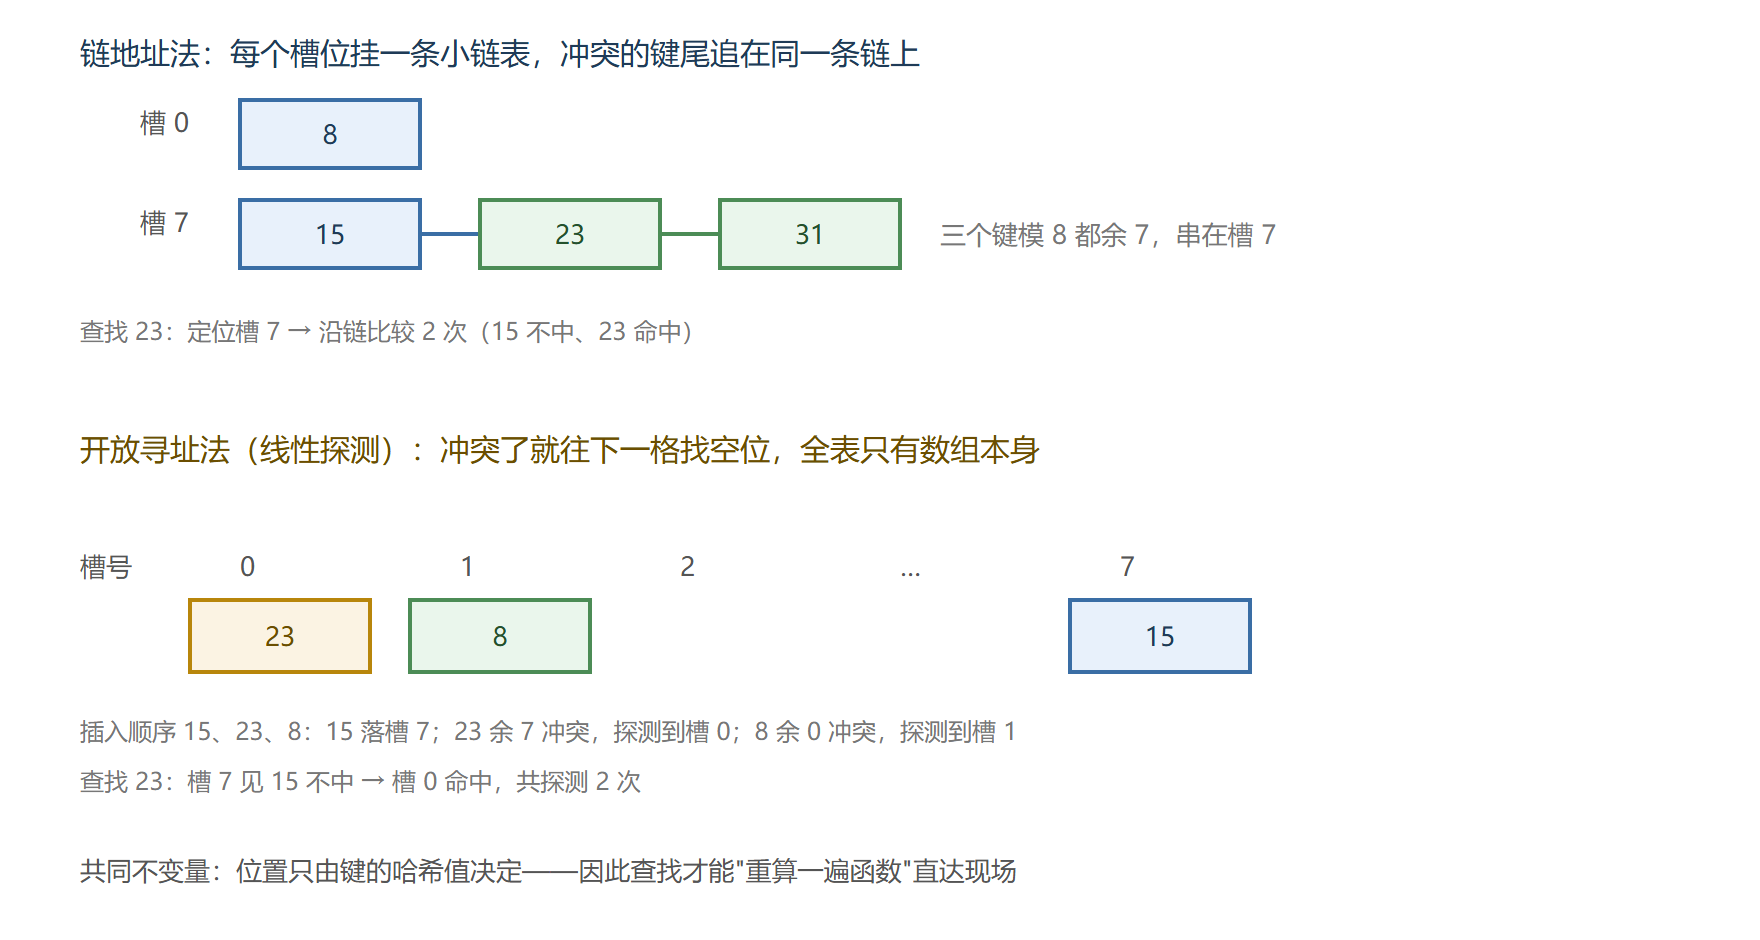
先用代码把链地址法完整走一遍,探测次数自己数:
# 链地址法哈希表:桶数组 + 冲突链 class ChainHashMap: def __init__(self, m=8): self.m = m # 槽位数 self.buckets = [[] for _ in range(m)] def h(self, key): return key % self.m # 最朴素的哈希函数:取模 def put(self, key): self.buckets[self.h(key)].append(key) def get(self, key): idx, chain = self.h(key), self.buckets[self.h(key)] probes = 1 # 第一次比较算一次探测 for k in chain: if k == key: return True, probes probes += 1 return False, probes table = ChainHashMap(8) for k in (15, 23, 8, 31): table.put(k) print(f"插入 {k}:哈希值 {k % 8} → 落桶 {k % 8}") print("桶分布:", table.buckets) # 输出: # 插入 15:哈希值 7 → 落桶 7 # 插入 23:哈希值 7 → 落桶 7 # 插入 8:哈希值 0 → 落桶 0 # 插入 31:哈希值 7 → 落桶 7 # 桶分布: [[8], [], [], [], [], [], [], [15, 23, 31]] for k in (23, 15, 31): print(f"查 {k}:", table.get(k)) # 输出: # 查 23:(True, 2) # 查 15:(True, 1) # 查 31:(True, 3) # 三个键同余 7:比较次数就是它们在链上的位次
期望复杂度怎么看:n 个元素、m 个槽位,装载因子 α 定义为 n 除以 m。哈希均匀时每条链平均长度就是 α,查找期望 O(1 + α)。α 是哈希表的心脉:把它压在常数(比如 0.75)附近,性能就有保障;α 无限膨胀,链越挂越长,退化成挂了链的数组。
开放寻址法不另开链,冲突就往后探测第一个空格。代价是"挤在一起"形成堆积:
# 线性探测法:冲突后逐格后移(用 None 表示空槽) class LinearProbingMap: def __init__(self, m=8): self.m, self.slots = m, [None] * m def put(self, key): i = key % self.m probes = 0 while self.slots[i] is not None: # 被占则后移一格(绕回用取模) i = (i + 1) % self.m probes += 1 self.slots[i] = key return probes def get(self, key): i, probes = key % self.m, 1 while self.slots[i] is not None: if self.slots[i] == key: return True, probes i = (i + 1) % self.m probes += 1 return False, probes lp = LinearProbingMap(8) for k in (15, 23, 8): print(f"插入 {k}:探测 {lp.put(k)} 次后落位,表 = {lp.slots}") # 输出: # 插入 15:探测 0 次后落位,表 = [None, None, None, None, None, None, None, 15] # 插入 23:探测 1 次后落位,表 = [23, None, None, None, None, None, None, 15] # 插入 8:探测 1 次后落位,表 = [23, 8, None, None, None, None, None, 15] print("查 23:", lp.get(23), ";查 31(不存在):", lp.get(31)) # 输出:查 23:(True, 2) ;查 31(不存在):(False, 4) # 查 31 的哈希值同为 7:15 不中、23 不中、8 不中,走到槽 2 遇空槽即断定不存在 # 探测遇空即停是不存在的判据;只有全表无空槽时才会绕满一圈
两种手段的取舍:链地址法删除简单(摘链节点)、对装载因子宽容,但要为每条链付出指针内存;开放寻址法内存紧凑、缓存友好,但删除麻烦(直接置空会截断探测链,须打"墓碑"标记),且 α 一高探测次数急剧恶化,通常 α 到 0.7 就扩容。无论哪种,扩容都是整体再散列:开双倍新表,把旧元素逐个重哈希搬过去,单次 O(n)、均摊 O(1),与动态数组扩容同理(见 1.2 均摊分析)。
| 维度 | 链地址法 | 开放寻址(线性探测) |
|---|---|---|
| 冲突处理 | 槽位挂链 | 逐格后移找空位 |
| 装载因子上限 | 可超过 1 | 须小于 1,约 0.7 扩容 |
| 删除 | 直接摘链 | 需墓碑标记 |
| 内存 | 每桶额外指针 | 紧凑、缓存友好 |
| 高负载表现 | 链渐长、缓慢劣化 | 堆积放大、急剧劣化 |
💡 关键直觉:哈希表的一切承诺都以"哈希分布均匀"为前提。函数取模、均匀分布的键是好场景;键分布有强规律(比如全部同余),再大的表也救不了。生产级实现用扰动、混合等手段把键打散,就是这个原因。
走火入魔:三起经典事故
**事故一:可变对象当键。**列表、字典、集合这类可变对象不可哈希,Python 直接抛 TypeError:把列表塞进 dict 的键,解释器当场拒绝。深一层的坑在可变类实例:若自定义哈希只算初始化字段,之后修改字段,对象还在原槽位、哈希值却变了——从此查不到它。纪律:当键的东西要么不可变,要么当键期间绝不改影响哈希的字段。
**事故二:把期望 O(1) 当保证 O(1)。**最坏情形(键全撞进一条链)查找退化为 O(n)。攻击面真实存在:构造一批刻意同槽的键灌进服务端哈希表,就能把接口拖垮(哈希碰撞拒绝服务)。对策是给哈希掺入随机种子(Python 对字符串默认启用),让攻击者无法预测落点。
**事故三:遍历时增删。**遍历字典过程中插入或删除键,行为易错(Python 会抛 RuntimeError)。正确姿势:先收集要动的键,遍历结束后统一改;或直接遍历快照副本。
本节要点回顾
- 心法:位置只由键的哈希值决定,查找是"重算一遍函数"而不是比较序列,期望 O(1);
- 冲突不可避免(鸽笼原理),链地址法挂链善后、开放寻址法逐格探测,各有删除与内存上的取舍;
- 装载因子是心脉:链法平均链长即 α;探测法 α 超 0.7 左右堆积急剧恶化,触发整体再散列(均摊 O(1));
- 三大事故:可变键、把期望当保证(碰撞攻击)、遍历时增删,全是生产环境高频翻车点;
- 数组给的是位置直达,哈希表给的是键直达——这正是它成为语言内置第一大容器的原因。
至此线性五门心法齐备。下一章把"一条线"松绑成"一棵树":每个节点不止一个后继,层次与分支带来全新的力量。