3.1 树的基本功:概念与四种遍历
3.1 树的基本功:概念与四种遍历
本节摘要:树由根唯一确定,每个节点可有多个孩子,层次与分支是它的两个新维度。二叉树限每个节点至多两个孩子;满二叉树层层填满,完全二叉树只允许最后一层靠左缺。遍历有四种法定路线:前序、中序、后序(对二叉树而言,按访问根的时机命名)与层序(队列驱动)。本节实现全部四种,并用前序加中序重建树,验证遍历的信息含量。
从一条线到一棵树
链表的每个节点只有一个后继,整条结构只有"先后"一个维度。把后继放开成多个,节点之间就形成了层级:没有双亲的叫根,没有孩子的叫叶,中间的叫内节点。一个节点的孩子数叫它的度。深度从根往下数(根深度为 0),高度从叶往上数(空树高度记 -1,单节点高度 0)。这些词不是绕口令——后面每个复杂度论证都要用它们说话。
二叉树是最受宠的特例:每个节点至多一个左孩子、一个右孩子。高度为 h 的二叉树至多容纳 2 的 h 次方减 1 个节点(每层至多翻倍),反过来,n 个节点的平衡二叉树高度约为 log₂n——对数级的全部来源就是"每层候选减半"。两个高频限定词:满二叉树每层都满;完全二叉树只有最后一层可以缺,且缺在右侧(更准确说:缺口的叶子必须靠左排)。完全二叉树是 3.4 节堆能住进数组的建筑规格。
四种遍历路线对照
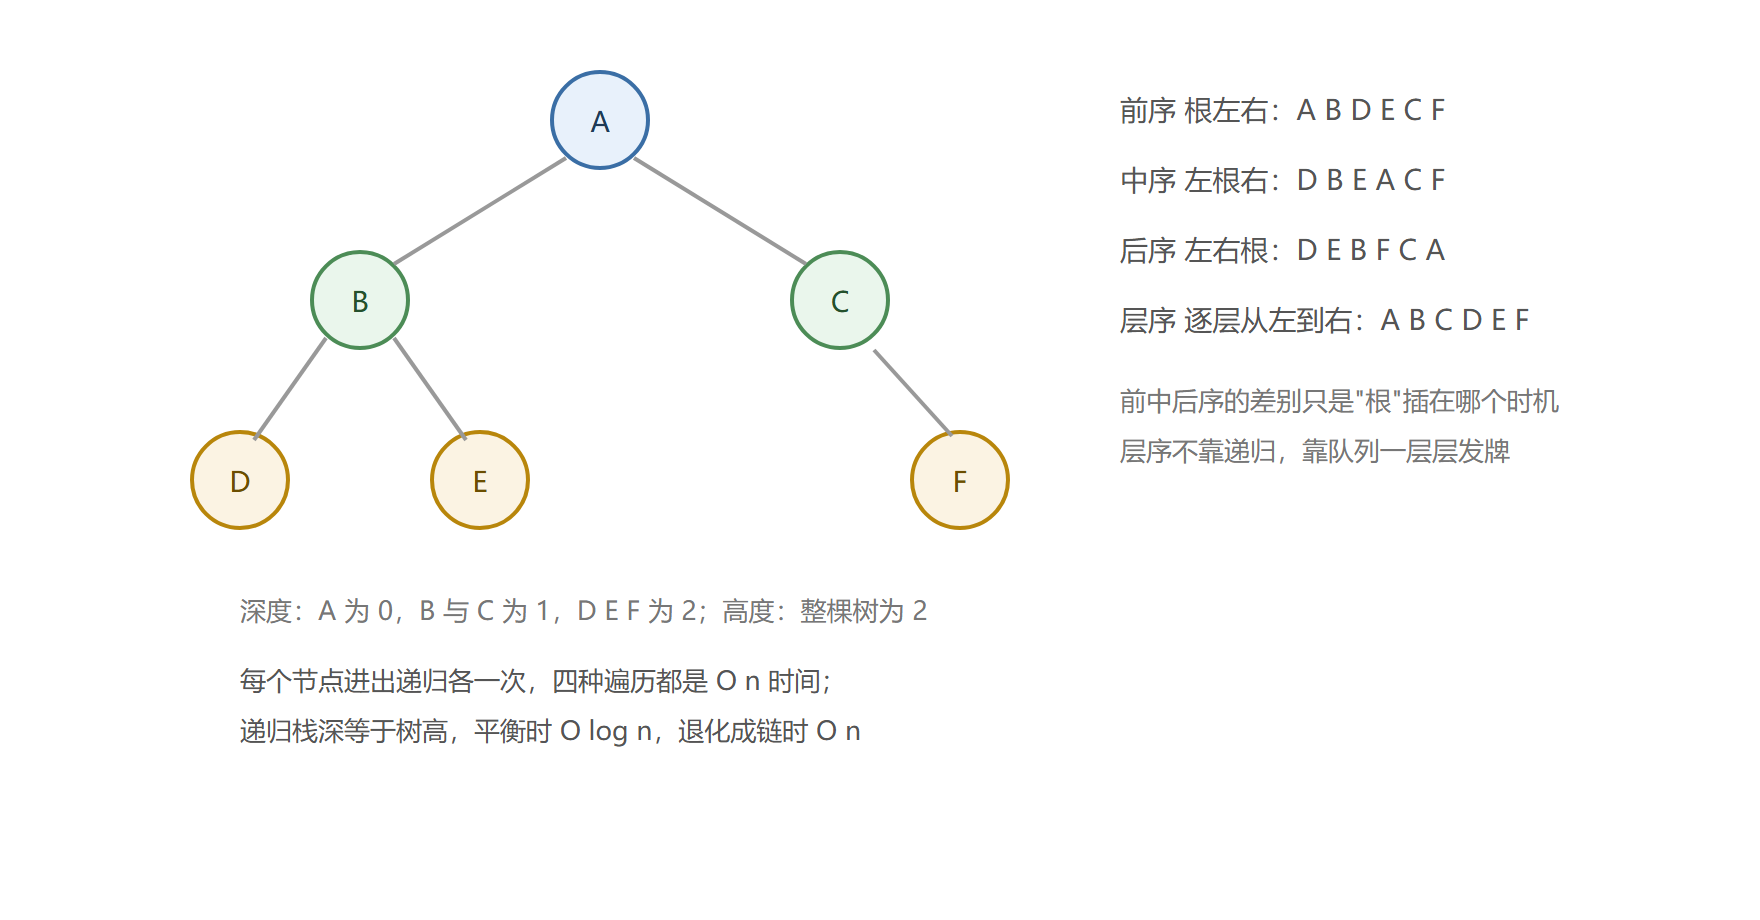
代码一次给出四种遍历,输出与上图严格一致:
# 四种遍历:递归三兄弟 + 队列层序 from collections import deque class TreeNode: def __init__(self, val, left=None, right=None): self.val, self.left, self.right = val, left, right # 手工搭出上图的树 tree = TreeNode("A", TreeNode("B", TreeNode("D"), TreeNode("E")), TreeNode("C", None, TreeNode("F"))) def preorder(node, out): # 根 → 左 → 右 if node is None: return out.append(node.val) preorder(node.left, out) preorder(node.right, out) def inorder(node, out): # 左 → 根 → 右 if node is None: return inorder(node.left, out) out.append(node.val) inorder(node.right, out) def postorder(node, out): # 左 → 右 → 根 if node is None: return postorder(node.left, out) postorder(node.right, out) out.append(node.val) def levelorder(root): out, q = [], deque([root]) # 队列:先进先出保证按层 while q: node = q.popleft() out.append(node.val) if node.left: q.append(node.left) # 先放左孩子 if node.right: q.append(node.right) # 再放右孩子 return out for name, fn in [("前序", lambda o: preorder(tree, o)), ("中序", lambda o: inorder(tree, o)), ("后序", lambda o: postorder(tree, o))]: out = [] fn(out) print(name, ":", " ".join(out)) print("层序 :", " ".join(levelorder(tree))) # 输出: # 前序 : A B D E C F # 中序 : D B E A C F # 后序 : D E B F C A # 层序 : A B C D E F
三个深度序只是"根"在递归里的时机不同;层序换成队列后,先入队的孩子先被展开,天然按层发牌——这是第二章队列心法在树上的第一次兑现。
遍历的工程对应
- 前序:进入节点先做事再下探。适合"复制树、序列化树、路径前缀累加"——父节点信息要先就位;
- 中序:对二叉搜索树恰好输出升序序列(3.2 节验证),这是"有序结构校验"的标准走法;
- 后序:先处理孩子再处理自己。适合"算子树规模、子树高度、释放树内存"——需要孩子答案的汇总;
- 层序:按距离分层。第四章 BFS 的原型,"最浅到达"问题(最短步数)全靠它。
遍历的逆问题:前序加中序重建树
遍历是树到序列的映射,逆过来信息够吗?单独一个前序不够(同前序不同形状的树存在),但前序定根、中序分左右,两者合璧刚好唯一重建:前序第一个必是根;在中序里找到根的位置,左边全是左子树成员、右边全是右子树成员;两段各自递归。
# 前序 + 中序 → 重建二叉树 def build(pre, mid): if not mid: return None root_val = pre[0] # 前序首元素定根 k = mid.index(root_val) # 中序里根的位置切分左右 left = build(pre[1:k+1], mid[:k]) # 递归重建左子树 right = build(pre[k+1:], mid[k+1:]) # 递归重建右子树 return TreeNode(root_val, left, right) pre_seq = ["A", "B", "D", "E", "C", "F"] mid_seq = ["D", "B", "E", "A", "C", "F"] recovered = build(pre_seq, mid_seq) check = [] inorder(recovered, check) # 用中序验收重建结果 print("重建后中序 :", " ".join(check)) check2 = [] preorder(recovered, check2) print("重建后前序 :", " ".join(check2)) # 输出: # 重建后中序 : D B E A C F # 重建后前序 : A B D E C F # 两个序列都还原,重建正确
每轮递归中 index 扫描花费与子树长度成正比,朴素实现总计 O(n²);用哈希表预存"值到中序下标"的映射可降到 O(n)——又是哈希表替比较买单的例子。
⚠️ 常见坑:仅凭前序加后序无法唯一重建二叉树——单孩子节点挂左挂右,两种树序列完全相同。工程序列化树时,务必带上空指针信息(或直接用前序加中序)。
走火入魔:两处高频翻车
**事故一:把"深度优先"和"前序"画等号。**递归三序本质上都是深度优先路线,差别只在取值时机;而层序是广度优先。混淆它们会导致"按层统计"类题目写出深度序的错误代码。判断标准回到需求:要分层就上队列,要沿枝深入就递归或显式栈。
**事故二:递归遍历遇链状树爆栈。**树上递归的栈深等于树高,平衡树时是 O(log n) 皆大欢喜;一旦树退化(下一节的顺序插入实验),百万节点的"树"其实是一条链,栈深百万——第一章 1.3 的爆栈在树上重演。解法一致:改显式栈的迭代遍历。
💡 关键直觉:所有树遍历的时间都是 O(n)——每个节点恰好被进出各一次。复杂度分野不在时间,在栈深与访问顺序:选遍历其实是选"父信息与孩子答案谁先就位"。
本节要点回顾
- 树的两个新维度是层次与分支;高度 h 的二叉树至多 2 的 h 次方减 1 个节点,对数复杂度源于逐层减半;
- 满与完全:满二叉树层层全满;完全二叉树只许末层右端缺——后者是堆住进数组的规格(3.4 节);
- 四种遍历:前中后序只是根的时机不同,递归栈深等于树高;层序靠队列,是第四章 BFS 的原型;
- 前序定根、中序切左右可唯一重建二叉树,前序加后序则不行(单孩子歧义);
- 工程口诀:前序做事先于下探、后序汇总孩子答案、中序对应 BST 升序、层序对应最短步数。
走法练熟,下一节给树注入第一门真本事:让中序天然有序——二叉搜索树。