4.1 图的表示:邻接矩阵与邻接表
4.1 图的表示:邻接矩阵与邻接表
本节摘要:图由顶点集 V 与边集 E 组成,方向与权重是两条正交属性。装进内存主要有两种装法:邻接矩阵用 V×V 的二维数组记录"有没有边、边多重",查边 O(1) 但空间 V²;邻接表给每个顶点挂一条邻居清单,空间 V+E、遍历邻居高效,但查单条边要扫清单。选型只看一件事:图是稠密还是稀疏。
关系网装进内存的两种装法
先把词汇表备齐。图 G = (V, E):V 是顶点集合,E 是边集合。边有方向的是有向图(关注关系,A 关注 B 不代表 B 关注 A),没方向的是无向图(道路连通)。边上带数值的是带权图(里程、运费、时延)。顶点连出的边数叫度(有向图分出度与入度)。还有一对决定选型的量:|E| 接近 |V|² 的叫稠密图,远小于的叫稀疏图——社交网络(人均几百好友,顶点数十亿)、路网(路口度数有限)都是典型稀疏图。
两种装法:
- 邻接矩阵:开一个 V 行 V 列的表格,第 i 行 j 列填 1(或边权)表示 i 到 j 有边,0(或无穷)表示没有。无向图的矩阵关于对角线对称,每条边要登记两格;
- 邻接表:每个顶点配一条清单(链表、动态数组或字典),只记自己的邻居。有向图每条边登记一次,无向图两端各登记一次。
同一张图的两种存法
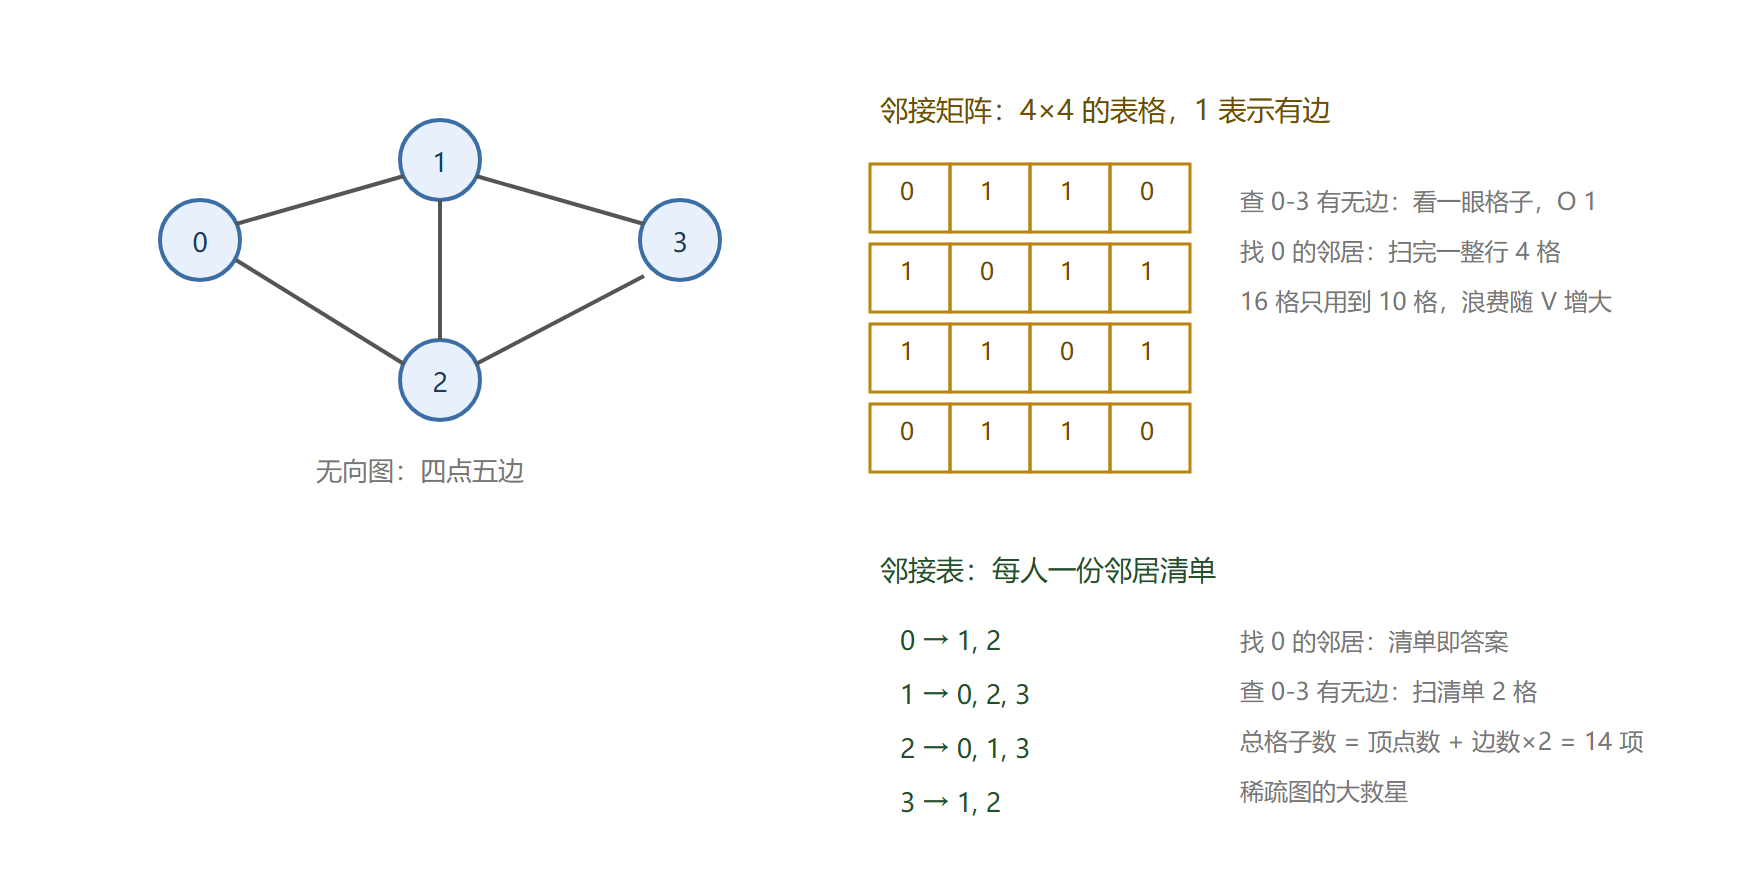
代码把同一张图按两种装法各存一遍:
# 同一张无向图的两种表示 edges = [(0, 1), (0, 2), (1, 2), (1, 3), (2, 3)] n = 4 # 装法一:邻接矩阵 matrix = [[0] * n for _ in range(n)] for u, v in edges: matrix[u][v] = 1 matrix[v][u] = 1 # 无向图:对称登记两次 # 装法二:邻接表(用列表存邻居) adj = [[] for _ in range(n)] for u, v in edges: adj[u].append(v) adj[v].append(u) for i in range(n): print(f"顶点 {i}:矩阵行 = {matrix[i]},邻接表 = {adj[i]}") # 输出: # 顶点 0:矩阵行 = [0, 1, 1, 0],邻接表 = [1, 2] # 顶点 1:矩阵行 = [1, 0, 1, 1],邻接表 = [0, 2, 3] # 顶点 2:矩阵行 = [1, 1, 0, 1],邻接表 = [0, 1, 3] # 顶点 3:矩阵行 = [0, 1, 1, 0],邻接表 = [1, 2]
两本账:查边账与空间账
两种装法的差异浓缩成两个可复算的实验。查边账:问"u 到 v 有没有边"——矩阵直接翻格子,一步;邻接表要扫 u 的清单。空间账:矩阵永远 V² 格;邻接表是无向图 2E 项加 V 条空清单。
# 查边账与空间账:顶点数 100、边数 300 的稀疏无向图 V, E = 100, 300 def matrix_has_edge(u, v): return 1 # 矩阵查边:一次下标访问,1 步 def list_has_edge(adj, u, v): steps = 0 for w in adj[u]: # 扫清单 steps += 1 if w == v: return True, steps return False, steps import random random.seed(1) adj = [[] for _ in range(V)] pairs = set() while len(pairs) < E: a, b = random.sample(range(V), 2) if (a, b) not in pairs and (b, a) not in pairs: pairs.add((a, b)) for u, v in pairs: adj[u].append(v); adj[v].append(u) u, v = next(iter(pairs)) _, steps = list_has_edge(adj, u, v) print(f"查边({u},{v}):矩阵 1 步,邻接表 {steps} 步(清单平均长度 {2*E/V:.1f})") # 输出:查边(69,56):矩阵 1 步,邻接表 1 步(清单平均长度 6.0) print(f"空间账:矩阵 {V*V} 格,邻接表 {V + 2*E} 项") # 输出:空间账:矩阵 10000 格,邻接表 700 项 # 顶点数开到十万时:矩阵百亿格直接不可行,邻接表仍是二十几万项
稀疏场景的结论一目了然:邻接表把空间从 V² 降到 V+2E,遍历每个顶点的邻居不再扫整行。反过来,图很稠密(E 接近 V²)、或者业务高频做"这条边存不存在"的点查,矩阵的 O(1) 查边与简单下标运算就更香。
| 维度 | 邻接矩阵 | 邻接表 |
|---|---|---|
| 空间 | O(V²) | O(V + E) |
| 查一条边 | O(1) | O(度数),哈希表存邻居可到 O(1) |
| 遍历一个点的邻居 | O(V)(扫整行,含大量 0) | O(度数) |
| 全图遍历(BFS/DFS) | O(V²) | O(V + E) |
| 加边 | O(1) | O(1) |
| 删边 | O(1) | O(度数) |
| 适合 | 稠密图、高频点查边、权矩阵运算 | 稀疏图、遍历主导的大图 |
带权图只是把矩阵的 1 换成权值、0 换成无穷大;邻接表把邻居清单升级成"邻居加权值"的二元组清单,其余心法不变。顺带一提度的统计账:矩阵里数一个顶点的度,要扫它那一行数出所有非零格,O(V);邻接表里度就是清单长度,直接读,O(1)。两种表示连"最普通的统计"都各有价签——这也是后面 BFS、DFS 在邻接表上跑得快的微观原因。
⚠️ 常见坑:无向图只登记一半。矩阵忘了对称那一格、邻接表只 append 一端,跑出来的"连通性"全是错的。另一个方向的反例:稀疏图用矩阵跑 BFS,遍历复杂度从 O(V+E) 涨到 O(V²)——顶点十万的路网,两者差出四个数量级。
💡 关键直觉:选型先算 E 与 V² 的比值。比值接近一(稠密)或要点查边,用矩阵;其余情况——也就是绝大多数真实网络——邻接表是默认答案。
走火入魔:把"点查快"当全部
矩阵党最常见的翻车:只看见 O(1) 查边,没看见扫行成本。图算法的主旋律是遍历邻居而非点查边——BFS、DFS、Dijkstra、Prim 全部围着"某顶点的邻居们"转。邻接表让这一步恰好等于度数,矩阵却强迫你扫完一整行(哪怕大多数格子是 0)。选型时按算法的访问模式倒推表示法,别按单点操作的下界拍板。
本节要点回顾
- 图的词汇:顶点与边、方向、权重、度;|E| 与 |V|² 的比值决定稀疏或稠密;
- 矩阵 O(V²) 空间、O(1) 查边;邻接表 O(V+E) 空间、O(度数) 访问邻居,遍历主导的大图默认选表;
- 无向图登记两次(矩阵对称两格、清单两端各一条),漏登记一半是高频事故;
- 空间账可复算:百点三百边的图,矩阵一万格对邻接表七百项,差距随规模放大;
- 带权图只是把 1 与 0 换成权值与无穷,心法不变。
表示法定了,下一节让走法登场:在有环的网络里系统走遍每个顶点——BFS 与 DFS。