4.3 最短路径:Dijkstra、Bellman-Ford 与 Floyd
4.3 最短路径:Dijkstra、Bellman-Ford 与 Floyd
本节摘要:单源最短路径的核心动作只有一个——松弛:若经由 u 到 v 比当前记录更近,就更新。Dijkstra 用堆每次取出"最近的未定型顶点"做松弛,要求边权非负,复杂度 O(E log V);Bellman-Ford 暴力松弛所有边 V-1 轮,能处理负权边并检测负环,O(VE);Floyd 用动态规划求全源最短路,O(V 立方),小图全源首选。本节逐轮跟踪三者的执行过程。
松弛:唯一的核心招式
最短路径算法都围着同一句话转:如果 dist[u] + w(u,v) < dist[v],就把 dist[v] 更新为 dist[u] + w(u,v)。这个动作叫松弛(relaxation)——把"绕远的估计"放松成"更近的事实"。三种算法的差别只是松弛的组织方式:
- Dijkstra:每次挑离源点最近的未定型顶点,松弛它的出边(贪心组织);
- Bellman-Ford:把所有边松弛 V-1 轮(暴力组织,换来负权能力);
- Floyd:按"允许经过哪些中转点"分轮松弛(动态规划组织,全源答案)。
Dijkstra 的逐轮松弛表
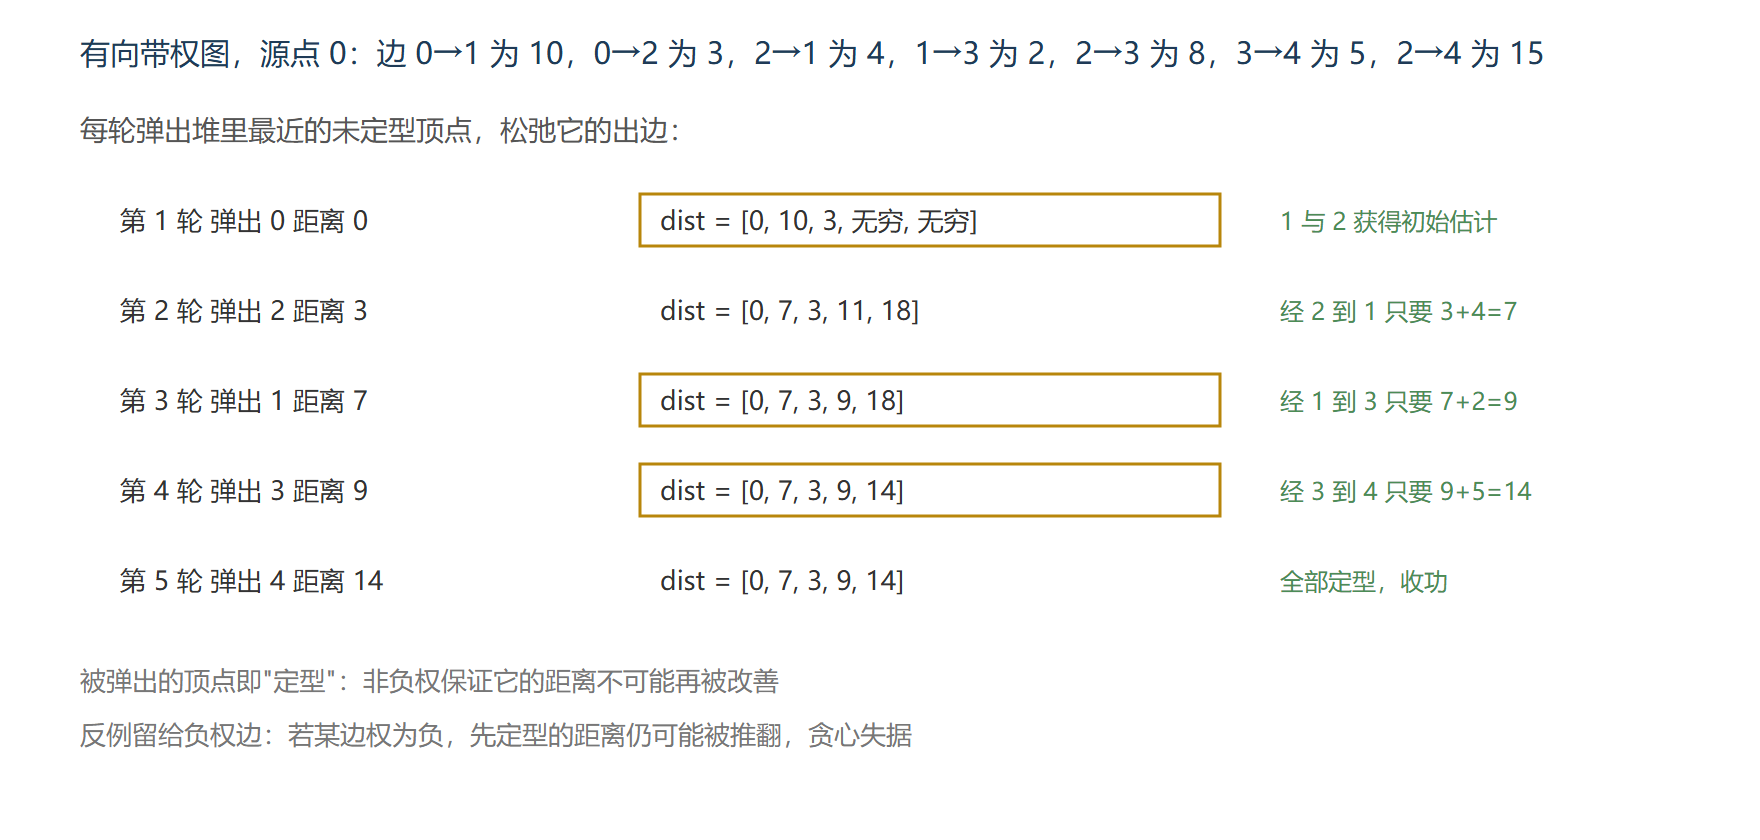
代码用堆(3.4 节 heapq)实现,松弛动作全程打印:
# Dijkstra:堆驱动的贪心松弛 import heapq def dijkstra(n, weighted_edges, src): adj = [[] for _ in range(n)] for u, v, w in weighted_edges: adj[u].append((v, w)) # 邻接表:邻居 + 权 INF = float("inf") dist = [INF] * n dist[src] = 0 done = [False] * n heap = [(0, src)] # (距离, 顶点) while heap: d, u = heapq.heappop(heap) # 取最近的未定型顶点 if done[u]: continue # 惰性删除:过期堆项跳过 done[u] = True # 定型:此距离已是最优 for v, w in adj[u]: nd = d + w if nd < dist[v]: # 松弛成功 dist[v] = nd heapq.heappush(heap, (nd, v)) print(f" 松弛 {u}→{v}:dist[{v}] 更新为 {nd}") return dist E = [(0, 1, 10), (0, 2, 3), (2, 1, 4), (1, 3, 2), (2, 3, 8), (3, 4, 5), (2, 4, 15)] print("Dijkstra 从 0 出发:") print("最终 dist =", dijkstra(5, E, 0)) # 输出: # Dijkstra 从 0 出发: # 松弛 0→1:dist[1] 更新为 10 # 松弛 0→2:dist[2] 更新为 3 # 松弛 2→1:dist[1] 更新为 7 # 松弛 2→3:dist[3] 更新为 11 # 松弛 2→4:dist[4] 更新为 18 # 松弛 1→3:dist[3] 更新为 9 # 松弛 3→4:dist[4] 更新为 14 # 最终 dist = [0, 7, 3, 9, 14]
输出顺序与上图逐轮表对应(堆弹出顺序 0、2、1、3、4)。每个顶点至多定型一次,每条边至多引起一次成功松弛,总复杂度 O(E log V)。
负权边:Dijkstra 的命门,Bellman-Ford 的主场
Dijkstra 的贪心依据是"已定型顶点的距离不会再变小"——这只在边权非负时成立。负权边一来,先定型的距离可能被后来者推翻:
# 反例:一条负权边让 Dijkstra 答错,Bellman-Ford 答对 E2 = [(0, 1, 1), (0, 2, 2), (2, 1, -2)] # 0→1 距 1;绕 2 却是 2-2=0 def dijkstra_strict(n, edges, src): # 教科书严格版:定型的顶点距离视为最终答案,不再接受更新 INF = float("inf") dist, done = [INF] * n, [False] * n dist[src] = 0 adj = [[] for _ in range(n)] for u, v, w in edges: adj[u].append((v, w)) heap = [(0, src)] while heap: d, u = heapq.heappop(heap) if done[u]: continue done[u] = True # 定型即冻结 for v, w in adj[u]: if done[v]: continue # 负权面前:更近的路线被拒之门外 if d + w < dist[v]: dist[v] = d + w heapq.heappush(heap, (d + w, v)) return dist print("Dijkstra 结果:dist =", dijkstra_strict(3, E2, 0)) # 输出:Dijkstra 结果:dist = [0, 1, 2] # 顶点 1 以距离 1 先定型,随后 2→1 的更近路线 0 已无力回天 def bellman_ford(n, edges, src): INF = float("inf") dist = [INF] * n dist[src] = 0 for rnd in range(n - 1): # 松弛 V-1 轮 changed = False for u, v, w in edges: if dist[u] + w < dist[v]: dist[v] = dist[u] + w changed = True print(f"第 {rnd + 1} 轮后 dist = {dist}") if not changed: # 提前收敛:已无更新 break for u, v, w in edges: # 第 V 轮仍能松弛 → 负环 if dist[u] + w < dist[v]: print("检测到负环,最短路不存在") return None return dist print("Bellman-Ford 结果:dist =", bellman_ford(3, E2, 0)) # 输出: # 第 1 轮后 dist = [0, 0, 2] # 第 2 轮后 dist = [0, 0, 2](本轮无更新,提前收敛退出) # Bellman-Ford 结果:dist = [0, 0, 2] # 真实最短距离 0→1 是 0:绕行 2 的负权路线被第一轮边扫描捕获
Bellman-Ford 的正确性来自一个朴素事实:最短路径至多含 V-1 条边(更多边必然重复顶点、成环,非负环只增代价),因此松弛 V-1 轮足够把所有最短距离"传播"到位;若第 V 轮还能松弛,说明存在越绕越近的负环,最短路无定义。代价是 O(VE) 的暴力账——顶点上千、边数万时已属重武器,能用 Dijkstra 就别请它。
Floyd:一张表滚出全源答案
有些问题要"任意两点间"的最短路(全源):算所有城市对的里程、传递闭包、社交网络里两两距离。Floyd 用三层循环的动态规划:中转点 k 从小到大,允许路径经过 1..k 号点,每轮用 dist[i][k] + dist[k][j] 尝试更新 dist[i][j]。
# Floyd:k 为最外层的滚动松弛 def floyd(n, edges): INF = float("inf") d = [[INF] * n for _ in range(n)] for i in range(n): d[i][i] = 0 for u, v, w in edges: d[u][v] = min(d[u][v], w) d[v][u] = min(d[v][u], w) # 无向图对称登记 for k in range(n): # 中转点必须在最外层 for i in range(n): for j in range(n): if d[i][k] + d[k][j] < d[i][j]: d[i][j] = d[i][k] + d[k][j] return d d = floyd(4, [(0, 1, 5), (1, 2, 3), (0, 3, 10), (3, 2, 1)]) for row in d: print(row) # 输出: # [0, 5, 8, 9] # [5, 0, 3, 4] # [8, 3, 0, 1] # [9, 4, 1, 0] # 验证 0→2:0→1→2 为 8,0→3→2 为 11,取 8; # 验证 0→3:直达 10,绕 0→1→2→3 为 5+3+1=9,取 9;1→3 同理 3+1=4
三层循环 O(V³),V 上千就够呛;但一次跑出全源(V² 个答案),小图上摊到"每对答案"的成本极低,且实现只有五行,判题与原型阶段极其好用。
| 算法 | 适用 | 复杂度 | 负权边 | 负环检测 |
|---|---|---|---|---|
| Dijkstra | 单源、非负权 | O(E log V) | 不允许 | 不能 |
| Bellman-Ford | 单源、可有负权 | O(VE) | 允许 | 能 |
| Floyd | 全源、可有负权(无负环) | O(V³) | 允许 | 稍加判断能 |
⚠️ 常见坑:Floyd 的循环顺序。中转点 k 必须是最外层——它对应动态规划的"阶段",写错顺序在小数据上碰巧能过、大数据必错。另一个坑:Dijkstra 堆里同顶点会有多条过期记录,弹出时必须检查 done 跳过,否则重复松弛拖慢甚至出错。
💡 关键直觉:三种算法是同一招(松弛)的三种编排。选型三问:要不要负权?要不要全源?规模多大?答案组合直接锁定上表一行。
走火入魔:把单源答案当全源用
常见事故:跑一次 Dijkstra 只得到从源点出发的答案,却被拿来回答"任意两点"的查询。方向反了的查询(从 v 到 u)在有向图上完全不等价。要么对每个查询源各跑一次,要么换 Floyd 一次买断全源。
本节要点回顾
- 松弛是唯一核心动作:dist[u] + w 小于 dist[v] 就更新;三种算法只是编排不同;
- Dijkstra 贪心组织:堆顶即最近未定型顶点,O(E log V),前提边权非负,逐轮表可复算;
- 负权边是 Dijkstra 命门:先定型的距离可能被推翻(反例 2-2=0);Bellman-Ford 松弛 V-1 轮暴力但可靠,还能检测负环;
- Floyd 动态规划组织:中转点 k 做最外层,O(V³) 换全源答案,小图全源首选;
- 堆的惰性删除:过期堆项弹出即跳过,done 标记不可省。
距离解决了,接下来换一个问题:只想把全网连通起来,最省的骨架怎么挑——最小生成树。