5.4 顺序查找与二分查找:对数级的春天
5.4 顺序查找与二分查找:对数级的春天
本节摘要:无序数据查找只能逐个扫,O(n);有序数据可以二分——每次与中点比较排除一半候选,O(log n),百万数据只需约二十次比较。二分的心法是一条循环不变量:目标若存在,必在当前闭区间内。本节跟踪二分的每一步探测,实现左边界变体,并展示"二分答案"的思想迁移。收束第二章数组与本章排序的全部铺垫。
无序的世界只有一条路
第二章 2.1 节说过:无序数组按值查找是 O(n),从 Head 扫到尾,没有捷径——乱序本身就是信息缺失,任何跳着查的企图都可能漏掉目标。要么接受线性扫,要么先付出排序的代价(一次性 O(n log n),之后每次查找 O(log n)),要么用 2.5 节的哈希表按关键字直达。三条路的账,在查找需求出现第二次时就该重新算。
数据一旦有序(本章前几节的产出),游戏规则彻底改变:中点一比,半壁江山出局。
二分查找:区间的三次收缩
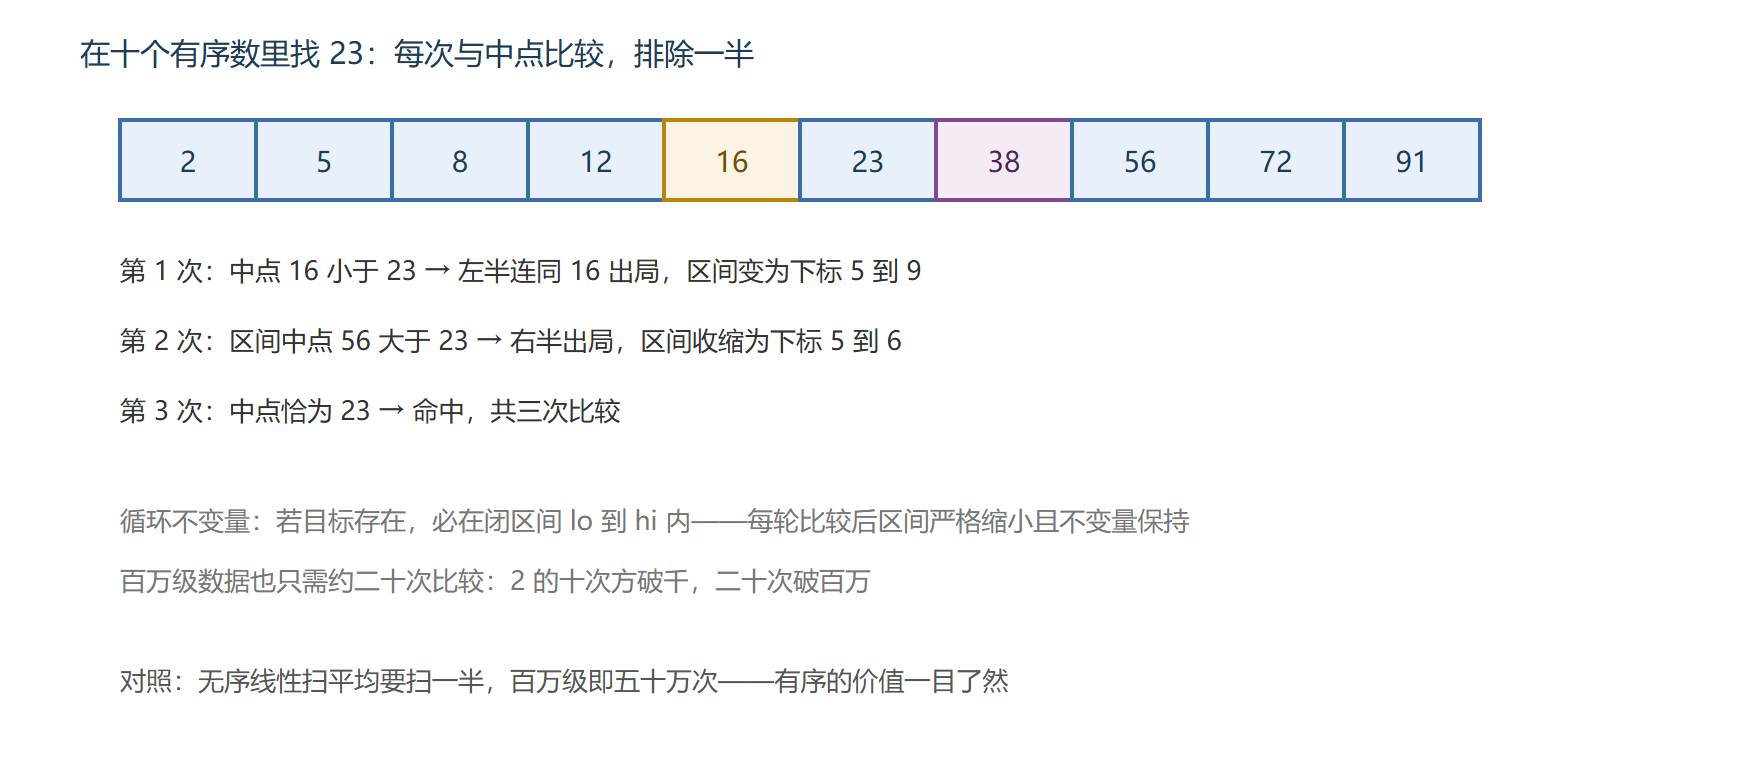
# 线性扫 vs 二分:比较次数对决 + 二分全程跟踪 def linear_search(a, target): steps = 0 for i, x in enumerate(a): steps += 1 if x == target: return i, steps return -1, steps def binary_search(a, target): lo, hi = 0, len(a) - 1 # 闭区间 probes = [] while lo <= hi: mid = (lo + hi) // 2 probes.append(a[mid]) if a[mid] == target: return mid, probes if a[mid] < target: lo = mid + 1 # 中点及其左侧全部出局 else: hi = mid - 1 # 中点及其右侧全部出局 return -1, probes a = [2, 5, 8, 12, 16, 23, 38, 56, 72, 91] idx_lin, steps_lin = linear_search(a, 23) idx_bin, probes = binary_search(a, 23) print(f"线性扫:下标 {idx_lin},比较 {steps_lin} 次") print(f"二分:下标 {idx_bin},探测序列 {probes}") # 输出: # 线性扫:下标 5,比较 6 次 # 二分:下标 5,探测序列 [16, 56, 23] # 三个探测点与上图三次收缩一一对应 big = list(range(1000000)) _, s1 = linear_search(big, 777777) _, probes_big = binary_search(big, 777777) s2 = len(probes_big) print(f"百万数据找 777777:线性 {s1} 次,二分 {s2} 次") # 输出:百万数据找 777777:线性 777778 次,二分 20 次 # 2 的二十次方已过百万:无论目标在哪,二分的探测次数都被压在这个量级
二分正确性的全部秘密是一条循环不变量:进入每轮循环时,若目标存在则必在闭区间 [lo, hi] 内。中点比较后区间严格缩小且不变量保持,循环必终止;终止时区间为空,即目标不存在。把这条不变量说清楚,边界写法(lo <= hi、mid±1)就不再是背诵题。
左边界变体:重复元素的第一次出现
数组里有重复元素时,"找到一个"往往不够,业务常问第一个出现位置(或最后一个)。左边界二分在相等时不停手,继续向左压缩:
# 左边界二分:目标首次出现的下标(不存在则返回应插入位置) def lower_bound(a, target): lo, hi = 0, len(a) # 左闭右开 while lo < hi: mid = (lo + hi) // 2 if a[mid] < target: lo = mid + 1 # mid 及左侧不可能藏着"首个不小于 target" else: hi = mid # a[mid] 大于等于 target:mid 仍可能就是答案 return lo dup = [1, 3, 3, 3, 5, 7] for t in (3, 4, 8): print(f"目标 {t}:lower_bound = {lower_bound(dup, t)}") # 输出: # 目标 3:lower_bound = 1 (三个 3 的第一个) # 目标 4:lower_bound = 4 (不存在,返回插入位置——4 应插在 5 之前) # 目标 8:lower_bound = 6 (超出全体,插到末尾)
左闭右开写法(hi 初值取 len)配合 hi = mid,天然避免死循环;返回值同时是"首个不小于目标的位置",一鱼两吃。语言的二分库函数(如 C++ 的 lower_bound、Python 的 bisect 模块)都是这个语义。
⚠️ 常见坑:Java 里
(lo + hi) / 2溢出。int 上限约二十一亿,两个十亿级的下标相加先溢出再除二,得到负数下标直接越界。工程写法是mid = lo + (hi - lo) / 2。Python 整数无限精度没有此坑,但写出跨语言可移植的代码是职业习惯。
💡 关键直觉:二分查找的本质不是"找数",而是"每轮用一个判定把候选空间砍半"。谁提供有序性(数组、答案区间、函数单调性),二分就能在哪里开张。
思想迁移:二分答案
判定与求解可以倒转:如果"条件是否满足"随某个量单调变化,那么满足条件的最小(或最大)量可以二分搜出来——在答案区间上二分,每次用一次判定代替比较。求平方根整数部分是最小样例:
# 二分答案:求 n 的平方根整数部分(判定:x 的平方不超过 n) def int_sqrt(n): lo, hi = 0, n while lo < hi: mid = (lo + hi + 1) // 2 # 向上取整防死循环 if mid * mid <= n: # 判定:mid 还能更大吗 lo = mid else: hi = mid - 1 return lo for n in (50, 99, 100): print(f"根号 {n} 的整数部分 = {int_sqrt(n)}") # 输出: # 根号 50 的整数部分 = 7 # 根号 99 的整数部分 = 9 # 根号 100 的整数部分 = 10
同一套心法解决"最小的载重能否按时运完""最大的最小间距"这类单调判定题——它们的解空间天然有序,二分照砍不误。
走火入魔:两起二分事故
**事故一:死循环。**左边界二分写 hi = mid 却让 mid 向下取整,当区间剩两个元素且判定走 else 分支时,mid 永远等于 lo、区间不再缩小——死循环。纪律:hi = mid 配左闭右开与向下取整;lo = mid 配向上取整(如上面 int_sqrt 的 +1)。写完先在两元素区间上手推一遍。
**事故二:忘了前提是有序。**对无序数组跑二分,返回 -1 或错误下标但毫无报警——结果"看起来合理",错得悄无声息。二分的前提是第二章到第五章辛苦建立的有序性;数据源不保证有序时,先排序或换哈希表。
本节要点回顾
- 无序只能扫 O(n),有序才能二分 O(log n);有序性的价值在查找需求第二次出现时兑现;
- 循环不变量:目标若存在必在 [lo, hi]——它是边界写法的证明,不是口诀;
- 左边界变体返回首个不小于目标的位置,左闭右开加 hi = mid 防死循环,与语言库函数同语义;
- 二分答案把判定单调的问题搬进二分框架,判定代替比较,解空间当查找空间;
- 两个纪律:Java 中点先减后加防溢出;两元素区间上手推防死循环。
排序与查找收功。下一章把散落各章的"套路"提纯成方法论:分治、动态规划、贪心、回溯、分支限界。