7.3 字符串匹配:KMP 与 Rabin-Karp
7.3 字符串匹配:KMP 与 Rabin-Karp
本节摘要:在长度 n 的文本里找长度 m 的模式串,朴素逐位试最坏 O(n·m)。KMP 用失配数组(前缀函数)记住"已匹配部分的前缀信息",失配时模式串滑移而文本指针永不回退,O(n+m);Rabin-Karp 把子串哈希成一个数,滚动更新 O(1) 算出每个窗口的哈希,哈希相等再逐字确认。一个不回头的内功,一个以数代串的外功。
朴素匹配慢在哪:一有失配就全部重来
朴素匹配把模式串对齐文本的每个起点,逐字符比较;一旦失配,文本指针退回、模式串右移一格、从头再比。浪费在于已匹配的那些字符信息被整个扔掉——明明知道刚刚对齐过的这段长什么样,下次还要重新看一遍。最坏情形(文本 AAAA…、模式 AAB 类)每次都匹配到最后一位才失配,总量 O(n·m)。
# 朴素匹配:对齐每个起点逐字比较,计数暴露浪费 def naive_match(text, pat): n, m = len(text), len(pat) cmp = 0 for i in range(n - m + 1): j = 0 while j < m: cmp += 1 if text[i + j] != pat[j]: break # 失配:整段信息作废,右移重来 j += 1 if j == m: return i, cmp return -1, cmp text, pat = "ABABABC", "ABABC" pos, cmp = naive_match(text, pat) print(f"朴素:命中位置 {pos},比较 {cmp} 次") # 输出:朴素:命中位置 2,比较 11 次 # 前两个起点各匹配多步后失配,挣到的信息全部丢弃
KMP:失配数组让文本指针永不回头
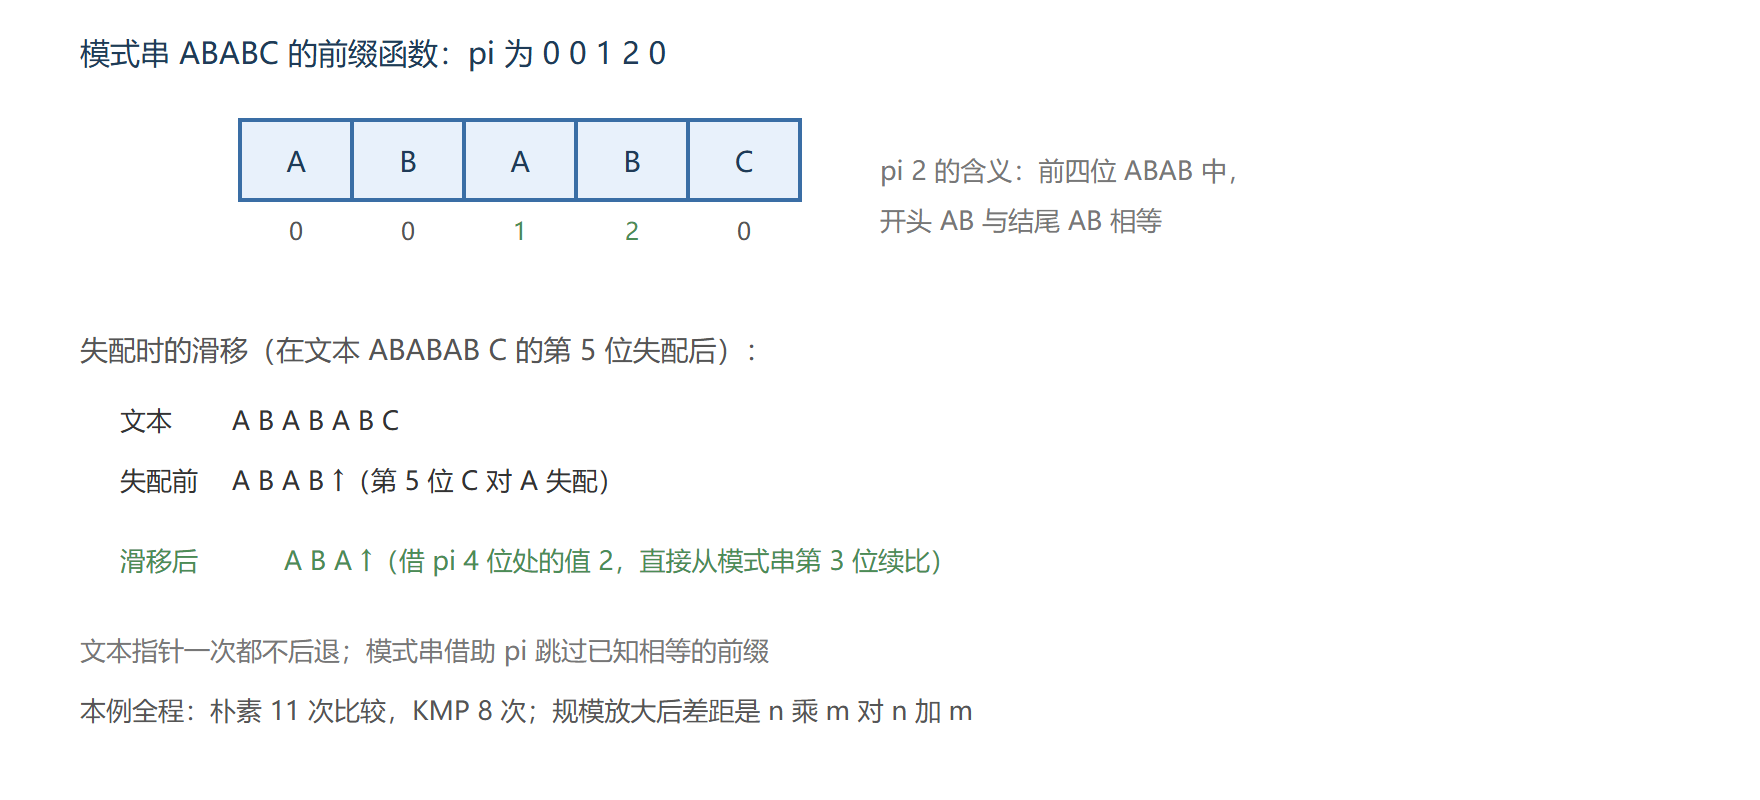
KMP 的核心洞察:失配时,已匹配的那段模式串前缀里,可能藏着"自己的开头"。模式串 ABABC 匹配到 ABAB 后失配,已匹配段 ABAB 的最长相等前后缀是 AB——把模式串滑到让这个 AB 对齐文本刚匹配过的 AB,比较从模式串第 3 位继续,前两位不用重比。
前缀函数 pi(也叫 next 数组)逐位记录"到此为止的最长相等前后缀长度":ABABC 的 pi 为 0、0、1、2、0——前两个字符没有非平凡前后缀;ABA 有 A;ABAB 有 AB;ABABC 没有更长的相等前后缀。
失配数组的含义与滑移动作
# KMP:前缀函数 + 匹配主循环 def prefix_function(pat): m = len(pat) pi = [0] * m k = 0 # 当前最长相等前后缀长度 for q in range(1, m): while k > 0 and pat[k] != pat[q]: # 失配:沿 pi 链回退 k = pi[k - 1] if pat[k] == pat[q]: k += 1 pi[q] = k return pi def kmp_match(text, pat): n, m = len(text), len(pat) pi = prefix_function(pat) print("前缀函数:", pi) cmp, k = 0, 0 for q in range(n): # 文本指针 q 只前进 while k > 0 and pat[k] != text[q]: cmp += 1 k = pi[k - 1] # 模式串滑移,不重比 cmp += 1 if pat[k] == text[q]: k += 1 if k == m: # 完整匹配 return q - m + 1, cmp return -1, cmp pos, cmp = kmp_match(text, pat) print(f"KMP:命中位置 {pos},比较 {cmp} 次") # 输出: # 前缀函数: [0, 0, 1, 2, 0] # KMP:命中位置 2,比较 8 次 # 与朴素 11 次相比省下的,正是滑移跳过的重复比较;文本指针全程未回退
复杂度账:构建 pi 是 O(m)(k 的总增幅与总回退都不超过 m),匹配主循环 O(n)(同理摊还),合计 O(n + m)——与模式串长度几乎无关的线性扫描。
Rabin-Karp:把子串压成一个数来比
另一条路:与其逐字比较,不如给每个长度 m 的窗口算一个哈希值,只比较哈希。妙处在滚动更新:窗口右移一格,新哈希 = (旧哈希 − 移出字符 × base 的 m-1 次方) × base + 移入字符,一次乘加搞定,不必重算整个窗口。
# Rabin-Karp:滚动哈希 + 命中后二次确认 BASE, MOD = 256, 1_000_000_007 # 基数与模数(大素数防碰撞) def hash_of(s): v = 0 for ch in s: v = (v * BASE + ord(ch)) % MOD # 多项式哈希 return v def rabin_karp(text, pat): n, m = len(text), len(pat) target = hash_of(pat) win = hash_of(text[:m]) # 首个窗口 powm = pow(BASE, m - 1, MOD) # 预算 base 的 m-1 次方(模下) hits = [] for i in range(n - m + 1): if win == target: # 哈希相等:大概率命中 if text[i:i + m] == pat: # 二次确认:防哈希碰撞 hits.append(i) if i + m < n: # 滚动:去头加尾 win = ((win - ord(text[i]) * powm) * BASE + ord(text[i + m])) % MOD return hits print("RK 命中:", rabin_karp("ABABABC", "ABABC")) # 输出:RK 命中: [2] print("RK 再来一例:", rabin_karp("AAAAAB", "AAB")) # 输出:RK 再来一例: [3] # 窗口逐一滚动,每个窗口哈希 O 1 更新,命中一次逐字确认
期望复杂度 O(n + m);若哈希设计不佳导致大量伪命中(哈希相等但串不同),退化为 O(n·m)。二次确认那一步不能省——哈希相等只是"大概率相同",直接信哈希就是把自己的正确性交给运气(2.5 节哈希碰撞的老教训)。
| 维度 | KMP | Rabin-Karp |
|---|---|---|
| 复杂度 | 最坏 O(n+m) | 期望 O(n+m),哈希差则退化 |
| 预处理 | 前缀函数 O(m) | 无(首窗口 O(m)) |
| 多模式匹配 | 需 AC 自动机 | 天然擅长(各模式算各哈希) |
| 二维/指纹搜索 | 不便 | 擅长( plagiaris 检测同款思路) |
| 实现难度 | pi 链回退稍绕 | 滚动式直白,注意取模 |
⚠️ 常见坑:Rabin-Karp 的取模运算。负数参与模运算的语言(如 C、Java)里,"旧哈希减去移出项"可能变负,要先加回一个模再取模;Python 的百分号对负数也返回非负,但跨语言移植时务必自查。
💡 关键直觉:KMP 的失配数组本质是"提前替模式串做好自我认知"——它知道自己每个前缀与自己的后缀有多少重合,失配时据此滑移。3.5 节 AC 自动机把这个自我认知扩展到多模式与字典,思想一脉相承。
走火入魔:两起匹配事故
**事故一:拿到文本就上 KMP。**单次查找、文本不长时,语言内置的 find 与朴素实现已是常数最优;KMP 的收益要在"同一模式反复匹配"或"文本巨大"时才兑现。兵器按场景出鞘。
**事故二:多模式匹配逐个跑 RK。**上千个模式串就跑上千遍文本。正解是把模式串建成 3.5 节的 Trie 并加载失配指针(AC 自动机),一趟文本扫描同时匹配全部模式——敏感词过滤系统的标准架构。
本节要点回顾
- 朴素匹配的浪费在于失配即弃全部已匹配信息,最坏 O(n·m)(实例十一与八次比较的差距可复算);
- KMP 心法:前缀函数记录"每个前缀的最长相等前后缀",失配时滑移续比,文本指针永不回退,O(n+m);
- Rabin-Karp 心法:滚动哈希一次乘加换掉 m 次字符比较,命中后必须二次确认防碰撞;
- 选型:单次短查用内置;大文本单模式用 KMP;多模式上 AC 自动机;查重与指纹用 RK 思想;
- 取模负数是跨语言移植的高频雷区。
最后一节潜入最底层:整数即开关,位运算的暗劲。