3.4 传输层协议与可靠性
3.4 传输层协议与可靠性
本节摘要:无线信道丢包常见,传输层负责"到底可不可靠、谁负责重传"。本节先讲传统 TCP 为什么在 WSN 里"水土不服",再给轻量替代思路——部分可靠、轻量重传、把可靠性上提到应用层或跨层协作,最后用一个数据上报的可靠性对比表收尾。
路由把数据往基站方向带,但中间站在无线的坑坑洼洼里穿行,包丢了怎么办?这就轮到传输层自问"可靠性谁来扛"。
可靠性这道题,传统 TCP 为什么交白卷
TCP 靠"三次握手、序号确认、超时重传、拥塞控制"保证端到端可靠。这套机制在有线、稳定、能量充沛的网络里很有效,在 WSN 里却四处碰壁:
- 开销太贵:TCP 头较大,每包都要确认,重传又额外烧一次发射。传感数据本来就小,TCP 的头和确认开销占比很高。
- 与占空比冲突:TCP 超时计时假设网络较快,而 WSN 节点睡了醒、醒了睡的时延让它不断误判"丢失"而错误重传,反而更费电。
- 只有"全有或全无":很多 WSN 应用其实容得下轻微丢包(环境趋势少一个读数没大碍),TCP 却不分轻重一律重传给足。
所以 WSN 大多不指望完整 TCP,而是走"够用即可"的轻量可靠。
轻量可靠性的几招:这笔账怎么省着保
部分可靠(partial reliability):完全可按应用约定"这个包必须到,那个包可以丢"。趋势数据丢一两帧没关系,报警帧必须稳。按需分级,比一刀切的可靠更省。
轻量重传(local retransmission):不在端到端做全套确认,而在链路/本地做快速重传——丢了就这一段补发,避免端到端的来回等待与整站重发。本地补救往往比"全路重传"便宜得多。
重传上提到应用层:把可靠性责任递给最懂业务的地方,由应用决定"这个消息值不值得再花一次发射"。
跨层设计(cross-layer):传输层与 MAC/网络层共享信息。例如知道链路很差,就提前调整重传策略,而不是等传输层一次次超时。
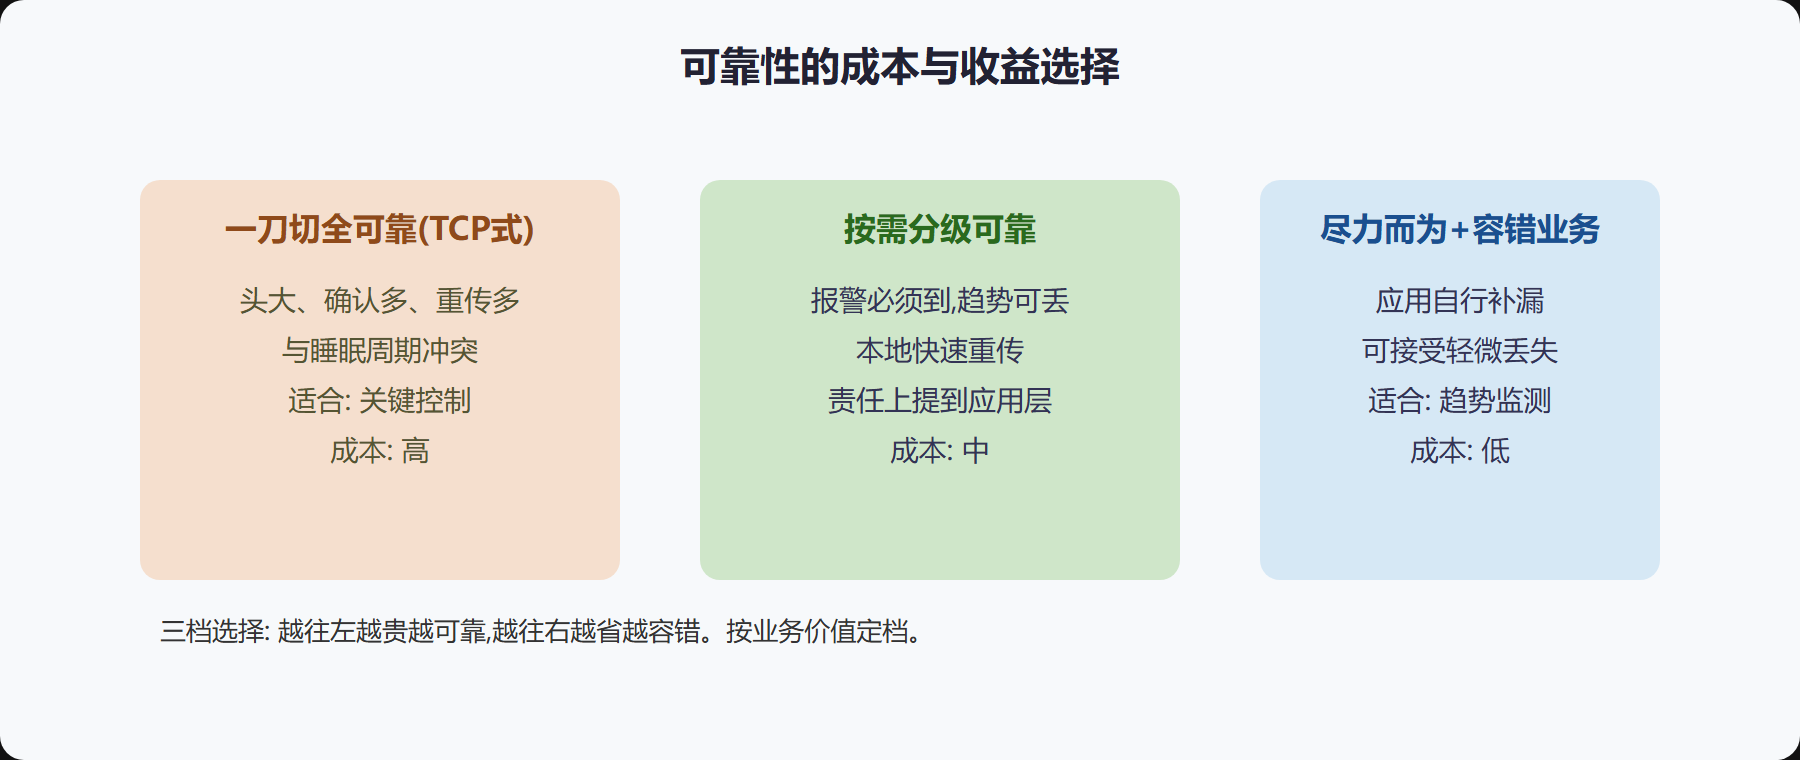
图标题:可靠性按需分级的三档选择
没有万能答案,重点是"不同数据给不同可靠等级",把有限的能量花在真正值得的报文上。
一个具体案例:把重传花在刀口上
设一套森林烟感网络:平时温湿度与烟雾浓度趋势值,多跳回传,偶尔在链路抖动中丢一两帧——趋势图有点小缺口完全可以接受,不值得为它反复重传。可一旦出现"烟雾超阈值"这类的关键报警,就必须保证送达。做法是:普通读数走"尽力而为",报警计算多跳复核 + 必要时重传。这个"分级"最终让整个网络在满足安全前提下,把能量花在关键处,而非为几帧趋势数据挥霍宝贵的电池。
💡 关键直觉:可靠不是"有或无",而是"值不值得重传这一次"。用业务价值给报文划档,是 WSN 传输设计的心法。
端到端 vs 逐跳重传:谁更划算
"在哪一层负责重传"决定了一笔账单的大小。两条路线算个粗略账:
端到端重传: 源到目标全程只认一次, 中间任一段丢整体重来 → 常常白走一大段路 逐跳/本地重传: 中间每一段丢了就在本段补发 → 补救范围小, 一般更省、更快 代价: 逐跳需要中间节点能缓存与短时重发, 略微多点局部状态
多数多跳 WSN 偏向"本地补救",因为它避免了"最后一段才暴露失败却从头重传"的灾难性浪费。不过这也有取舍——逐跳要每个中继都"背一小笔缓存与状态账",网络层维护成本上升。真正稳妥的做法是视链路质量灵活切换:链路稳时端到端够用,链路烂时逐跳接管,让两种方式互为兜底。
拥塞:另一笔被忽略的重复账
传输层常顺带处理拥塞。当上报方向集中、一段时间内大家都往上涌,中间的汇聚点会被"水泄不通"。拥塞不像丢包那样"静悄悄",它会引发强烈的重传与排队,账单瞬间暴涨:
拥塞前兆: 缓冲区堆积、时延爬升、大量重传 轻处理: 退避、降上报频率(节流) 重处理: 丢出低优先级包、加快丢弃次要数据保关键数据
关键是别等到"堆满再炸"。能早一点按数据重要级做取舍,能避免连锁的重传风暴。这也再次回到"分级":拥堵时先保最关键的那几条, 而不是平均用力互相拖死。
应用层如何定可靠等级:一张对账
把"该不该可靠"的决定权交回业务,落地成一张表,工程上最顺手:
| 数据类型 | 可接受丢失 | 该不该重传 | 理由 |
|---|---|---|---|
| 环境趋势读数 | 可丢一两帧 | 不必 | 冗余高、重传不值 |
| 关键报警 | 必须到 | 一定重传 | 错过就可能出事 |
| 参数下发/固件 | 必须到 | 可靠+校验 | 错一点就出错 |
| 低电量救助信号 | 尽量 | 在能力内 | 保命优先 |
这张表的核心就一句:"花多少电保可靠"由"数据多重要"说了算。 设计传输策略前,先问应用"哪类包值得多花一次发射",答案往往比任何算法都省钱。
一条贯穿的直觉:可靠是"分级"出来的
把本节揉成一句可以随身带走的话:WSN 的可靠不是"要不要保证",而是"哪一类数据值得为它多花一次发射"。 TCP 之所以吃瘪,是因为它对所有包一视同仁地重传;WSN 的聪明之处在于先问"这包丢了要不要紧",再决定费多大的劲去保。做到这一点,传输层就同时把"可靠"和"省电"都握在手里了。以后设计任何上报机制,第一件事就是给数据按价值分档——分好了,传输层怎么取舍自然就有了答案。
丢包率也是可谈的:先定个"损耗额度"再做方案
可靠分级若只停在"哪类保、哪类丢"的话头上,工程上仍无从量起。更实用的做法是给每条数据流设一个可容忍的丢失率额度,用这张尺子去选方案。刚联网时链路不错,额度可以定严一点;设备老化、树林遮挡加重后,把"值得重传"的档位悄悄放宽,比死守一个一成不变的质量目标更扛得住实际。
趋势流: 容忍 5–10% 丢失, 不必重传 报警流: 容忍 0, 必须多跳复核 + 可靠重传 参数流: 容忍 0, 且要校验, 错一位就废止 额度会变: 链路随季节/遮挡波动, 定期重估再调档
把"丢多少能忍"先谈出来,传输层的每一档策略就都有了落点。否则光喊"要可靠"无从下手;有了额度,要不要重传、重传几次、要不要提前跨层告警,全部有了明确依据。可靠工程常常不是第一步选协议,而是先给每条数据标好一件"损耗额度"。
本节要点回顾
- TCP 为何不行:头大、确认多、与睡眠周期冲突、不区分轻重。
- 按需分级:关键帧稳、趋势帧可丢。
- 本地重传:丢了这一段补这一段,避免整站重发。
- 上提应用层:最懂业务的地方决定重不加。
- 跨层协作:与 MAC/网络层共享链路信息来调重传。
传输把"能不能到"夯实后,还差顶层的地图——应用层决定"要什么数据、何时取、取多少"。下一节看应用层协议。