4.2 数据融合与聚合
4.2 数据融合与聚合
本节摘要:高密度部署让相邻节点读到大量高度相似的读数,若全原样回传,必然浪费带宽又在烧通信电。数据融合与聚合在传输途中把多份算成一份代表值,核心是"少传一个代表值"。本节讲清融合与聚合的区别、能省多少、原理与风险,并给出一段聚合示例输入输出。
上一节提到数据融合是降低传输能耗的重拳。这一节把它讲透。
为什么会有海量冗余
上千个节点密集监测一片区域,相邻节点的读数天然高度相关——同一片农田的温度、同一面墙的光照,彼此差不了多少。若每个节点都把原始值各传一份到基站,基站收到的就是一大坨冗余数字,既堵信道又烧发射电。问题的根源不是"数据不够多",而是"数据太多相似"。
融合 vs 聚合:两个容易混淆的词
- 数据融合(Fusion):把多源异构的原始数据在某个节点/服务器上组合出更高层的信息,比如"综合多个读数判断是否为真事件"。
- 数据聚合(Aggregation):专门指在传输路径上,把多份数据合成更小的一批再继续传,比如把 10 个温度取平均值、最大值,只传一个值或一段摘要。
实操中,融合是"算得更聪明",聚合是"传得更省"。在传输节能语境里,我们最关心的是聚合。
聚合能省多少:一个直观的数字对比
假设一个簇有 10 个节点,各自一个温度读数:
不聚合: 10 条报文, 每条带回完整读数 → 网络与基站要消化 10 份 簇内聚合: 簇头取 平均值/最大/最小 → 只向基站传 1 条摘要 传输量: 可降到原来的 1/10 甚至更低(取决于怎么聚) 代价: 你拿不到每个原始读数, 只拿到摘要 —— 信息粒度的取舍
这笔账非常划算:10 份变 1 份,通信能耗近乎按同比例下降,代价只是"不再保留每个原始点"。对"趋势分析""有没有越界"这类需求完全够用。
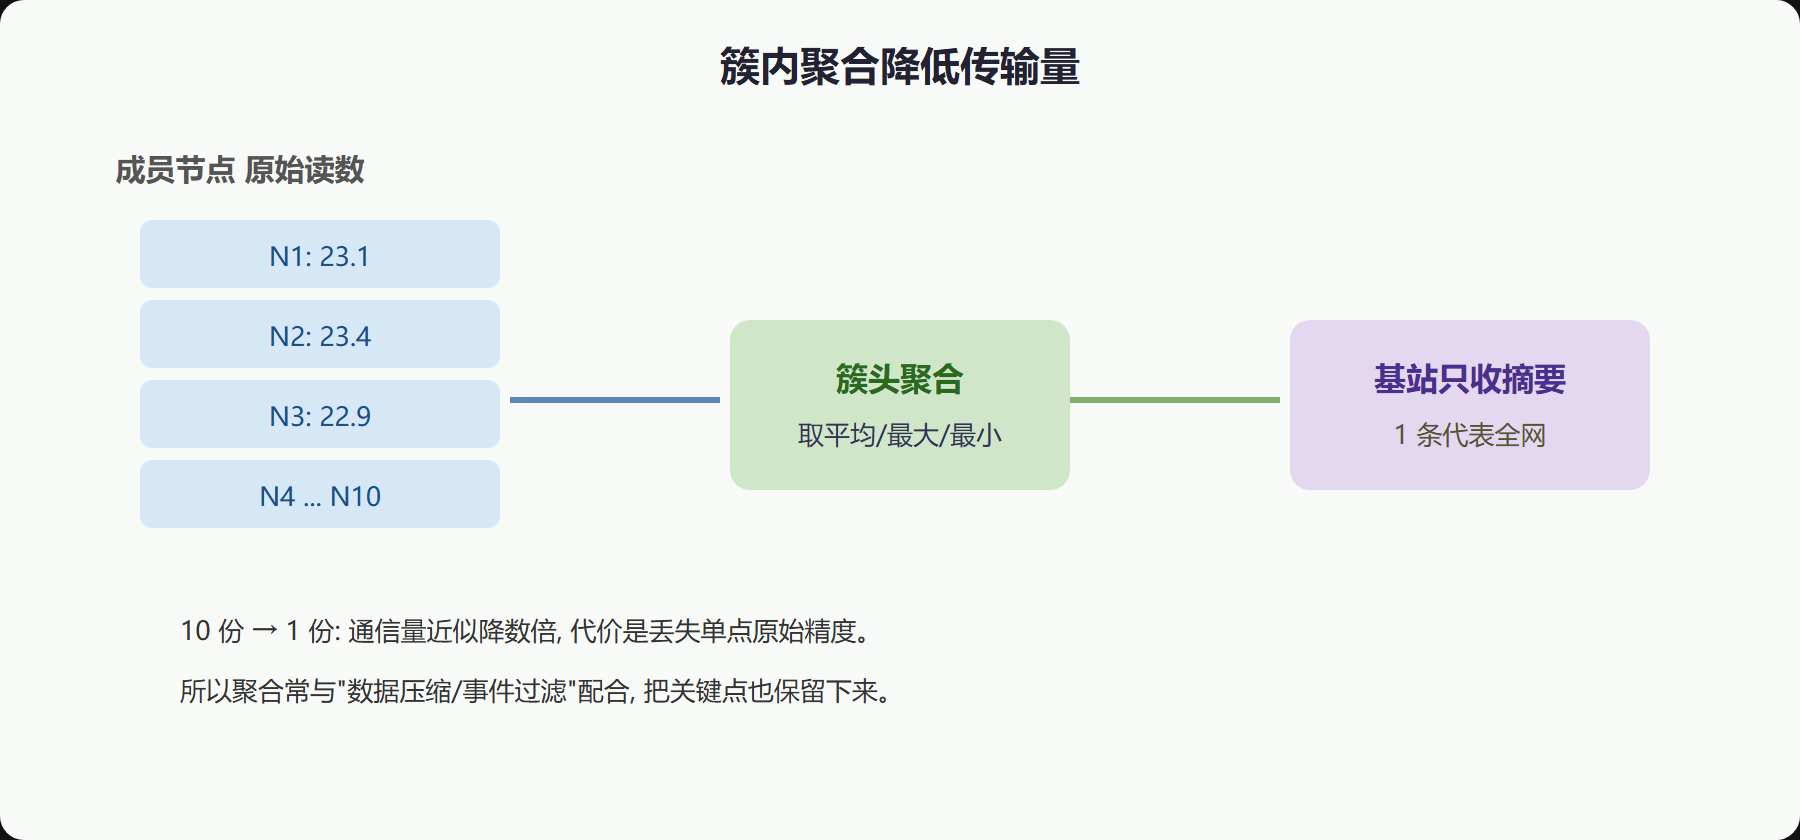
图标题:簇内聚合将多份读数压成一条摘要
读图要点:聚合并非"无脑取一",而是在"大幅降传输"与"保留足够信息"之间找一个业务能接受的点。常见策略是同时上报"均值 + 最值",既看趋势又保极端。
聚合的代价与风险
聚合不是零成本。三个要警惕的点:
- 信息粒度变粗:摘要丢掉了单点细节。若某些节点曾经出现过异常而平均值把它们"抹平"了,就可能漏报。要有配套的异常值保留策略。
- 安全问题:若某条链路/簇头被劫持,伪造的摘要可以一次污染一整簇的结论。聚合反而放大了单点攻击的影响(见 4.5)。
- 计算与协同:聚合要多一跳的本地计算与协调,若簇太小、数据本就不同源,聚合的收益会被开销吃掉。
一个具体案例:温度网的聚合参数
一片温室,20 个节点测温,簇内有 5 个节点。簇头策略:每 5 分钟收到簇内 5 个读数,计算"均值"与"最高/最低",连同时间戳合成一条报文发给网关;同时记录"是否有一路超出告警阈值"作为标志位优先上报。这样网关每 5 分钟只处理 1 条摘要而非 5 条 ×20 簇,网络负载与能耗都大幅下降,还保住了"有没有越界"这个农业最关心的点。
💡 关键直觉:聚合的本质是"用更粗的信息粒度换更省的传输"。想清楚"哪些细节值得保留、哪些可以牺牲",聚合就敢放心用。
聚合放在哪:位置决定省多少
聚合的位置不同,节省的量也不同。越靠近数据源聚合,省下的中继与发射越多,但也更早丢失细节;越靠基站聚合,保留细节越多,可省电越少:
节点本地: 就近聚合 → 省最多中继, 但每个点都只剩摘要 簇头: 簇内合成一次 → 平衡点,LEACH 就是典型 基站/边缘: 保留最多原始, 但中继段几乎没省 决策: 根据"丢细节的可容忍度"与"每跳电费的占比"选位置
没有"一定能放哪儿"的标准答案,原则是**"在哪一级聚合省下的电最多、同时业务还够用"**。多数持续监测选簇头聚合,因为那是长期运营的省电甜蜜点。
聚什么:不同函数各保什么信息
"聚成一条"没说清"聚成哪条",不同聚合函数保留的信息完全不同,别随手取平均了事:
| 聚合函数 | 保留什么 | 丢掉什么 | 适用 |
|---|---|---|---|
| 均值 | 整体水平 | 分散程度、极端值 | 平稳趋势 |
| 最大/最小 | 极端情况 | 平均水平 | 越界/异常检测 |
| 方差/标准差 | 波动程度 | 具体数值 | 稳定性判断 |
| 直方图 | 分布形态 | 顺序/位置 | 统计画像 |
聚合的本质是"有选择地丢弃",丢什么取决于业务最在乎什么。 一次上报若能带"均值 + 极值 + 方差"三个数,往往既省电又几乎不丢结论——这是实践里很顺手的一条经验。
再进一步:压缩与隐私保护型聚合
聚合之外还有两道与它相关的手艺值得点一下。其一是先压缩后聚合:把相邻节点的冗余先就地压掉,再在簇头聚合,省上加省。其二是在聚合时顺带做隐私保护:用同态加密等手法让簇头"能聚合、看不到单条原始值",既省传输又守隐私——但这要以额外算力为代价,是否值得要看敏感程度。把这些和"数据为中心"的取数方式叠在一起,就成了应用层整套"少传值钱的"的组合拳。
融合的边界:什么时候不值得聚
聚合虽省,却非万能,认清它的适用范围能少走弯路。当"每颗节点的原始值都必须单独到,缺一不可"时,聚合就不合适——比如要逐点判决、或数据本身高度异构没法合成一句话。还有个前提:聚合点要有能力集齐、算得动、且这个"攒一批再发"的延迟业务能接受。 若这三条任一不满足,硬聚反而因丢信息、多等待而得不偿失。判断"该不该聚",就用"少传的那点电 vs 丢掉的那些细节 + 多等的那点时间"去对账,答案自然清晰。
一个聚合实现的分工想象
把聚合落到工程上,看簇头怎么一步步"攒出一条摘要",印象会更深:
1. 收数: 簇内各节点把读数按约定周期报给簇头 2. 判异: 各自先标一个"是否越界"标志位, 不看数值也要先报异常 3. 聚合: 簇头对正常读数算均值/最值/方差, 合成一条摘要 4. 带上标志: 把"是否有异常节点"作为特定位拼进报文 5. 上送: 网关收到的是"一块代表值 + 一块异常位", 而非 5 条原始
这样一个"入队、判异、合成、上送"的流水,就是聚合在真实节点上的样子。它顺带解决了一个常见难题——"万一某个节点异常被均值抹平怎么办",靠早在一进簇头的第一步就先单独把异常标志留着,从根上防住了"平均掉真事"。 把这张分工图记住,再回头读各种聚合协议就都不神秘了。
本节要点回顾
- 根源:高密度部署带来海量相似读数。
- 融合 vs 聚合:融合算得更聪明,聚合传得更省。
- 省多少:10 份压成 1 条,传输能耗近同比例降。
- 三风险:信息变粗、单点攻击被放大、簇太小收益打折。
- 好策略:均值+最值+异常标志,兼顾趋势与极端。
数据省着传了,可"基站收到的是哪里的数据"取决于定位。下一节看节点定位技术。