7.1 理论分析与仿真平台
7.1 理论分析与仿真平台
本节摘要:设计要先在纸上算、再到电脑里跑,最后拿真信号验。本节讲清理论分析给什么、仿真到底补什么,再把链路级与系统级两种仿真各用什么平台、关键参数取哪几项摊开,让你能独立把第 2.4 章的链路预算主表变成一个能跑出曲线的仿真实验。
承接 2.4 的链路预算主表与 7.3 的评估指标,本节提供把"纸上账"自动化的手艺——理论给边界、仿真给曲线,两者咬合成验证的第一级台阶。
纸上算的账,永远要回真实世界过一道秤
前面几章你动辄在主表上摆功率、调增益、算余量,好像算完"余量为正"就万事大吉。可真要落地,这几页纸上账还得先经受一道最实在的考验——真实世界从不会照着理想模型跑。多径、干扰、调度交互、器件非线性,这些"现实噪音"几乎会把每一张算好的表都扯歪几寸。于是验证的必要性就来了,而验证的第一级台阶,就是"理论 + 仿真"这一对搭档。
这对搭档的分工很有意思:理论给的是"天花板"和"直觉"——一条香农公式不用跑出任何曲线,你就知道上限落在哪、该往哪儿使劲;一份链路预算手算,就先估出"大概能不能通"。仿真给的是"实况曲线"——把第 1.1 章的信道模型、第 3 章的调制编码、第 4 章的调度逻辑塞进一个可配置场景,跑出误码率、吞吐、时延这些具体数字。
更准确地说,这是三级台阶而不是两级:理论估算 → 链路级仿真 → 系统级仿真。理论最省、答上界;链路级盯着"一条点对点链路"验物理层;系统级盯着"一整片互相干扰的网络"验调度与规划。层级越深,越像真实的整片网,代价是算力与场景细节的投入越大。工程上几乎从不一上来就砸系统级大模型,而是从理论起、逐级加码——这条"由简入繁"的验证路径,本身就是对成本与可信度的对账。
学习目标
- 分清理论分析、链路级仿真、系统级仿真各自回答什么问题。
- 能为一类仿真列出关键的输入参数与输出指标。
- 说清仿真里最容易唬人的两个坑:场景假设与随机种子。
理论给的是"天花板",仿真给的是"实况曲线"
理论分析的价值在给边界:一条香农容量公式,不用跑仿真就知道"上限在那儿";一份链路预算计算,就能先估算"大概能不能通"。它的缺陷也明显——真实信道不是理想 AWGN,多径、干扰、调度交互这些"现实噪音"它照顾不过来。
仿真就补这一刀:把信道模型(第 1.1 章)塞进一个可配置的场景,输入参数、跑出误码率、吞吐、时延的曲线。它不能替代理论,却能回答理论答不上来的"具体到某个信道下、某个调度下到底表现如何"。
两种仿真,两个平台阵营
- 链路级仿真:盯着"一条点对点链路怎么传"——调制、编码、信道、解调。常用数学与通信工具,验证第 3 章那些物理层设计。
- 系统级仿真:盯着"一个网络里上百链路互相干扰"——调度、干扰、切换、负载。常用系统级仿真器,验证第 4、5 章那些资源与规划决策。
脚本与参数库常直接复用:信道模型、调度策略、干扰装置都可以做成可配置组件。真正要小心的不是语法而是场景假设——仿真得再漂亮,场景设偏了,结果就是"自嗨的曲线"。
一张"三台阶"的图把分工铺平
理论、链路级仿真、系统级仿真各站在哪里,画一张台阶图一目了然。
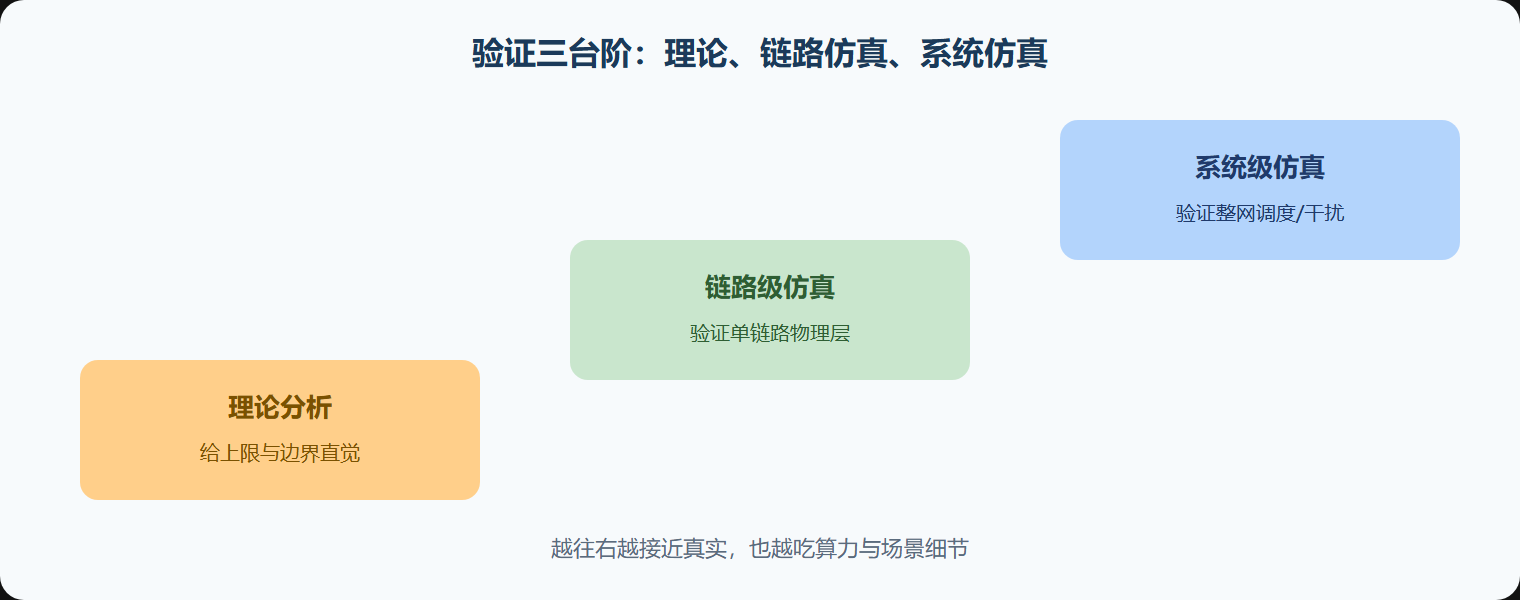
越往右,仿真越像"真实的一整片",代价是算力与场景细节的投入越来越大。实际工程常从理论估算起步、链路级定位、系统级收官,层层递进,而不是一上来就砸系统级大模型。
一次能跑起来的链路仿真雏形
用一段脚本,把第 2.4 章的链路预算做成一个"扫多个信噪比点出结果"的极简仿真骨架:
import math, random random.seed(11) def awgn_ber_snr(snr_db, trials=20000): # 极简BPSK在AWGN下误码率蒙特卡洛 err = 0 sigma = 10**(-snr_db/20) for _ in range(trials): rx = 1.0 + random.gauss(0, sigma) err += 1 if rx < 0 else 0 return err / trials for snr in [4, 8, 12]: print(f"信噪比 {snr:>2} dB -> 蒙特卡洛误码率约 {awgn_ber_snr(snr):.4f}")
输出会随信噪比上升而掉得飞快——这就是"把第 3 章误码率画成曲线"的最小原型。改参数、换信道、叠干扰,都是从这根骨架长出来的本事。
把这三级台阶放回全书那张账,你会看到它与第 2.4 章主表之间是一条自然的"由简入繁"路径:理论估算先给那张主表定上界与直觉,链路级仿真再把它落成一条条具体曲线,系统级仿真最后在与全网的交互中验证它。每一级都比上一级更接近真实的整张网,代价是算力与场景设定的投入越来越大。工程上几乎从不会一上来就砸系统级大模型,而是先用手算和链路级仿真"看清物理层行不行",再决定要不要铺开系统级仿真——这套分级投入的做法,本身就是对"成本与可信度"在做对账。而本节最关键的一句是:仿真永远代替不了理论,它只是让理论在更真实的环境里现出原形;两者咬合,才构成验证这张账的第一级台阶。
关于搭一个可信的仿真,还有两句经验可以带走:一是"先把简单的事做对,再逐步加复杂"——先用最朴素的信道与场景把主流程跑通,确认逻辑无误,再一层层叠多径、干扰、调度,避免一上来就夹杂太多变量、出错都找不到源头;二是"每个参数都要有出处"——仿真的输入几乎全来自前几章的那些物理账,发射功率来自 2.4 的主表、信道取自 1.1 的模型、调制编码取自第 3 章,参数不正,跑得再花也是自欺。带着这两句规矩去搭仿真,你从纸上到电脑的这一级台阶才算真正踩实。
易踩的坑
常见坑:把仿真结果当"数学证明"。仿真里随机种子不同、样本数不同、场景参数不同,同样的仿真能跑出天差地别的数。报数时不说"这个种子的结果",而要交代场景与统计口径,否则读的人都掉陷阱。
本节要点回顾
- 理论给上界:香农、链路预算这类理想模型给边界与直觉。
- 仿真给实况:把多径、干扰、调度塞进场景跑出曲线。
- 两级仿真:链路级验物理层,系统级验调度与规划。
- 收敛路径:理论起、链路定位、系统收官,逐级加真实度。
- 别被曲线骗:场景假设与随机种子是仿真可信度的命门。