7.2 预测区间与置信带
7.2 预测区间与置信带
本节摘要:单点预测是"猜中位数",预测区间是"猜分布"。本节区分预测区间(predictive interval)和置信带(confidence interval)两个易混概念,并演示 ARIMA 与 Prophet 的预测区间计算。
学习目标
阅读完本节,你应当能够:
- 解释预测区间和置信带的统计含义差异。
- 用 statsmodels 算 ARIMA 预测区间,用 Prophet 算 Prophet 预测区间。
- 判断"区间应当多宽"——区间太窄代表过度自信,太宽代表模型无效。
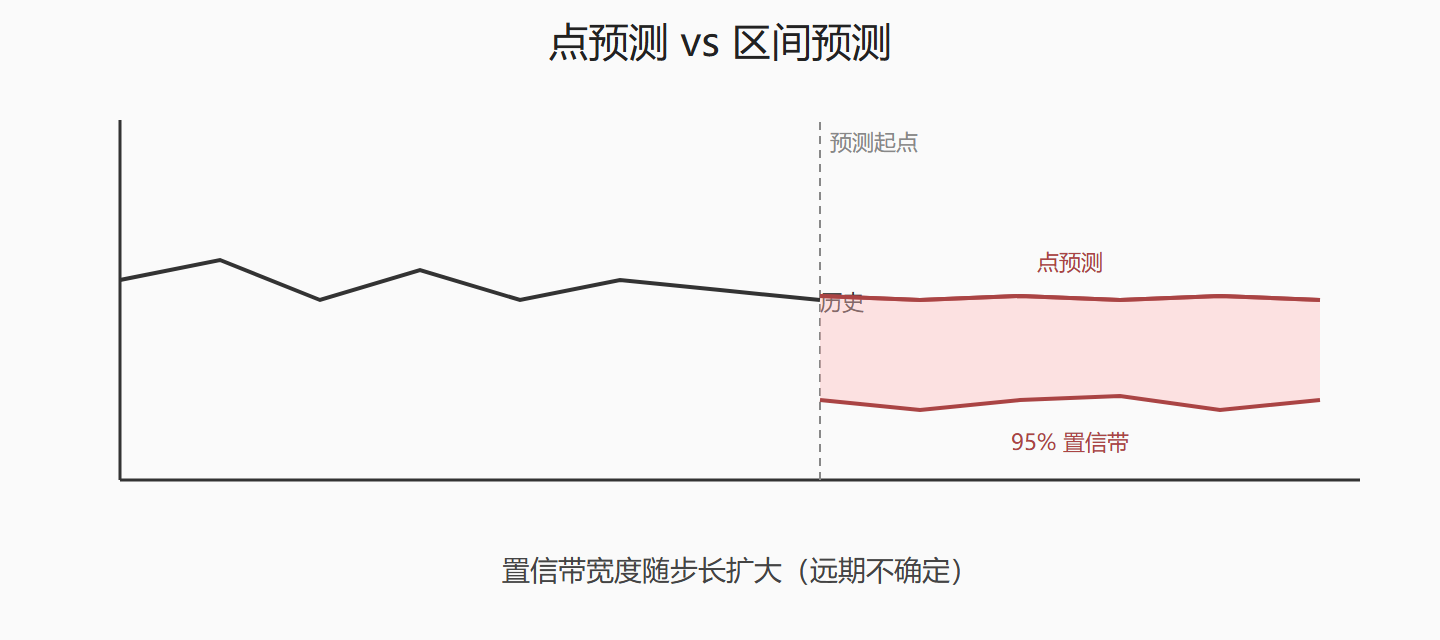
一、预测区间 vs 置信带
这两个概念在初学者中常被混用,但数学含义不同:
- 预测区间(predictive interval):未来观测值 y(t+h) 的区间。关心的是"未来某个值大概落在哪里"。
- 置信带(confidence interval):未来期望 E[y(t+h)] 的区间。关心的是"未来平均值大概落在哪里"。
直观上:
- 预测区间 = 单个未来值的范围。宽度受未来噪声方差影响。
- 置信带 = 未来均值的范围。比预测区间窄(因为均值的不确定性小于单点)。
大多数业务场景关心的是预测区间——比如"明天的销量大概在 800–1200 之间"。下文围绕预测区间展开。
二、ARIMA 的预测区间
statsmodels 的 get_forecast 同时返回预测均值和预测区间:
from statsmodels.tsa.arima.model import ARIMA # 拟合 ARIMA(1,1,1) model = ARIMA(s, order=(1, 1, 1)).fit() # 预测未来 12 期 + 95% 预测区间 forecast = model.get_forecast(steps=12) mean = forecast.predicted_mean ci = forecast.conf_int(alpha=0.05) # alpha=0.05 → 95% 区间 # ci 是 DataFrame,列名 lower/upper 对应区间 print(ci.head())
预测区间宽度随 horizon 增大。horizon=1 时区间最窄,horizon 越大区间越宽——因为预测越远,不确定性累积。
三、Prophet 的预测区间
from prophet import Prophet m = Prophet(yearly_seasonality=True, weekly_seasonality=True) m.fit(df) future = m.make_future_dataframe(periods=30, freq="D") forecast = m.predict(future) # 关键列 print(forecast[["ds", "yhat", "yhat_lower", "yhat_upper"]].tail())
yhat_lower / yhat_upper 默认是 80% 区间。要 95%:
m = Prophet(interval_width=0.95).fit(df)
四、预测区间应当多宽
经验法则:
- 业务对预测准确性要求高(库存调度、容量规划)→ 95% 区间。
- 业务对预测区间宽度敏感(不能太宽否则无操作意义)→ 80% 区间 + 监控"区间覆盖率"。
判断区间宽度是否合适的指标:区间覆盖率(interval coverage)——测试集中真实值落在预测区间内的比例。
# 假设 test 是测试集,pred 是预测区间 coverage = ((test >= ci["lower"]) & (test <= ci["upper"])).mean() # 95% 区间 → 覆盖率应接近 95%;偏离太远说明区间校准不好
如果 95% 区间的覆盖率只有 80% → 区间偏窄,需要调大 interval_width 或检查模型残差方差。如果 95% 区间的覆盖率高达 99% → 区间偏宽,可以收紧。
五、过度自信的预测区间
最常见的工程问题:预测区间过窄。ARIMA 默认的预测区间假设残差同方差、独立。如果这两个假设不成立(实际数据常常不成立),区间就会过窄。
解决思路:
- Bootstrap 重采样:在残差上做有放回重采样,构造多个"未来路径",取 2.5% 和 97.5% 分位数作为区间。这种非参数方法不依赖正态假设。
- 异方差模型:用 GARCH、状态空间等显式建模"条件方差随时间变化"的模型。
- 集成预测:用多个模型的预测取平均,区间取所有模型预测的并集。
六、一个 Bootstrap 区间估计的例子
# 用 Bootstrap 构造 95% 预测区间 def bootstrap_forecast(model, steps=12, n_sims=1000, alpha=0.05): residuals = model.resid sims = [] for _ in range(n_sims): # 在残差上有放回采样 future_resid = np.random.choice(residuals, size=steps, replace=True) # 假设未来没有新信息,预测是固定的 sim = model.forecast(steps) + future_resid sims.append(sim) sims = np.array(sims) lower = np.percentile(sims, 100 * alpha / 2, axis=0) upper = np.percentile(sims, 100 * (1 - alpha / 2), axis=0) return lower, upper
Bootstrap 区间对非正态残差、异方差都更鲁棒。业务上凡是对预测区间敏感的场景,都建议用 Bootstrap 校准。
七、置信带的不确定性比预测区间小
回到概念区分:
- 预测区间:未来单个值的范围。ARIMA(1,1,1) 预测 12 期,95% 预测区间 ±15 单位。
- 置信带:未来平均值的范围。同样的设置,95% 置信带可能只有 ±3 单位。
业务上几乎总是要预测区间(关心"明天具体多少"),但汇报时也提一句"我们对这个预测的把握有多高"——这就是置信带。
本节要点回顾
- 预测区间 vs 置信带:未来单点 vs 未来均值;前者宽、后者窄。
- ARIMA 预测区间:
get_forecast(steps).conf_int(alpha=0.05)。 - Prophet 预测区间:
interval_width=0.95。 - 区间宽度校准:95% 区间的覆盖率应接近 95%。Bootstrap 校准更鲁棒。
- 过度自信:默认 ARIMA 区间经常过窄。Bootstrap / GARCH / 集成可改进。
- 下一节线索:7.3 进入"应用场景"——时间序列分析在四个典型场景中的实战用法。
图:点预测 vs 区间预测
评论区
(0)
U