1.1 时间序列数据特性
1.1 时间序列数据特性
本节摘要:时间序列数据是按照时间顺序排列的数据点集合,其最独特之处在于相邻观测之间存在依赖关系。本节拆解时间依赖、趋势、季节性、周期性、噪声、平稳性六大特性,并重点说明每个特性如何影响异常检测算法的选择。理解这些特性,是后续所有检测方法选型的逻辑起点。
学习目标
阅读完本节,你应当能够:
- 说出时间序列区别于普通样本数据的三条本质特征。
- 用自相关函数 ACF 和偏自相关函数 PACF 的含义解释"时间依赖"。
- 区分趋势与季节性、季节性(固定周期)与周期性(非固定周期)两组易混概念。
- 说明平稳性的三个条件,以及为什么 ARIMA 等模型要求数据平稳。
- 针对给定数据特性,判断该优先考虑哪类检测算法。
一、问题与直觉
假设你面前有两组数据。第一组是从 1000 个人里随机抽出的身高记录,第二组是某台服务器的 CPU 使用率,每 5 分钟采样一次,存了一整天。
对第一组,你可以放心地把它们当"互相独立"的样本处理——A 的身高和 B 的身高没有关系,算个均值、方差就完事。但第二组完全不同:下午三点那一条 CPU 使用率的数值,和下午两点五十五分的数值高度相关;服务器如果正被一场促销活动压着,接下来几小时大概率都会保持高位。
这个差别,就是时间序列数据的第一个也是最重要的特性:观测之间不是独立的,它们按时间顺序互相牵连。 如果你无视这种牵连,直接拿处理独立样本的方法硬套,后果很具体——节假日流量翻倍会被当成"异常"报警,因为模型不知道"每年这时候本来就高"。
更麻烦的是,时间序列还不止"互相牵连"这一层。它可能长期走高(趋势),可能每天有规律地起伏(季节性),可能叠加了测量设备的随机抖动(噪声),还可能是"统计性质随时间漂移"的非平稳序列。这些特性互相叠加在一起,才构成你手头看到的那条曲线。异常检测的本质,就是从这堆叠加的信号里找出"违背规律"的那部分——所以不先认识规律由哪些成分组成,找异常就无从谈起。
这一节我们把这六种特性逐个拆开,每拆一个,都顺带回答一个实操问题:它在提醒你选什么方法。
二、核心原理
2.1 时间依赖性:今天的你和昨天的你有关
时间依赖是时间序列的身份证。当前时刻的值与过去时刻的值之间存在某种关联,意味着数据不是独立同分布的——这一条直接把一大类"假设样本独立"的统计方法排除在适用范围之外。
度量时间依赖的两个标准工具是自相关函数(ACF)与偏自相关函数(PACF)。
自相关函数描述序列与其自身滞后版本之间的相关性。以每日气温为例,今天的温度与昨天的温度相关性极高,与一周前的气温相关性就弱多了。ACF 就把这种"与滞后 k 期之间的相关性"画成一条随 k 衰减的曲线。
偏自相关函数则更挑剔一点:它度量"在剔除了中间所有滞后值的影响之后",序列与滞后 k 期之间的净相关性。打个比方,ACF 像看一个人跟三代祖辈的整体相似度,PACF 像只看"隔代遗传"那部分——剔除父母影响后,你跟你祖父还像不像。
为什么这个特性对异常检测如此关键?因为大量检测算法的底层逻辑都是"用历史预测现在"。ARIMA、LSTM 之所以能用于时序异常检测,靠的就是先捕捉这种自相关结构、预测出"应该是什么样",再拿实际值和预测值比残差。如果一个序列根本没有时间依赖(比如纯随机噪声),那么"预测残差法"就完全失效——因为你根本无从预测。
2.2 趋势性:长期往一个方向走
趋势是数据在长期内表现出的整体方向,可以是线性的(每年稳定增长 5%),也可以是非线性的(指数增长、对数增长)。
趋势对检测算法的影响非常直接,甚至可以算是最容易被忽视的一个坑。想象一套固定阈值的 CPU 告警规则:阈值定在 80%。如果业务整体在增长,CPU 基线从 60% 慢慢爬到 85%,那么固定阈值会在"整个系统其实一切正常"的情况下持续误报;反过来,如果阈值定在 95%,当系统从 90% 一路爬向 98% 这个"渐变恶化"过程中,你什么都收不到,直到彻底打爆。
处理思路只有一条:检测之前先"去趋势"。 差分、减去移动平均、做线性回归拟合后取残差,都是常见的去趋势手段。第 2 章的时间序列分解会系统讲这个,这里先记住结论——带明显趋势的数据,绝不能让模型直接对着原始值判断。
2.3 季节性:按固定周期重复
季节性指数据在固定时间间隔内重复出现的模式。每日的季节性,比如用电量白天高、夜里低;每周的季节性,比如商场销售额周末冲高、工作日走低;每年的季节性,比如冰淇淋销量夏季见顶。
这里有个极易混淆的点,必须拎清楚:季节性(Seasonality)的周期是固定的、可预测的,而周期性(Cyclicity)的周期是不固定的。经济繁荣衰退循环、太阳黑子活动周期,都属于周期性——你大概知道它会长达数年,但没法精确说出下一次拐点在哪个月。
对检测来说,这个区别决定你能不能"提前建模"。季节性固定,就能用 SARIMA、STL 这类带季节成分的模型把周期剥离掉;周期性不固定,就只能靠频谱分析等更灵活的手段去试探。
2.4 噪声:掺在信号里的随机抖动
噪声是测量误差、随机事件等带来的不可预测波动。噪声大不是数据"脏",而是数据"本来就长这样"。
噪声对检测的威胁是双面的。一方面,算法对噪声敏感,就容易把噪声尖峰误判成异常,造成虚警;另一方面,如果先去噪声去得太狠,又会把真实异常连同噪声一起抹平——毕竟真实异常往往就藏在高频成分里。
所以"降噪"是一把双刃剑。移动平均、指数平滑、小波去噪各有用武之地(第 2 章详述),但任何降噪都应以"保留异常信号"为前提。这也是为什么像 LOF 这类基于密度的算法对噪声相对稳健——它们看的是局部相对密度,而不是绝对幅度。
2.5 平稳性:统计性质不随"时间起点"变
平稳性是最容易被理解错、却最影响建模的一个概念。一个严格平稳的序列,均值恒定、方差恒定、自相关只依赖滞后阶数而不依赖具体时间点。换句话说,把序列从中间截一段下来,统计性质跟开头那段没本质区别。
为什么 ARIMA 这类模型把平稳性当成硬前提?因为 ARIMA 的数学框架假设"规律是恒定的"——如果序列的均值本身在漂移,那么任何"用过去均值预测未来"的做法都会系统性偏离。把非平稳序列喂给平稳假设的模型,就像让一个只学过匀速直线运动的机器人去追变速的球。
好在这类序列通常有救:一阶差分把"水平漂移"变平稳,对数变换把"方差漂移"压平。第 4 章讲 ARIMA 时会看到完整流程。
三、工程实践要点
3.1 一张表搞定"特性 → 方法"映射
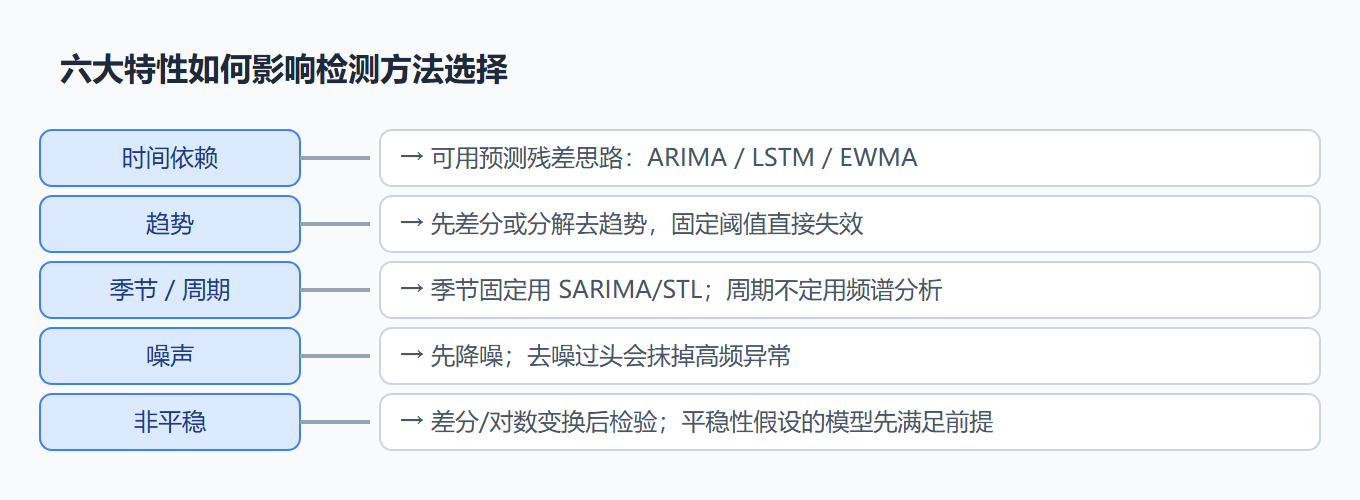
| 数据特性 | 对检测的影响 | 推荐应对思路 |
|---|---|---|
| 强时间依赖 | 可用"预测残差"思路 | ARIMA、EWMA、LSTM 等预测类模型 |
| 明显趋势 | 固定阈值必然误报/漏报 | 先差分或分解去趋势 |
| 固定季节性 | 季节高峰会被误判 | SARIMA、STL 剥离季节成分 |
| 非固定周期性 | 无法精确建模周期 | 频谱分析、滑动窗口自适应 |
| 高噪声 | 虚警率高、真异常被抹平 | 适度降噪,保留高频异常 |
| 非平稳 | 平稳假设的模型全部失效 | 差分、对数变换后检验 |
3.2 实操检查清单
拿到一份数据,动手建模之前先花十分钟回答四个问题:
- 自相关强不强? 画个 ACF 图,若滞后 1–2 期相关系数明显不为零,说明"预测残差法"有戏。
- 有没有趋势? 直接看全序列折线图,或者拟合一条线性回归看斜率是否显著非零。
- 有没有固定周期? 按小时/周/年对齐画分组箱线图,或做一次快速傅里叶变换看主频。
- 平不平稳? 跑 ADF 检验,p 值大于 0.05 基本可以判断非平稳,需要差分。
⚠️ 常见坑:"把异常检测当离群点检测用"——许多初学者对着整条序列直接套 Z-score 或箱线图,把趋势期的正常高位全标成异常。数据一旦带趋势或季节性,必须先分解或差分,否则你检出的"异常"其实是"正常的周期起伏"。
💡 关键直觉:判断一个点是不是异常,永远要回答"相对什么而言"。相对历史均值?相对同时段历史?相对预测值?你选的参照系,决定了你会漏掉哪类异常。
3.3 特性组合才是常态
现实数据几乎都是几种特性叠加。一条工业设备振动曲线,可能既有缓慢上升的趋势(设备老化),又有 24 小时的昼夜周期(环境温度影响),还掺着随机噪声。这时候靠单一手段往往不够,常见做法是:先分解剥离趋势和季节,得到近似平稳的残差,再对残差做异常检测。这套"先分解、后检测"的流水线,是第 2 章和第 4 章反复出现的骨架。
一节小结
- 时间依赖是时间序列的身份证,ACF/PACF 是度量它的标准工具;预测残差类方法都建立在"自相关可学习"的前提上。
- 趋势是长期方向,带趋势的序列直接用固定阈值必然出问题,必须先差分或分解去趋势。
- 季节性周期固定可建模,周期性周期不定只能试探,两者处理思路完全不同。
- 噪声是随机波动,降噪要平衡"压虚警"与"保异常"——去过头会把真异常一起抹平。
- 平稳性要求均值、方差、自相关结构稳定,是 ARIMA 类模型的前提;非平稳序列先差分或对数变换。
- 拿到数据先回答四个问题(自相关?趋势?周期?平稳?),再决定用什么方法,比直接套算法靠谱得多。
下一节我们将从"数据长什么样"转向"异常长什么样"——给异常做精确的三分类,你会看到上下文异常为什么是自动检测里最难缠的一类。