2.1 数据清洗与缺失值处理
2.1 数据清洗与缺失值处理
本节摘要:原始时间序列数据几乎必带缺失值、异常值、重复值与格式问题,这些问题会直接污染后续特征工程和检测模型。本节讲清缺失值的三种机制(MCAR/MAR/MNAR)及其对处理策略的影响,对比删除、常数/均值/中位数插补、线性/样条/季节插补、前后向填充、KNN 插补、模型预测插补等方法,最后给出按缺失比例与数据特性选型的方法论,并给出基于 pandas 的完整处理示例。
先说结论
阅读完本节,你应当能够:
- 区分数据清洗的四类任务:异常值处理、类型转换、去重、格式标准化。
- 解释 MCAR、MAR、MNAR 三种缺失机制的区别,以及为什么 MNAR 最棘手。
- 在"删除"与"插补"之间做出选择,并为给定场景选出合适的插补方法。
- 理解为什么"向前填充"适合某些时序而"线性插值"适合另一些。
- 用 pandas 完成缺失值检测、可视化、处理的完整流程。
一、问题与直觉
凌晨的风电场数据平台上,某个风机的功率曲线出现了一个"断崖":从凌晨 1 点到 3 点,连续 120 条数据全部是空值。运维同事看了一眼就说"是通讯模块掉线了",然后把数据重新拉了一遍,补上了。看似小事,但如果这套数据后面要用来训练一个"叶片结冰异常检测"模型呢?模型的训练集里出现了一段两小时的空白,它学到的东西就会带着一个洞。
更阴险的是另一种情况:数据没缺,但"看起来不对劲"。某个温度传感器连着三天输出 -999(厂商约定的"无数据"占位值),你如果不认识这个编码,就会把 -999 当成真实温度喂进模型,然后"欣喜地"发现检测到了 -999℃ 的宇宙级异常。
清洗的目的不是"把数据修好",而是"不让错误的假设进入模型"。 缺失值、占位值、重复时间戳、单位混乱——每一个都在给模型埋雷,而异常检测本身就是要从数据里找"不对劲",如果数据本身就不对劲,那检出的"异常"就真假难辨:到底是传感器坏了,还是设备真的要出故障?
这一节我们从工程视角把"脏"拆成四类,重点讲透缺失值——它是最常见、也最需要策略的一类。
二、核心原理
2.1 数据清洗的四类任务
异常值检测与处理。 这里的"异常值"指的是在建模前就需要处理的、明显是错误或极端的数据点——它和我们全书要检测的"业务异常"不同,前者是"数据质量问题",后者是"业务信号"。两者的界限有时模糊:一次真实的设备故障导致的读数飙升,到底是"脏数据"还是"要检出的异常"?判断标准只有一个——它符不符合数据的正常来源机制。传感器量程外的值、物理上不可能的值(温度为负 300 度),先当脏数据处理;物理上可能但罕见的值,留着当待检异常。
处理手段:删除(数量少且确为错误)、替换(用均值/中位数/插值)、Winsorizing(把超出范围的值截断到边界值)。
数据类型转换。 时间戳必须是日期时间类型,数值列必须转成数值类型,分类变量用独热编码或标签编码。这一步看似琐碎,做错会导致排序错乱、比较失效——把字符串日期当成文本排序,"2023-01-09"会排到"2023-01-2"前面,整个时间轴就废了。
重复值处理。 识别重复时间戳或重复数据行。若同一时间戳有多条不同值,需要分析保留哪个或如何合并——多数情况下取平均值或按可信度取一条。
数据格式标准化。 统一时间戳格式(2023/01/09 vs 2023-01-09)、统一单位(摄氏度 vs 华氏度)、统一编码。多源数据合并时这一步尤其关键。
2.2 缺失值的三类机制
选择缺失值处理方法前,先问一个关键问题:这个值为什么会缺失? 统计上把缺失机制分为三类:
- 完全随机缺失(MCAR):缺失概率与其他任何变量无关。比如数据采集程序偶发 bug,随机丢掉几个点。这是最"无害"的缺失——删除或简单插补都不会引入偏差。
- 随机缺失(MAR):缺失概率仅与已观测到的变量有关,与缺失值本身无关。比如高负载时段的采样更可能丢失——负载是已观测变量,缺失跟负载有关,跟"本应采到但没采到的那条值"无关。这类缺失做插补时,要把"负载"这个协变量也考虑进去。
- 非随机缺失(MNAR):缺失概率与缺失值本身有关。比如温度超过 50 度时传感器过热罢工——你能观测到缺失,但缺失的原因恰恰是你没观测到的高温。这类缺失最棘手,任何删除或插补都可能系统性地扭曲结果。
2.3 删除还是插补:先看比例
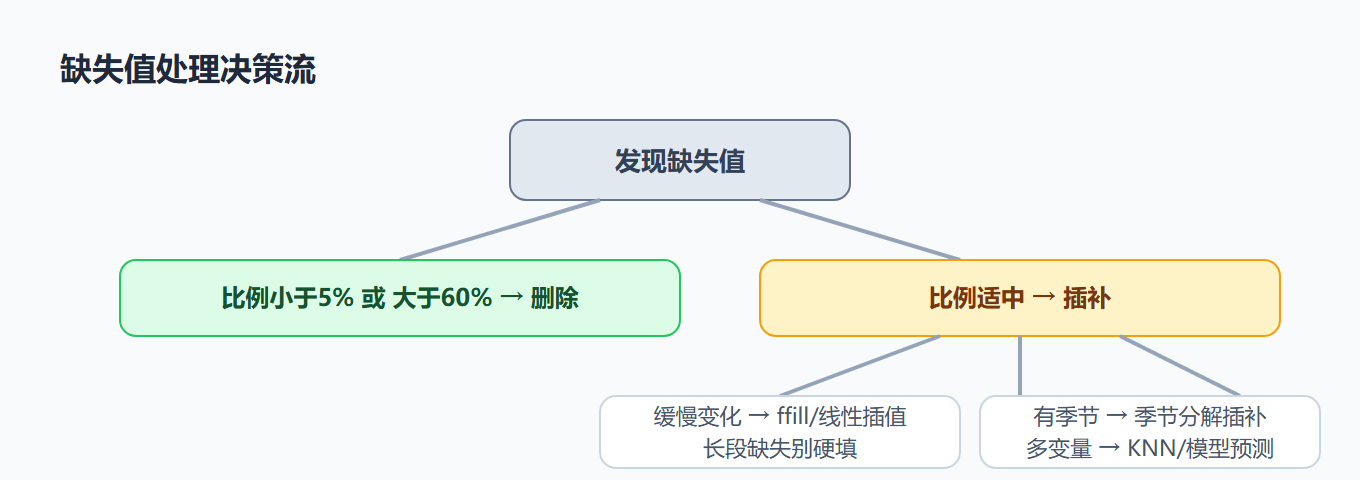
删除路线只适用于两种情况:缺失值极少(如 <5%),删除后不会显著改变分布;或某列缺失过多(如 >60%),插补等于在编故事,不如整列放弃。
插补路线则要按数据特性选方法:
| 方法 | 适用场景 | 特点与风险 |
|---|---|---|
| 常数填充 | 快速兜底 | 简单但引入偏差,制造大量重复值 |
| 均值/中位数填充 | 分布对称、缺失随机 | 低估方差,压缩波动 |
| 线性插值 | 数据近似线性变化 | 时序里最常用,假设短区间线性 |
| 多项式/样条插值 | 变化复杂但平滑 | 拟合更灵活,注意过拟合和振荡 |
| 季节分解插补 | 有明显季节性 | 用同时段历史补,保留周期结构 |
| 向前填充 ffill | 缓慢变化量(温度、水位) | 用最近一个有效值,延迟可接受 |
| 向后填充 bfill | 缓慢变化量且后向更可信 | 与 ffill 相反方向 |
| KNN 插补 | 多变量、有相似样本 | 用相似样本均值,计算量大 |
| 模型预测插补 | 有可用特征、数据量大 | 线性回归/决策树预测,成本高但准 |
时序场景的两个关键判断: 其一,值随时间是"连续缓慢变化"还是"围绕固定水平波动"——前者适合 ffill/线性插值,后者适合均值/季节插补。其二,缺失段有多长——短段插补可信,长段(如连续两小时空白)任何插补都是编故事,要么去重采样、要么整段标记。
2.4 处理流程与示例
标准流程四步:检测 → 可视化 → 处理 → 验证。
import pandas as pd import numpy as np # 构造含缺失值的时间序列:100 天,中间两段置空 data = {'timestamp': pd.date_range('2023-01-01', periods=100, freq='D'), 'value': np.random.randn(100)} df = pd.DataFrame(data) df.loc[10:20, 'value'] = np.nan df.loc[50:60, 'value'] = np.nan # 1. 缺失值检测 print("缺失数量:", df['value'].isnull().sum()) print("缺失比例:", df['value'].isnull().sum() / len(df)) # 2. 处理:线性插值 / 向前填充 / 向后填充 / 均值填充 对比 df['v_interp'] = df['value'].interpolate(method='linear') df['v_ffill'] = df['value'].fillna(method='ffill') df['v_bfill'] = df['value'].fillna(method='bfill') df['v_mean'] = df['value'].fillna(df['value'].mean())
这段代码展示的不是"标准答案",而是"四种假设"。线性插值假设缺失区间内值按线性变化;ffill 假设最近值能代表现在;均值填充假设缺失与位置无关。把这四列画在同一张图上,你立刻能看出哪种假设对你这批数据最合理。
⚠️ 常见坑:ffill/bfill 处理长段缺失。 如果一个设备断连了两天,用 ffill 就会得到"连续 48 小时数值不变"的假数据——这在检测模型里会制造一整段"零变化",可能被误判为异常,也可能掩盖真实异常。长段缺失宁可整段删除或标记,也别硬填。
💡 关键直觉:插补的本质是"用假设补数据",而异常检测的本质是"找出违反假设的数据"。 所以插补方法的选择,会直接影响后续检测的语义——用均值填充后的数据,均值附近很难被检出异常;用 ffill 填充后的数据,突变会被放大。想清楚"你允许哪种假设污染检测结果"。
三、工程实践要点
3.1 插补前后对比的验证习惯
不要只填完就开跑。养成习惯:插补前后各画一次分布图(直方图/箱线图),对比均值、方差是否被明显改变。如果插补后方差缩水 30%,说明插补方法在压缩波动——对一个要靠"波动偏离"找异常的模型,这等于自废武功。
3.2 把"清洗规则"也当成产品的一部分
数据清洗不该是一次性的脚本,而应该沉淀成可复用的规则库:哪些编码是占位值(-999、0xFFFF)、哪些时间戳要合并、哪类缺失用哪种插补。原因很简单——生产环境的数据源会持续产出同样的脏数据,规则库比一次性脚本值钱得多。 而且规则库本身就是给异常检测系统加"领域知识"的第一层。
3.3 一个决策小抄
| 场景 | 推荐做法 |
|---|---|
| 缺失 <5% 且随机 | 直接删除该行 |
| 缺失 5%–20%,值缓慢变化 | 线性插值或 ffill |
| 缺失 5%–20%,值有明显季节性 | 季节分解插补 |
| 缺失 20%–50%,多变量 | KNN 或模型预测插补 |
| 单列缺失 >60% | 放弃该列 |
| 连续长段缺失 | 整段删除/标记,不硬填 |
3.4 缺失值处理与异常检测的相互影响
这里必须点破一个容易被忽视的联动关系:插补方法的选择,会直接改变后续异常检测的语义。 举个例子,用"全局均值填充"补出来的缺失段,数值全是同一个常数——在检测模型眼里,这一段的"波动方差"是零,会制造出一段"假平稳"。如果这段正好夹在一个真实异常前后,模型对"波动突然消失又突然出现"的判断就会被带偏。反过来,用"线性插值"补的长段,插值出的值恰好落在前后两个真实值的连线上——如果真实值之间藏着一个本该被检出的异常尖峰,插值会把尖峰抹平成一条直线,异常就从数据里"消失"了。
给时序检测项目的一个硬性建议:处理缺失值时,把"这段缺失前后发生了什么"记录下来。 当检测系统在缺失段附近报警时,你要能回答"这是真异常,还是插补制造的人工痕迹"。最好的工程实践是:在数据里给每个缺失段打标记列(is_missing=True),让检测模型知道"这一段是补出来的,可信度打折"——而不是让它把补出来的数据当真。
实战问答
问:时间戳乱序和重复怎么办?
先按时间排序,再检查重复:同一时间戳出现多条不同值时,多数取均值或按数据来源可信度取舍;纯重复行(完全相同的值)直接去重。顺序和去重做完,再谈缺失值。
问:占位值(如 -999、9999)算缺失吗?
算。占位值本质是"厂商约定的缺失标记",必须先识别、转成 NaN,否则模型会当真值学进去。识别占位值是数据清洗里最容易被忽略的一步,务必问清楚数据源的取值约定。
问:缺失值处理完,怎么验证效果?
插补前后各画一次分布图(直方图/箱线图),对比均值、方差是否被明显改变。如果插补后方差缩水超过 30%,说明插补在压缩波动——对靠"波动偏离"找异常的模型,这等于自废武功。
问:为什么不建议对长段缺失做插补?
因为插补的本质是"用假设编数据"。连续两小时的空白,任何插补方法都是凭空编故事——ffill 制造"假平稳",线性插值制造"假直线"。长段缺失宁可整段删除或打标记,也别硬填。
本章回顾
- 四类清洗任务:异常值处理、类型转换、去重、格式标准化——先分清"脏数据"与"业务异常"。
- 三种缺失机制:MCAR 无害、MAR 可控、MNAR 最棘手,决定后续策略的信任度。
- 删除 vs 插补:看缺失比例;<5% 可删,长段缺失别硬填,>60% 放弃该列。
- 插补方法按数据特性选:线性变化用插值,缓慢变化用 ffill,有季节用季节插补,多变量用 KNN。
- 插补是"用假设补数据":插补方法的选择会直接影响检测语义,务必前后对比分布。
- 清洗规则要沉淀成可复用资产,生产环境的数据源会持续产出同样的脏数据。
下一节解决"毛刺"问题——数据不缺失了,但噪声还在。移动平均、指数平滑、Savitzky-Golay、小波去噪,四把刀各有侧重,关键在"去噪"与"保真"之间找到平衡。