2.3 时间序列分解
2.3 时间序列分解
本节摘要:时间序列分解把原始序列拆成趋势、季节性、残差三个成分,是异常检测中最重要的一步预处理。本节讲清为什么必须分解、加法与乘法模型的区别、经典分解与 STL 的原理差异,并用 statsmodels 给出可运行示例。核心思想:异常藏在残差里——把趋势和季节剥离干净,残差就是异常检测的"纯净战场"。
本节地图
阅读完本节,你应当能够:
- 说出分解的三个目的:理解模式、提升预测、简化异常检测。
- 根据"季节波动幅度是否随趋势变化"判断选加法还是乘法模型。
- 解释经典分解与 STL 分解在稳健性上的差异。
- 用 statsmodels 完成一次加法分解与一次 STL 分解。
- 掌握"基于残差做异常检测"的完整流程。
一、问题与直觉
电商平台的订单量曲线,你越看越困惑。2023 年 1 月到 12 月,订单量从日均 5 万涨到日均 15 万,一路上坡;同时每年 6 月和 11 月有两个明显的大促高峰;某天凌晨订单量突然暴跌到接近零——这到底是不是异常?
如果直接拿原始曲线判断,你根本没法回答。因为"暴跌"这个现象里混着三个信号:整体在涨(趋势)、大促有峰(季节)、凌晨本来就低(日内规律)。那个"接近零"的时刻,可能只是正常的凌晨低谷被趋势放大后显得突兀,也可能是一次真故障。
分解的存在,就是为了把这个问题拆干净。 把趋势剥离后,"凌晨接近零"可能只是趋势的一部分;把季节剥离后,再看剩下的残差——如果残差里出现了一个远超正常波动的点,那才是真正的异常。
这就是全书反复出现的那句话的来历:异常藏在残差里。 检测残差比检测原始值简单得多,因为残差已经去掉了所有"可解释的规律",剩下的理论上只有噪声和异常。
二、核心原理
2.1 三个成分各管什么
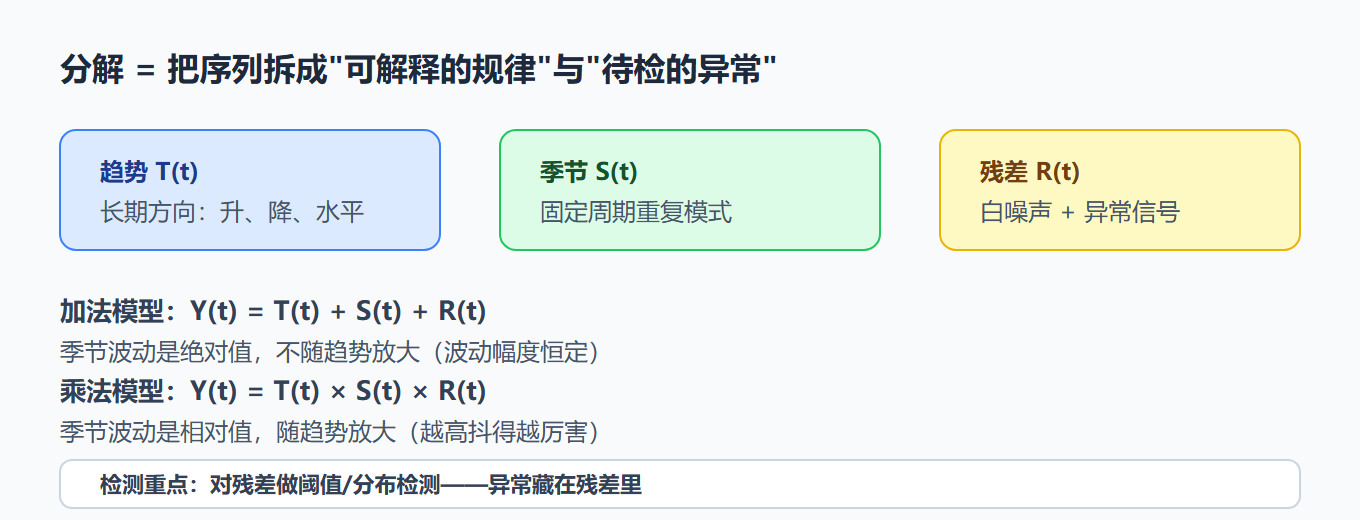
- 趋势 T(t):长期整体方向。可以是线性(每年稳增 5%),也可以非线性(指数增长)。它代表序列"基本面"。
- 季节性 S(t):固定周期内的重复模式。零售的圣诞高峰、电力的昼夜起伏、交通的早晚高峰,都是季节。
- 残差 R(t):剥离前两者后剩下的部分,也叫不规则成分。理想情况下是均值为零的白噪声——但一旦出现显著偏离,那就是异常的信号。
三者叠加成原始序列,叠加方式有两种,对应两种模型。
图:分解把"规律"和"异常"分家
2.2 加法模型 vs 乘法模型
加法模型:Y(t) = T(t) + S(t) + R(t)。季节性波动的幅度是绝对量、不随趋势变化。比如每月销售额的季节波动就是"±100 万",不管基线是 1000 万还是 5000 万。
乘法模型:Y(t) = T(t) × S(t) × R(t)。季节性波动的幅度是相对量、随趋势放大。比如季节因子是"×1.3",基线 1000 万时波动 300 万,基线 5000 万时波动 1500 万。
选哪个?看数据:如果季节波动幅度基本恒定,选加法;如果波动幅度随整体水平升高而变大(高的时候抖得厉害),选乘法。 判断方法很朴素:把序列画出来,看"高峰期的抖动幅度"和"低谷期的抖动幅度"是否差很多。很多实践者会两个模型都跑一遍,选残差更接近白噪声的那个。
2.3 经典分解:简单但娇气
经典分解的思路很直白:用移动平均估趋势(窗口大小等于季节周期,如月数据用 12 个月窗口);原值减趋势得到"季节+残差";再按季节周期逐位平均出季节成分;最后原值减趋势减季节得到残差。
三个局限决定了它只能当"入门级工具":对异常值极敏感(一个离群点会污染整段移动平均)、要求季节周期固定、无法处理季节成分随时间缓慢变化的情况。
2.4 STL 分解:更稳健的主力
STL(Seasonal-Trend decomposition using Loess)用局部加权回归代替简单移动平均来估计趋势与季节成分,带来三个质的提升:
- 对异常值稳健:Loess 回归的局部加权特性让少数离群点的影响被限制在局部,不会污染整条曲线。
- 季节成分可以随时间缓慢变化:现实世界里"圣诞节效应一年比一年弱"这类渐变,STL 能捕捉。
- 更灵活:支持任意周期、可调平滑参数。
这也是为什么在异常检测流水线里,STL 几乎成了默认选项——检测系统的输入容不得"预处理本身被异常干扰",而 STL 恰好能做到。
2.4 常用分解方法对比
| 方法 | 核心机制 | 稳健性 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| 经典分解 | 移动平均估趋势 | 低(怕异常值) | 低 | 简单序列、入门 |
| STL | Loess 局部加权回归 | 高 | 中 | 检测流水线默认 |
| X-13ARIMA-SEATS | ARIMA + SEATS 信号提取 | 高 | 高 | 日历/节假日效应明显 |
| Prophet | 加法模型 + 趋势拐点 | 高 | 中 | 有缺失与异常、要易用 |
| 小波/EMD | 时频分解 | 中 | 高 | 非线性非平稳序列 |
2.5 用 statsmodels 跑起来
import pandas as pd from statsmodels.tsa.seasonal import seasonal_decompose, STL # 构造 24 个月的示例序列 data = [10,12,15,13,16,18,20,19,22,24,26,25, 12,14,17,15,18,20,22,21,24,26,28,27] index = pd.date_range('2023-01-01', periods=24, freq='M') series = pd.Series(data, index=index) # 加法分解 decomp = seasonal_decompose(series, model='additive') trend = decomp.trend seasonal = decomp.seasonal residual = decomp.resid # STL 分解(seasonal 参数指定周期) stl = STL(series, seasonal=13) res = stl.fit()
分解后,把四个子图(原序列、趋势、季节、残差)画出来,你一眼就能看到残差里哪些点"跳出"了白噪声的带子——它们就是候选异常。
三、工程实践要点
3.1 基于残差的异常检测流程
这是最标准的做法,四步:
- 分解,得到残差序列。
- 对残差做平稳性检验(残差理论上应近似平稳)。
- 用 Z-score、IQR 或分位数阈值在残差上找异常。
- 把异常映射回原始时间点,结合业务确认。
关键在于:残差的"正常范围"是相对稳定的,因为趋势和季节都被剥掉了。一个在原始序列里根本不起眼的"比同时段高 20%",在残差里可能已经越过 3 倍标准差——这才是检测该用的信号。
3.2 分解的常见坑
坑一:分解本身被异常污染。 经典分解对异常敏感,一个真实故障点会扭曲整段趋势估计,导致后续残差检测反而漏掉它。对策:先用稳健方法(STL)或先做一次粗筛,把明显异常值临时标记。
坑二:周期选错。 seasonal 参数填错(比如把 12 个月的数据填成 13)会产出假的季节成分,残差里全是"伪异常"。先用 ACF 或周期图确认真实周期。
坑三:数据不够长。 分解至少要 2–3 个完整季节周期,否则季节成分估计不稳。数据短就别硬分解,退回差分或直接检测。
⚠️ 常见坑:分解后直接对"趋势成分"做异常检测。 趋势本身是慢变量,拿它对突刺敏感度极低;反过来,残差里偶尔的大波动才是异常主场。别把注意力放在错误的分量上。
💡 关键直觉:分解的价值是"给异常做背景校正"。 同一个"订单量 8 万",在 5 月是正常高峰,在 3 月可能就是异常。分解 + 残差检测,本质是让系统自动学会"同时段该有的水平",这比任何手工规则都更适应数据漂移。
3.3 分解产物的复用
分解不只是为了检测。趋势成分可用于预测建模,季节成分可直接作为特征(第 2.4 节),残差可作为第 4 章统计检测、第 6 章深度检测的输入。一套分解,多处复用——这也是为什么值得把分解做得扎实。
3.4 加法与乘法模型的一个实例对照
假设某奶茶店月销售额,去年月均 8 万,季节波动约 ±2 万;今年生意翻倍,月均 16 万。如果季节波动还是"±2 万",那是加法模型——波动是绝对值,不随生意规模变化;如果季节波动变成"±4 万"(销售额越大,淡旺季差得越多),那是乘法模型——波动按比例放大。判断方法就一句:把序列画出来,看"高峰期的抖动幅度"和"低谷期的抖动幅度"是否差很多。 差得多,乘法;差不多,加法。实在判断不了,两个模型都跑一遍,比较残差哪个更接近白噪声——残差更"干净"的那个,就是更适合的。
3.5 分解与去噪、检测的完整衔接
把本章前两节串起来,一条标准流水线是:清洗缺失 → 平滑去噪(压噪声)→ 分解(剥趋势季节)→ 残差检测(抓异常)。 注意去噪和分解的分工:去噪处理的是"高频毛刺",分解处理的是"低频结构",两者作用于不同频带,不冲突。一个常见误区是"去噪去得够狠,就不用分解了"——事实正好相反:去噪再狠也剥不掉趋势和季节,而趋势季节正是让固定阈值失灵的主因。只有分解能回答"这个值在此时段算不算异常",去噪做不到。
还有一个常被忽略的实践细节:分解前先做一次"粗异常筛查",把明显离群点临时标记,能显著提升分解质量。 原因在于,一个孤立的巨大尖峰如果在移动平均或 Loess 拟合窗口内,会把整段趋势/季节估计往它那边"拽"一下,导致分解结果失真。做法很简单:先用 Z-score 粗筛一遍,把明显异常点的值临时替换成插值或直接用稳健方法(STL 天然抗一点),分解完成后再把真实值放回去做检测。这条"先筛后分解"的顺序,能让分解结果更接近真实结构,让残差检测更可信。
实战问答
问:分解一定要用 STL 吗?
不一定。经典分解简单快,但怕异常值;STL 稳健但计算稍重。检测流水线推荐 STL——因为"预处理本身不能被异常干扰"这条纪律,STL 的稳健性正好满足。数据简单、对精度要求不高时,经典分解也够用。
问:残差总是不像白噪声,说明什么?
说明分解没剥干净,可能原因有三个:周期参数填错、数据长度不足(少于 2–3 个完整周期)、或者序列里还有趋势的残余。先查这三个,别急着换检测方法。
问:多变量时间序列能分解吗?
标准分解(STL 等)针对单变量。多变量一般先逐通道分解,或用 PCA/矩阵分解处理通道间的关系。逐通道分解 + 残差拼接是最简单可行的做法。
问:分解后异常检测的"正常范围"怎么定?
对残差用 Z-score 或分位数:残差均值 ± k×标准差(k 取 2–3),或取残差分布的 95/99 分位。残差理论上已平稳,这个"正常范围"是相对稳定的——这正是分解给检测带来的最大红利。
温故知新
- 分解目的:理解模式、提升预测、简化异常检测;核心思想是"异常藏在残差里"。
- 加法 vs 乘法:季节波动幅度恒定选加法,随趋势放大选乘法;高时抖得厉害是乘法的信号。
- 经典分解简单但娇气——对异常敏感、要求周期固定;STL 用局部加权回归,稳健且允许季节渐变,是检测流水线的默认选择。
- 标准流程:分解 → 残差平稳性检验 → 残差阈值检测 → 映射回原始时间点。
- 常见坑:分解被异常污染、周期填错、数据长度不足——都会制造伪异常。
- 一套分解多处复用:趋势给预测、季节当特征、残差做检测。
下一节进入特征工程——分解出残差后,怎么把一段段序列变成模型能吃的特征矩阵?滞后特征、统计特征、时域/频域特征,加上特征选择,本节一次讲透。