4.1 阈值与规则
4.1 阈值与规则
本节摘要:基于阈值与规则的异常检测是最基础、最直观的方法:预先设定阈值或规则,越界即报警。本节讲清静态阈值与动态阈值(滑动窗口统计、EWMA、季节分解)的设定逻辑,规则定义的四种形态(简单比较、统计规则、状态转换、专家系统),并给出优点、缺点、适用场景与改进策略。结论:阈值规则是任何监控系统的第一道防线,但它的"简单"也是它的上限。
阅读收获
阅读完本节,你应当能够:
- 说出静态阈值与动态阈值的适用场景差异。
- 设计一个基于滑动窗口均值±k倍标准差的动态阈值方案。
- 用 EWMA 和季节分解两种思路让阈值"跟上数据的变化"。
- 定义至少两种组合规则(如 CPU>80% 且内存>90%)并说明逻辑。
- 识别阈值规则的结构性盲区,并说出改进方向。
一、问题与直觉
"把 CPU 使用率超过 90% 的告警去掉吧。"运维群里每天都有人提这种需求。定 90%,白天高峰期天天误报;定 95%,凌晨的低流量场景永远等不到告警。固定阈值的问题从来不是"设多少",而是"数据在动,阈值却不动"。
一家电商的订单量监控,晚上 8 点的峰值可能是凌晨 3 点的 30 倍。用一个固定值去卡全天,要么白天报疯了,要么夜里全漏掉。更麻烦的是季节:双十一当天订单量是平日的 50 倍——如果阈值不随"日期类型"调整,大促当天系统会把每笔订单都当异常。
阈值方法的全部优点都在它的简单:一条规则、一个比较、一个报警,几行代码跑完,值班员一看就懂。但它的全部上限也在这份简单里:它不知道"此时此刻正常应该是什么水平"。所以工程上的正确姿势不是"弃用阈值",而是"让阈值学会动"——用数据动态地给出"此刻的合理区间"。
这一节我们从静态阈值讲起,逐步升级到三种动态阈值方案,再讲规则(比阈值更强的表达力),最后老实交代它的盲区与改进方向。
二、核心原理
2.1 静态阈值:简单但有条件
静态阈值是"拍脑袋"设定固定值:CPU 超 90% 报警、温度超 80 度报警。适用范围只有一个——数据分布长期稳定。如果业务的量级、季节性、波动幅度几乎不变,静态阈值完全够用。
它的两个致命伤:对非平稳序列(量级在变)必然误报或漏报;对复杂模式(如上下文异常)完全无能为力。所以现代系统里静态阈值往往只作"最后一道物理底线"——比如温度超 100 度直接断电,这种"永远不该发生"的硬线。
2.2 动态阈值一:滑动窗口统计
思想:阈值不是全局固定值,而是由最近一个窗口的数据统计出来的。设窗口大小 w,当前时刻的阈值取"窗口内均值 ± k×标准差":
- w 决定"参照历史有多长":窗口太短,阈值跟着噪声乱跳;窗口太长,反应迟钝、跟不上业务变化。
- k 决定"多宽算正常":k=2 灵敏、k=3 稳健。结合业务对漏报/误报的容忍度选。
这个方案对"缓慢变化、没有强周期"的指标(如服务器负载、内存使用率)非常实用,实现也只需几十行代码。
2.3 动态阈值二:EWMA
滑动窗口对窗口内所有点等权,EWMA 则对近期数据赋更高权重,阈值能"更快地跟上去"。
流程:先用 EWMA 算出当前平滑值(相当于此刻的"预期水平"),阈值取"平滑值 ± k×残差标准差",新点与平滑值差超阈值即异常。
EWMA 的平滑系数 α 是灵魂:α 大,平滑值跟得紧、对变化敏感但也易受噪声干扰;α 小,平滑值稳、抗噪好但反应慢。对"渐变漂移型"异常(比如缓慢漏油导致的压力缓降),EWMA 配合残差阈值能在早期捕捉——这是固定阈值和滑动窗口都做不到的。
2.4 动态阈值三:季节分解
对强周期数据(日周期、周周期、年周期),前面两种方案都会在"周期的正常峰谷"处误报。解法:先做季节分解,把"同时段的季节水平"剥离掉,阈值基于残差设定。
流程:STL 分解 → 提取季节成分 → 阈值 = 季节水平 ± k×残差标准差 → 新点与季节水平的偏离超阈值即异常。这个方案把"上下文异常"也顺带解决了——冬季卖出夏季的量,残差会显著越界。代价是需要积累足够多完整周期才能稳定分解。
2.5 规则:比阈值更强的表达
规则是阈值的升级,能表达"组合条件"。四种形态:
- 简单比较规则:CPU>80% 且内存>90% 才算异常。用 AND/OR 组合多个条件,降低单一指标的误报。
- 统计规则:过去一周平均响应时间 > 历史均值的 2 倍 → 异常。把"历史对比"写进规则。
- 状态转换规则:服务连续切换错误状态超过 3 次 → 异常。捕捉"行为序列"而非单点。
- 专家系统规则:基于领域专家知识的一套规则库(如金融风控的"大额+夜间+新设备"组合)。
规则的价值在于可解释——每条规则都能直接翻译成业务语言,是给合规、风控、业务方解释的天然工具。代价是规则库维护成本高:业务变了要改规则,异常模式变了要加规则,规则之间还可能互相冲突。
三、工程实践要点
3.1 按数据特征选阈值方案
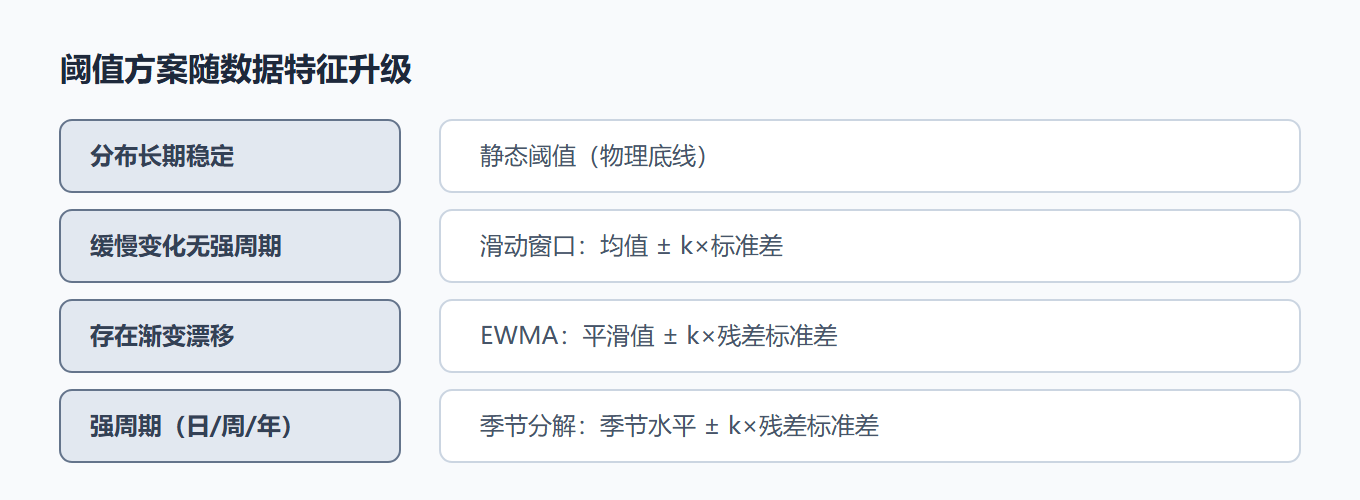
| 数据特征 | 推荐方案 | 关键参数 |
|---|---|---|
| 分布长期稳定 | 静态阈值 | 固定值 |
| 缓慢变化、无强周期 | 滑动窗口 | 窗口 w、倍数 k |
| 有渐变漂移 | EWMA | 平滑系数 α |
| 强周期(日/周/年) | 季节分解 | 周期长度 |
| 多指标联合判断 | 组合规则 | 各条件阈值与逻辑 |
3.2 阈值方法的结构性盲区
必须诚实面对阈值规则的三个天花板:一是抓不住"上下文异常"——值本身正常,只是放错时段,单一阈值无法表达"这个值在冬天不对";二是抓不住"渐变型"——每天恶化一点点,始终在阈值内;三是规则库维护爆炸——异常模式一多,规则之间开始打架。
改进方向:自适应阈值(用机器学习学阈值)、集成多种规则、与统计/机器学习模型组合(阈值做初筛,模型做复核)。阈值永远值得保留,但应定位为"第一道防线",而不是"最终答案"。
⚠️ 常见坑:把阈值调来调去治标不治本。 某团队一年改了 20 次 CPU 告警阈值,误报依旧——因为问题根本不在于阈值大小,而在于"CPU 基线随业务在涨"这个事实没被建模。动态阈值(或去趋势)才是解法,调固定值只是在给错误的模型打补丁。
💡 关键直觉:阈值方法的本质是"定义正常的区间"。 静态阈值定义的是"全局正常区间",动态阈值定义的是"此刻的正常区间"。区间定义得越贴合数据规律,误报漏报越少——所有阈值升级的本质,都是让"正常区间"更贴合真实规律。
3.3 落地检查清单
- 画一下数据,判断量级是否稳定、有没有强周期。
- 按上表选方案,先用保守参数(k=3 起)跑一周。
- 记录误报与漏报,逐个复盘是"阈值太松/太紧"还是"方案根本不适合"。
- 确认方案适用后再谈参数调优,别倒过来。
3.4 阈值规则在监控体系中的定位
把阈值规则放进一个完整的监控体系里看,它的定位非常清晰:它是"第一道防线",不是"最终答案"。 成熟的监控体系通常是三层:第一层阈值规则(毫秒级、兜物理底线——比如温度超 100 度直接断电);第二层 SPC/统计模型(第 4.2 节,识别渐变与均值偏移);第三层机器学习/深度学习(处理复杂组合模式)。每一层覆盖它擅长的异常类型,阈值规则的价值在于"永远不缺席"——即使更聪明的模型挂了,它还在兜底。
这也是为什么即使你最终要上深度学习,也不该删掉阈值层:它是最后一道物理保险。很多生产事故复盘发现,如果阈值层没被删掉,事故根本不会发生——因为深层模型可能会漏报,而阈值层只要还在,物理极限的异常就一定会被拦下。
3.5 规则引擎的工程化
当规则多到一定程度(几十条以上),就要考虑"规则引擎"而不是散落的 if-else 了。规则引擎的要点:规则可配置化(业务改阈值不用改代码);规则带优先级与命中统计(知道哪些规则在真正干活);规则可灰度(新规则先小流量试跑再全量)。规则库是一笔会持续维护的资产——业务在变,异常模式在变,规则库必须跟着演进。这也是为什么"规则 + 统计/模型"的混合架构在工业界长盛不衰——规则库负责沉淀确定性知识,模型负责覆盖不确定性模式。
实战问答
问:动态阈值里的窗口大小怎么选?
窗口要覆盖"你要参照的正常历史"的量级:日周期数据用至少 24 小时的窗口,周周期至少一周。窗口太短,阈值跟着噪声乱跳;太长,反应迟钝、跟不上业务变化。 从"一个完整周期"起步,按效果微调。
问:阈值和规则是不是"太土了"?
恰恰相反,"土"是它的优点——可解释、可审计、零门槛。现代监控系统里阈值规则依然是标配的第一层,只是不再是唯一一层。把阈值规则和更聪明的模型结合,才是成熟的做法。
问:规则之间冲突怎么办?
规则引擎需要"冲突消解"机制:给每条规则设优先级,高优先级先判定;或者设"聚合规则"——多条弱信号规则同时命中才算异常(如"金额>阈值 且 夜间 且 新设备")。冲突消解是规则库从"能跑"走向"可维护"的关键。
问:阈值方法能处理"渐变型"异常吗?
固定阈值不能,但 EWMA 动态阈值可以——平滑值跟得上缓慢漂移,残差会逐渐越界报警。这就是为什么动态阈值比固定阈值高级:它让"正常区间"跟着数据动。
温故知新
- 静态阈值只适用于分布长期稳定,现代系统里多当"物理底线"用。
- 三种动态阈值:滑动窗口(均值±kσ)、EWMA(跟上渐变)、季节分解(处理强周期与上下文异常)。
- 规则比阈值表达力强:简单比较、统计规则、状态转换、专家系统,天然可解释。
- 三个结构性盲区:上下文异常、渐变型异常、规则库维护——改进靠自适应阈值与模型组合。
- 阈值方案按数据特征选:稳定用静态,缓变用滑动窗口,渐变用 EWMA,强周期用季节分解。
- 阈值是"第一道防线",不是"最终答案";调阈值前先确认方案与数据规律匹配。
下一节把"动态阈值"的思想发扬光大——统计过程控制 SPC 给"正常区间"提供了百年沉淀的工业级标准:中心线、控制限、3-sigma,制造业用它守了几十年质量线。