4.4 密度与距离LOF与DBSCAN
4.4 密度与距离 LOF 与 DBSCAN
本节摘要:基于密度与距离的异常检测不假设数据分布,正常点聚集在高密度区、异常点孤立在低密度区。本节深入两个代表算法:LOF(局部离群因子)通过比较点与邻居的局部密度判异常,DBSCAN(基于密度的空间聚类)把低密度噪声点直接当异常。讲透 LOF 的可达距离、局部可达密度、离群因子三步计算,DBSCAN 的核心点/边界点/噪声点模型与 eps/minPts 参数逻辑,并给出参数调优方法。
本节地图
阅读完本节,你应当能够:
- 说出密度类方法相对分布假设方法的核心优势。
- 解释 LOF 的"局部"二字为何关键——它能抓全局方法漏掉的局部异常。
- 按"找近邻→算可达距离→算局部可达密度→算离群因子"四步描述 LOF。
- 说清 DBSCAN 的 eps、minPts 两个参数的含义与调整方向。
- 区分 LOF 与 DBSCAN 的适用场景并给出选型建议。
一、问题与直觉
一栋写字楼有 500 台服务器,某机房角落的一台机器,CPU 使用率的波动形态和整栋楼的"主流行为"完全不同——不是突发尖峰,而是整天在正常范围内的异常抖动。如果用全局 Z-score 检查,它的所有值都在 3σ 内,完美"正常"。但放到它自己那 8 台邻居的局部环境里看,它明显是"异类"。
这就是"局部异常"和"全局异常"的区别。 全局方法问"你离整片数据的中心多远",密度方法问"你的邻居都这么过日子吗"。一个点完全可以全局正常、局部异常——比如一个游客误入了一片低密度区域,但全城范围看他的位置很平常。
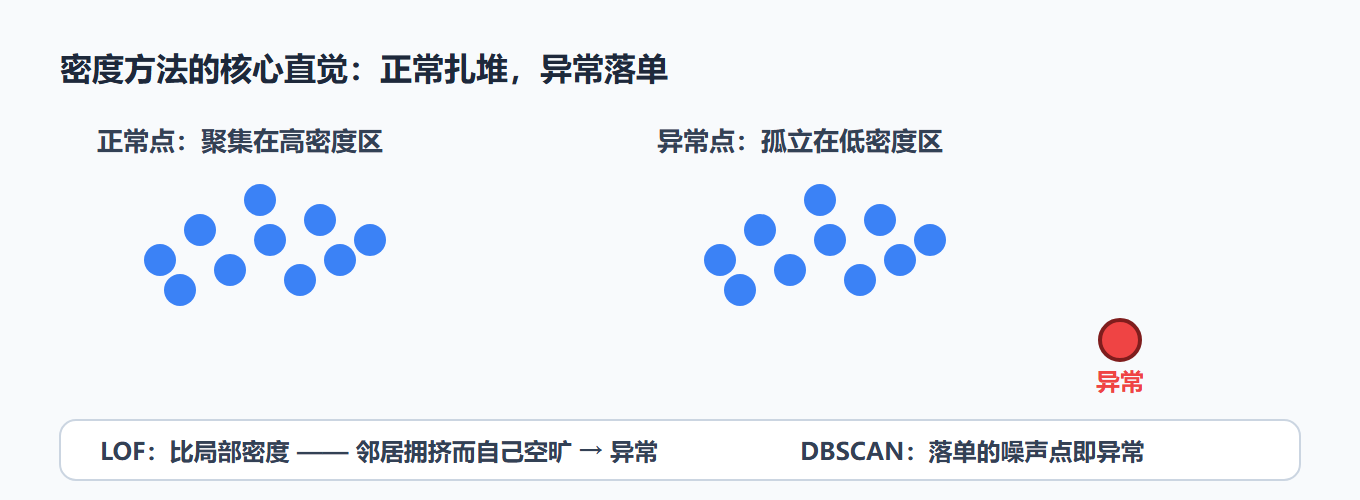
LOF 和 DBSCAN 就是为这种问题设计的。它们的基本信条很朴素:正常点扎堆,异常点落单。 扎堆不是"数值接近某个均值",而是"周围密度高";落单不是"值大或小",而是"周围密度低"。
它们彻底告别了"假设数据服从某分布"的包袱——数据是什么形状都行:环形簇、月牙形、S 形,密度方法都不在乎。代价是参数敏感:邻居数 k、邻域半径 eps、最小点数 minPts,每个都直接改变"什么算异常"。
二、核心原理
2.1 LOF:比一比你和邻居的密度
LOF(Local Outlier Factor)的核心思想一句话:如果你的局部密度远小于你邻居的局部密度,你就是异常。
三步计算:
第一步:确定邻域。 对每个点找它的 k 个最近邻。k 是关键参数:太小,只看到极近的邻居,密度估计不稳;太大,把远处的点也算进来,"局部"变成"全局"。经验上 k 取 10–20 起步。
第二步:算可达距离与局部可达密度。 点 A 到点 B 的可达距离定义为:
reachdist(A, B) = max( 距离(A,B), B到其第k近邻的距离 )
它保证"离得再近也不会比 B 的 k 距更近"——相当于给距离设了个"地板",稳定了密度估计。然后:
局部可达密度 lrd(A) = 1 / ( A 的 k 个邻居的可达距离之和 / k )
lrd 越大,说明 A 周围越"挤",密度越高。
第三步:算离群因子。
LOF(A) = ( A 的邻居们的 lrd 平均值 ) / lrd(A)
LOF ≈ 1:你和邻居密度差不多,正常。LOF 远大于 1:你周围空旷、邻居周围拥挤,你是异常。LOF 本身就是"异常程度"的连续评分,阈值设多少可以结合业务调——这也是它比"非黑即白"的判定更实用的地方。
LOF 为什么"局部"值钱? 全局方法(如全局 Z-score)在"数据有多簇不同密度的正常点"时必然误判——低密度簇里的正常点会被全局阈值当成异常。LOF 只跟自己的邻居比,天然免疫这个问题。
2.2 DBSCAN:密度相连画簇,落单的是噪声
DBSCAN(Density-Based Spatial Clustering of Applications with Noise)本是聚类算法,但它的"噪声点"输出直接就是异常检测结果。核心模型是三种点:
- 核心点:eps 邻域内的点数 ≥ minPts。
- 边界点:落在某核心点的 eps 邻域内,但自己不满足核心点条件。
- 噪声点:既不是核心点,也不在核心点邻域内——噪声点即异常。
图:正常扎堆、异常落单的直观对比
两个参数:
- eps(邻域半径):多大范围内算"邻居"。太小 → 很多正常点变噪声(误报);太大 → 不同簇连成一片,异常点也被拉进簇里(漏报)。
- minPts(最小点数):多少点算"够密集"。太小 → 稀疏正常区被误标噪声;太大 → 密集区也可能不达标。
DBSCAN 的优点:不需要预先知道簇数量、能发现任意形状的簇、顺带输出噪声点。缺点:对 eps/minPts 极度敏感、密度差异大的数据集难调、计算复杂度高。
2.3 LOF vs DBSCAN 对比
| 维度 | LOF | DBSCAN |
|---|---|---|
| 核心参数 | 邻居数 k | eps、minPts |
| 输出 | 连续异常分数 | 簇划分 + 噪声点 |
| 局部性 | 只比邻居,强 | 看局部密度,较强 |
| 多密度数据 | 能处理(局部比较) | 难(全局 eps 难兼顾多密度) |
| 已知簇数量 | 不需要 | 不需要 |
| 调参难度 | 中(k 一个) | 高(eps/minPts 两个且敏感) |
| 适用场景 | 密度差异大的复杂数据 | 簇结构清晰、噪声分离明显的场景 |
选型一句话:数据有多个不同密度的正常区、只要"异常评分" → LOF;数据簇结构清晰、想"顺带把正常聚成簇" → DBSCAN。时序场景里 LOF 更常用——因为传感器数据往往密度不均匀,而且我们要的是"偏离程度"这个连续评分,好配阈值。
2.4 时序数据用密度方法的正确姿势
密度方法处理的是"点",时序数据天然带顺序——直接对原始序列跑 LOF/DBSCAN,会把"正常的趋势段"和"正常的高频波动"误判。标准姿势是:先特征化/分解,再跑密度方法。 把每个时间点转换成特征向量(比如 [滑动均值, 滑动标准差, 与同时段的偏差]),或直接用第 2 章的残差序列,再对特征向量跑 LOF/DBSCAN。密度方法看的是"特征空间里的密度",不是"时间轴上的数值"。
三、工程实践要点
3.1 参数调优的实操套路
LOF 的 k:从 10 开始,看异常分数分布的稳定性;分数普遍稳定了就差不多。DBSCAN 的 eps:画 k 距离图(每个点到第 k 近邻的距离排序),找"拐点"作为 eps 的候选——拐点左边是密集区、右边是稀疏区,正好是密度分界。minPts 一般取特征维度的 2 倍起步。
3.2 密度方法的天然优势场景
它特别擅长抓"形状异常"。 一个传感器阵列,正常情况下读数构成一个"甜甜圈"形状的簇,某天一个通道漂移出环外——Z-score 抓不到(环的中心远着呢),密度方法一抓一个准。任何"正常不是简单集中、而是复杂形状"的场景,都是密度方法的主场。
⚠️ 常见坑:对高维特征直接跑 LOF/DBSCAN。 维度高了以后"距离"的意义迅速衰减(所有点都差不多远),密度方法的判别力崩坏。先降维(PCA)或特征选择(第 2.4 节),把维度压到 10 以内再跑。
💡 关键直觉:LOF 与 DBSCAN 的"密度"本质是"相似性"。 什么叫密度高?就是"周围有很多跟我像的点"。所以它们的质量上限取决于你用什么距离度量——换距离度量(欧氏、马氏、DTW)等于换了一双看数据的眼睛。
3.3 与其他方法衔接
密度方法常做"复核"角色:先用统计/预测方法粗筛,把"边缘样本"送进 LOF 复核,降低粗筛的误报。也可以把 LOF 的异常分数直接作为第 5 章集成学习的基模型之一——它的"局部性"视角恰好和 Isolation Forest 的"全局隔离难度"视角互补。
3.4 参数调优的实操套路
LOF 的 k:从 10 起步,画"异常分数分布图"看稳定性。如果分数分布稳定(多跑几次差不多),k 就合格;如果分数抖动大,加大 k。一个经验:k 太小,密度估计被几个邻居"绑架",太敏感;k 太大,"局部"变成"全局",丢掉局部异常。 10–20 是常见甜区。
DBSCAN 的 eps:画"k 距离图"——把每个点到第 k 近邻的距离排序画出来。拐点(曲线从陡峭变平缓的地方)就是密度分界,拐点对应的距离就是 eps 的好候选。minPts 从特征维度的 2 倍起步,维度低就 3–5,维度高适当加大。
一个通用检查:调完参,把检测结果可视化——异常点画出来,人工确认"它们看起来确实像异常";如果异常点明显聚集在某个奇怪角落,多半是参数没调对,而不是数据真异常。密度方法的结果必须"肉眼可见地合理",否则宁可不调。
3.5 时序数据用密度方法的一个完整例子
假设你要监控一套园区供暖系统,10 个换热站,每个站有温度、压力、流量三个通道。正常运行时,各站的"运行模式"因负荷不同而分散在特征空间的不同区域。做法:
- 特征化:对每个站每个小时,构造特征向量 [温度均值, 压力标准差, 流量与历史同时段偏差, 设备负载率],共 4 维。
- 标准化:Z-score 标准化,消除量纲。
- 跑 LOF:k=15,计算每个"站-小时"组合的 LOF 分数。
- 标定阈值:取训练期 LOF 分数分布的 95 分位为阈值(或按业务对误报的容忍度定)。
- 报警与复核:LOF 超阈值的时段进工单,现场工程师确认。
这套做法的关键:把"时间点"变成"特征向量",密度方法才能看懂"行为模式"而不是"数值高低"。它特别擅长发现"某个站在自己的历史行为里突然变成异类"这类局部异常——比如某站的压力波动模式整个变了,但数值仍在正常范围,Z-score 永远发现不了,LOF 一抓一个准。
实战问答
问:LOF 和 Isolation Forest 有什么区别?
LOF 是"局部密度比较"——只跟邻居比,擅长多密度数据;Isolation Forest 是"全局孤立难度"——随机分割看谁先被切出来,擅长高维。两者盲区互补,常组队用(第 5.4 节分数合成)。
问:密度方法能处理高维特征吗?
直接处理不行——高维下"距离"的意义迅速衰减,所有点都差不多远。先降维(PCA)或特征选择(第 2.4 节),把维度压到 10 以内再跑。
问:LOF 的分数直接当异常评分用,还是转成 0/1?
先当连续评分用——LOF 本身就是"异常程度"的连续度量,阈值由业务代价定(第 1.3 节)。直接转 0/1 会丢掉"多可疑"这个信息,也限制了后续与别的模型做分数合成。
问:数据正常样本和异常样本密度差异不大,密度方法还行吗?
效果会打折扣——密度方法的前提就是"正常扎堆、异常落单",密度差异不明显时它没有判别力。这种数据建议改用预测残差类方法(ARIMA/LSTM)或监督学习。 方法的前提不满足,就换方法,别硬撑。
核心回顾
- 核心信条:正常点扎堆、异常点落单——不假设分布,能处理任意形状的簇。
- LOF 三步:找 k 近邻 → 算可达距离与局部可达密度 → 离群因子(邻居密度均值/A 密度);LOF 远大于 1 即异常。
- LOF 的"局部"价值:多密度数据下不会把低密度簇的正常点误判,这是全局方法的死穴。
- DBSCAN 三态:核心点、边界点、噪声点;噪声点即异常;eps/minPts 敏感,用 k 距离图找拐点定 eps。
- 时序姿势:先特征化/分解,再对特征向量跑密度方法;高维先降维。
- 选型:多密度要连续评分用 LOF,簇结构清晰想聚类用 DBSCAN;LOF 的局部视角适合当集成基模型。
下一章换一个完全不同的思路——不靠密度,靠"模型学习"。机器学习异常检测技术登场:监督、无监督、半监督三套打法,数据标签的多少决定你走哪条路。