5.3 半监督方法One-Class与隔离森林
5.3 半监督方法 One-Class 与隔离森林
本节摘要:半监督异常检测只用正常数据训练,学"正常的样子",偏离即异常——这是异常检测里最贴合现实、性价比最高的范式。本节讲透两大主力:One-Class SVM(学一个把正常数据包起来的边界)与 Isolation Forest(度量"把点孤立出来需要几次分割")。核心区别:OCSVM 画"正常边界",隔离森林量"孤立难度"。并给出 scikit-learn 示例、参数要点与选型建议。
读前必看
阅读完本节,你应当能够:
- 解释半监督范式"只学正常"为何最贴合异常检测的现实。
- 说出 One-Class SVM 的核心假设(正常聚集、异常在外)与参数(nu、kernel、gamma)的作用。
- 理解 Isolation Forest"异常更易被孤立、路径更短"的直觉。
- 用 scikit-learn 完成 Isolation Forest 与 One-Class SVM 的检测并解读结果。
- 在 OCSVM 与 Isolation Forest 之间按数据特征做选型。
一、问题与直觉
运维团队攒了整整一年的监控数据——2000 万条,全是"系统正常运行"的记录。异常样本呢?个位数。过去一年只出过三次真故障,每次都来不及标注就恢复上线了。
这就是异常检测的普遍窘境:正常数据要多少有多少,异常数据凤毛麟角。 监督学习在这条赛道上注定跑不起来——它需要"两类样本都充足";无监督能跑,但它把"正常结构"和"潜在异常"混在一起学,分辨力有限。
半监督范式抓住了这个现实:既然异常样本稀缺,那我干脆只学"正常",把"正常"的边界定义清楚,边界之外的统统当异常。 这个思路的三步:
- 收集(大量)正常数据。
- 让模型只从正常数据里学"正常长什么样"。
- 新数据来了,问一句:"你像不像我学过的正常?" 不像,就是异常。
"像不像正常"有两种度量方式,正好对应本节的两个主角。 One-Class SVM 问的是"你在不在正常的边界内";Isolation Forest 问的是"把你从人群中分出来需要费多大劲"。一个画边界,一个量孤立难度——殊途同归,但手感完全不同。
二、核心原理
2.1 One-Class SVM:圈一块"正常"的地盘
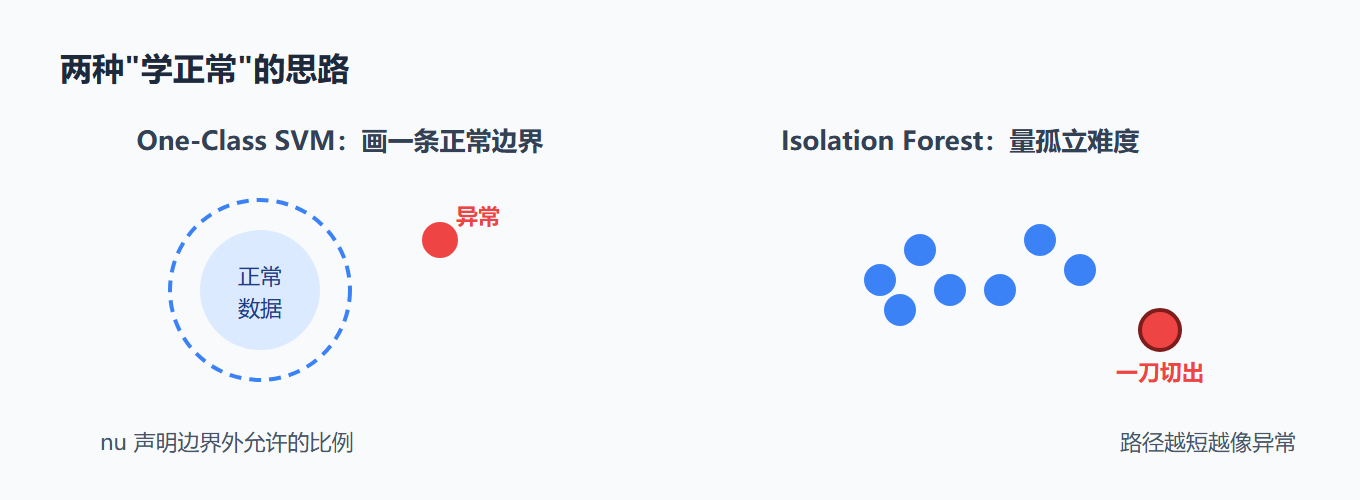
One-Class SVM 在特征空间里找一个决策边界(超平面/超球),把尽可能多的正常数据圈在里面,同时让边界尽可能紧。边界内的点判正常,边界外的点判异常。
三个关键参数:
- nu:控制"边界外允许的点比例"——也就是模型预期的异常占比。nu=0.05 意味着模型允许约 5% 的训练点落在边界外(视为"污染")。nu 是对异常率的一个先验声明。
- kernel:核函数。默认 RBF 核可以处理非线性边界;数据量大时可用线性核加速。
- gamma:RBF 核的宽度。gamma 大,边界紧贴训练点、可能过拟合;gamma 小,边界平滑、可能欠拟合。
OCSVM 的思路和"用统计定义正常"一脉相承,只是边界可以是非线性、数据驱动的。它的弱项:对高维数据、大数据集,训练慢且边界难调。
2.2 Isolation Forest:异常的宿命是被快速孤立
Isolation Forest 的直觉非常妙:异常点"另类",所以更容易被单独切出来。
它构建一批隔离树(iTree),每棵树递归地随机选一个特征、随机选一个分割点,把数据一分为二,直到每个点都被隔离。对每个点统计它"被完全隔离所需的分割次数"(路径长度):
- 正常点:淹没在人群里,要切很多刀才能单独拎出来,路径长。
- 异常点:特征值太出格,一两刀就切出来了,路径短。
图:画边界 vs 量孤立难度
关键参数:
- n_estimators:隔离树数量。默认 100,多了更稳、慢了;少了不稳。
- contamination:预期的异常占比。设 "auto" 自动估计,或给具体值(如 0.01)直接决定"最异常的那 1% 是哪些"。
Isolation Forest 的优势:线性复杂度、天然抗高维(每刀只看一个特征,不受"高维距离坍缩"影响)、内存友好。这是它成为工业界最常用检测器之一的原因。
2.3 一个可运行示例
from sklearn.ensemble import IsolationForest from sklearn.preprocessing import StandardScaler import numpy as np # X 为特征矩阵(只有正常数据参与训练) scaler = StandardScaler() X_scaled = scaler.fit_transform(X) iso_forest = IsolationForest(n_estimators=100, contamination='auto', random_state=42) iso_forest.fit(X_scaled) # 预测:1 表示正常,-1 表示异常 y_pred = iso_forest.predict(X_scaled) anomalies = np.where(y_pred == -1)[0] print("Anomalies:", anomalies)
from sklearn.svm import OneClassSVM ocsvm = OneClassSVM(nu=0.05, kernel="rbf", gamma=0.1) ocsvm.fit(X_scaled) # 输出为 1(正常)或 -1(异常)
两个示例的共同点:训练阶段只喂正常数据(或未经标注的数据),模型学的是"正常"的概念。 这与监督学习(喂两类标签)有本质区别。
2.4 OCSVM vs Isolation Forest 选型
| 维度 | One-Class SVM | Isolation Forest |
|---|---|---|
| 核心假设 | 正常聚在边界内 | 异常易被孤立 |
| 边界形态 | 非线性(RBF) | 无显式边界 |
| 高维数据 | 差(距离坍缩) | 好(逐特征分割) |
| 大数据量 | 慢 | 快(线性复杂度) |
| 参数 | nu、kernel、gamma | n_estimators、contamination |
| 适用场景 | 低维、数据量适中、要显式边界 | 高维、大数据、通用首选 |
选型一句话:高维大数据 → Isolation Forest(几乎无脑选它);低维小数据、想看到"正常区域长什么样" → One-Class SVM。
三、工程实践要点
3.1 "contamination" 是业务决策,不是技术参数
Isolation Forest 的 contamination 和 OCSVM 的 nu,本质是同一个问题:"你预期异常占多少比例?" 这个数字应该来自业务统计(过去一年异常率约 1%),而不是随便填。填错的影响是系统性的:contamination=0.01 意味着"即使全是正常数据,也会强制挑出最奇怪的 1%"。contamination 别调得太"贪心",否则系统会主动找茬。
3.2 半监督是"正常边界"的看门人
半监督模型只认识训练期见过的"正常"。两个结构性风险必须知道:
- 概念漂移:业务变了,原来的"正常"不再是正常——比如新上线了大促,流量形态全变,半监督模型会把"新常态"当异常刷屏。对策:定期重训,或用滑动窗口滚动更新"正常"。
- 训练数据污染:训练集里混入了未标注的异常,模型会把异常学成"正常",永久漏报。对策:训练前先用无监督粗筛一遍,剔除明显异常点。
3.3 与特征工程的配合
半监督模型同样依赖特征质量。对时序数据,强烈建议:先分解/差分,把趋势季节剥离,再用残差/特征向量喂给半监督模型。 否则"正常的趋势"会被模型当成"正常形态",趋势期内的真异常反而被判定为"符合正常"。
⚠️ 常见坑:把 Isolation Forest 当"无监督"直接用,结果训练数据里全是未标注异常。 隔离森林的目标是"孤立出训练集里最出格的点"——如果训练集本身脏,它只是帮你找"最脏的点",而不是"业务意义上的异常"。训练数据越干净,半监督结果越可信。
💡 关键直觉:半监督问的是"像不像正常",不是"是不是异常"。 前者的参照系是"正常的样子"(可无限采集),后者的参照系是"异常的样子"(永远稀缺)。半监督把问题从"定义异常"偷换成"定义正常",而这个偷换正是它能在现实里落地的原因。
3.4 生产落地节奏
半监督是检测系统的"黄金第一模型":成本低、见效快、无需异常标签。标准节奏:先用 Isolation Forest 跑起来 → 报警人工复核 → 复核结果沉淀成标签 → 异常样本攒够后演进到监督模型。半监督不但是方案,还是通往监督学习的"标签孵化器"。
3.5 Isolation Forest 在工程里的完整落地示例
以一家 CDN 厂商的节点质量监控为例,展示 Isolation Forest 的完整落地:
- 数据准备:每个 CDN 节点每 5 分钟上报延迟、可用率、回源成功率、连接数四个指标。取最近 30 天正常时段的指标做训练集。
- 特征构造:每节点每时刻构造特征向量 [延迟均值, 延迟抖动(标准差), 可用率, 回源成功率, 与 1 小时前的同时段偏差],标准化。
- 训练:
IsolationForest(n_estimators=200, contamination=0.01)训练。contamination=0.01 意思是"预期异常占比 1%"——这个数字来自过去 30 天的人工统计。 - 打分:对每个"节点-时刻"输出异常分数(decision_function,越负越异常)。
- 阈值与报警:把分数低于某个百分位(如 1 分位)的标记为异常,进告警队列。
- 人工闭环:运维工程师确认后,把确认结果回流成标签,为未来演进监督模型做准备。
这个流程的关键决策点有两个:contamination 是"业务统计"不是"技术参数"(第 1.3 节代价矩阵的落地);报警阈值要按业务对误报的容忍度调——CDN 场景误报会打扰值班,阈值偏保守;而"节点彻底挂了"这种恶性事件阈值偏灵敏。
3.6 半监督的运维体检清单
上线半监督系统后,按周过一遍体检清单:训练数据是否还"干净"(有没有把最近的异常学进去,要定期剔除并重训);概念漂移是否发生(业务有没有大变化,报警是不是开始刷屏);contamination 是否还成立(异常率是不是变了);漏报是否集中在某类(是就查特征或升级模型)。四个问题每周过一遍,半监督系统才能长期稳定。
实战问答
问:Isolation Forest 为什么能"线性复杂度"?
因为每棵隔离树只做一件事:随机选特征、随机切分、递归分裂——每步只处理一个特征,不计算全样本距离,所以复杂度接近线性,大数据集也扛得住。这就是它比 LOF(要算 k 近邻距离)快的原因。
问:One-Class SVM 的 nu 和 Isolation Forest 的 contamination 是一回事吗?
本质是同一个问题:"预期异常占比多少"。nu 和 contamination 都来自业务统计,不是随手填的技术参数。区别只在于:nu 还影响 SVM 的边界松紧,contamination 主要决定"最异常的那百分之几是谁"。
问:半监督模型能检测"没见过"的异常吗?
能——这正是它的优势。半监督学的是"正常",任何偏离正常的(不管见没见过)都会报警。代价是"新常态"(业务变化)也会被当异常,要靠概念漂移监控和重训来管理。
问:训练"正常"数据需要多少量?
取决于特征维度。经验:特征 10 维以内,几千条正常样本起步;维度越高要求越多。但量不是唯一标准,"代表性"更重要——训练数据要覆盖各种正常的运行模式(不同负荷、不同时段),否则漏覆盖的模式会被当成异常。另一个容易忽视的点是"时间分布":只拿最近一周的正常数据训练,模型就"只认识这一周的正常",业务季节切换时误报会明显上升——尽量让训练数据跨过至少一个完整周期。如果历史数据里混着未标注的异常,也要先粗筛剔除,否则半监督会把异常学成正常,埋下永久漏报的隐患。
要点串联
- 半监督范式:只学正常,边界外即异常;最贴合"正常多、异常少"的现实。
- One-Class SVM:画正常边界,nu 声明异常比例、RBF 核处理非线性、gamma 控边界松紧。
- Isolation Forest:度量"孤立难度",路径短即异常;线性复杂度、天然抗高维,工业首选。
- 选型:高维大数据用隔离森林,低维要显式边界用 OCSVM。
- 两个结构性风险:概念漂移(定期重训)、训练数据污染(训练前粗筛)。
- 半监督是通往监督学习的"标签孵化器"——先跑量,再演进。
下一节,我们给模型"组队"——集成学习。单个模型有盲区,Bagging 压方差、Boosting 降偏差、Stacking 异构互补,多模型组合常常比任何单打独斗都更抗揍。