6.3 自编码器AE与VAE
6.3 自编码器 AE 与 VAE
本节摘要:自编码器(AE)通过"压缩-还原"学习正常数据的表示,重构误差即异常评分;变分自编码器(VAE)把潜变量建模成概率分布,还能用生成概率判异常。本节讲透 AE 的编码-解码结构与压缩原理、VAE 的概率化改进、三种检测玩法(重构误差、潜空间距离、生成概率),并给出基于 TensorFlow/Keras 的窗口化检测示例与超参数门槛。
先说结论
阅读完本节,你应当能够:
- 解释自编码器"压缩-还原"的机制与"只学正常"的检测范式。
- 区分 AE 与 VAE 在潜变量建模上的本质差异。
- 说出重构误差、潜空间距离、生成概率三种检测玩法。
- 理解把时序切成窗口、再逐窗口检测的流水线。
- 客观列出 AE/VAE 在时序检测里的门槛(超参数、噪声敏感、数据量)。
一、问题与直觉
想象你要给一台电梯的电机做"行为画像"。正常运行时,电机转速曲线有规律:加速、匀速、减速、停止。如果让一个模型学会"把正常转速曲线压缩成一小段代码,再把它还原",会发生什么?
- 对正常曲线:模型很熟悉,压缩再还原,几乎原样。
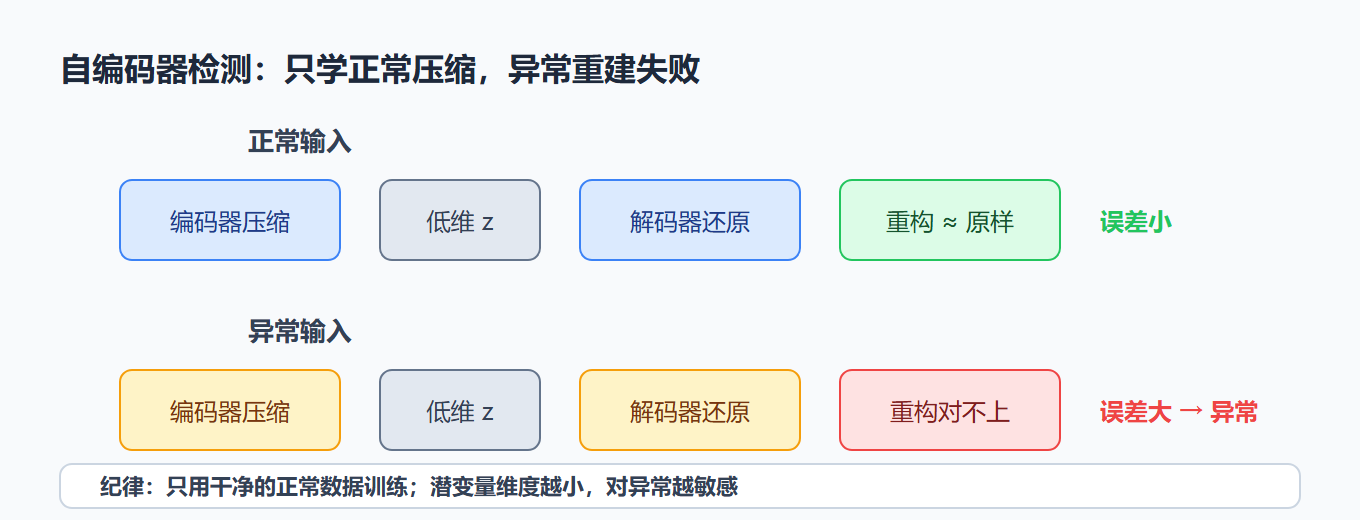
- 对异常曲线(比如轴承卡滞导致的转速抖动):模型从没见过这种形态,压缩时"塞不下",还原时"对不上"——重构出来的曲线和原始曲线差一大截。
这个"差一大截"的程度,就是自编码器的异常评分。自编码器的全部思想就一句话:正常的数据是"可压缩"的,异常破坏了这种可压缩性。 它的优雅之处在于:不需要任何标签,只用正常数据训练,就能学会"正常长什么样",然后用"重构失败的程度"来度量异常。
这个思想和第 5 章的 PCA 一脉相承——PCA 是"线性版本"的自编码器,自编码器是"非线性版本"。但自编码器的表达力强得多:它能学任意复杂的正常模式,这正是它在数据量大、模式非线性时受欢迎的原因。
二、核心原理
2.1 AE 的结构:压缩-瓶颈-还原
自编码器分两半:
- 编码器:把输入 x 压缩成低维潜变量 z。
z = f(x),z 的维度远小于 x。这个"瓶颈"强迫模型只保留最关键的信息。 - 解码器:把 z 还原成 x'。
x' = g(z)。
训练目标:最小化重构误差 ||x - x'||。但只喂正常数据——所以模型学到的是"正常数据的压缩规律"。
检测时:新数据 x 的重构误差大,说明它不符合"正常数据的压缩规律",判异常。
图:重构误差——异常在"压缩-还原"中现形
2.2 从 AE 到 VAE:给潜变量加上"概率"
AE 的潜变量 z 是一个确定的向量。VAE 的改进:把 z 建模成一个概率分布(通常假设高斯),编码器输出的是分布的参数(均值、方差),解码器从这个分布里采样再还原。
这个改动带来两个新能力:
- 生成能力:从学习到的分布里采样 z,解码器能"造出"新的、看起来正常的数据——用于数据增强或生成"正常样本"。
- 新的检测玩法:不只重构误差,还能算"这个数据在正常分布下的生成概率"——概率低即异常。
VAE 的代价:训练更复杂(要优化变分下界),且生成的数据可能模糊(因为采样引入了随机性)。
2.3 三种检测玩法
| 玩法 | 原理 | 特点 |
|---|---|---|
| 重构误差 | x' 与 x 差异大即异常 | 最常用、直观,但对噪声敏感 |
| 潜空间距离 | 新数据的 z 偏离正常 z 的分布即异常 | 在"表示层"看异常,更紧凑 |
| 生成概率 | 新数据在正常分布下的概率低即异常 | VAE 特有,给出概率语义 |
工程实践上,重构误差最常用,潜空间距离常作为补充视角——两者看的是不同的东西:重构误差看"还原得不像",潜空间距离看"被编码成什么了"。
2.4 时序数据的处理:先切窗,再检测
自编码器(尤其全连接版)不直接接受"任意长度的序列",标准做法是把时序切成固定长度的窗口:
import numpy as np # 假设 data 是长度为 N 的一维序列 # 用滑动窗口切成 (N-W+1, W) 的二维数组,W 为窗口长度 def make_windows(data, win): return np.array([data[i:i+win] for i in range(len(data)-win+1)]) # 训练:只用正常段的窗口 X_train = make_windows(normal_data, win=64) # 检测:新数据逐窗口算重构误差,超阈值即异常
窗口长度 W 是关键参数:太短装不下模式,太长让异常段被正常部分"稀释"。经验上取"异常持续时间的 1–2 倍"。 检测时逐窗口打分,再把连续窗口的高分段映射回原始时间轴。
2.5 AE/VAE 在时序检测里的定位
AE/VAE 是深度无监督检测的"主力军":只用正常数据、自动学特征、无监督——完美避开异常标签稀缺的痛点。但它也有三个硬门槛:
- 超参数敏感:窗口长度、潜变量维度、层数、学习率,都直接影响"什么算异常"。
- 对噪声敏感:重构误差把"噪声"和"真异常"都算进去,数据要先去噪(第 2.2 节)。
- 需要足够数据:太少的正常样本学不出可靠的"压缩规律",欠拟合。
三、工程实践要点
3.1 一个可运行的最小示例
用 TensorFlow/Keras 建一个全连接自编码器(概念性片段):
# 概念片段:编码器+解码器 # input_dim: 窗口长度, latent_dim: 潜变量维度 # 编码器: Dense(input_dim) -> Dense(latent_dim) # 解码器: Dense(latent_dim) -> Dense(input_dim) # 损失: 均方误差(重构误差) # 训练: 只喂正常窗口 # 检测: 新窗口重构误差 > 阈值(取训练误差的95分位) => 异常
要点:训练后把每个正常窗口的重构误差存下来,阈值取误差分布的 95/99 分位——这是"正常波动上界"的统计定义,可解释、可复现。
3.2 训练纪律
- 只用干净的正常数据:混入异常会把异常学成"可压缩的正常",永久漏报。
- 数据量门槛:全连接 AE 至少数千条窗口,卷积/RNN AE 要求更高。数据不足就回退到 PCA(线性 AE)或传统方法。
- 标准化:输入归一化(Z-score),否则量纲大的特征主导重构误差。
3.3 什么时候该用 AE/VAE
适合:数据量大、正常模式复杂非线性、无标签、异常形态多样(重构误差是"通用异常信号")。不适合:数据量小、实时性要求毫秒级(推理要过整个网络)、可解释性硬性要求(重构误差本身不是业务语言)。
⚠️ 常见坑:窗口长度与"异常长度"不匹配。 窗口太长,一个只持续 3 秒的瞬态异常被 60 秒的窗口稀释,重构误差被"正常部分"平均掉,检测不到。窗口必须贴合你要抓的异常的持续时间。
💡 关键直觉:重构误差检测的本质是"可压缩性检验"。 正常数据因为"有规律"而可压缩,异常因为"破坏规律"而不可压缩。模型的瓶颈维度(潜变量维度)就是"压缩率"——压得越狠,对异常越敏感,但对噪声也越敏感。 维度是敏感度调节旋钮。
3.4 与 RNN/CNN 的杂交
时序自编码器常有三种形态:全连接版(窗口内独立)、卷积版(卷积核抓局部形态)、RNN 版(LSTM 编码/解码,抓时序依赖)。RNN 自编码器是时序重构检测的完全体——既压缩又记依赖,第 3 章混合方法里提到的"RNN 自编码器"就是这个。选型按"你的正常模式主要是局部形态还是长程依赖"来定。
3.5 AE 与 VAE 的选型对照
把 AE 和 VAE 放到具体场景里比较,选型会更清楚:
- 只要"正常/异常"打分 → AE 就够,训练简单、重构误差直接当评分。
- 想要"异常程度"的连续语义 → AE 的重构误差本身是连续值,够用。
- 想生成正常样本做数据增强 → 必须 VAE(AE 只会重建,不会生成新样本)。
- 想用"生成概率"判异常 → VAE(AE 没有概率模型)。
- 训练数据量小、追求稳定 → AE;数据量大、要表达力 → VAE。
一句话总结:AE 是"够用的默认项",VAE 是"要概率与生成能力时的升级"。 多数异常检测项目从 AE 起步就足够,别为了"听起来高级"直接上 VAE——VAE 的变分训练更复杂,调不好反而效果不如 AE。
3.6 重构误差检测的局限与应对
重构误差检测有两个结构性局限,必须心里有数:一是对"幅值异常"敏感、对"形态异常"钝感——一个点突然翻倍,重构误差立刻飙高;但"整段波形形状变了、幅度没变"(比如从正弦变成锯齿波),AE 可能也能重建出来,误差不显著。应对:对形态类异常,用频域特征或潜空间距离辅助。二是"泛化过头"风险——如果 AE 学得太好(潜变量维度太高、压缩不彻底),它连异常都能重建出来,检测失效。应对:控制潜变量维度,把压缩压狠一点,逼模型只保留"正常规律"而非"一切信息"。 这两个局限是 AE 检测调参时的两个旋钮:压缩率(敏感性)与容量(表达力)。
实战问答
问:自编码器的重构误差,用哪个损失函数?
时序数据常用均方误差(MSE)——它对大偏差更敏感,适合抓异常。但要注意 MSE 会被幅值大的特征主导,输入先标准化(Z-score)再算 MSE。
问:潜变量维度怎么定?
太小(压得太狠)正常数据也重建不好,误报高;太大(压得不狠)异常也能重建,漏报高。经验:从输入维度的 1/4 到 1/2 起步,在验证集上扫一遍,看重构误差的分布是否"正常集中、异常分离"。分得开,维度就合适。
问:训练 AE 需要多少正常数据?
比监督学习少得多(不需要异常样本),但仍要足够覆盖"各种正常模式"。经验:正常窗口几千条起步;数据太少时 AE 学不全正常模式,会误报。
问:AE 检测的结果怎么给业务解释?
把"原始波形"和"重构波形"画在同一张图上,异常段会自动"对不上"——视觉对比就是最好的解释。业务方一眼就能看到"模型认为这里应该长这样,但实际不是",比任何数字都直观。如果还要更精确,可以用逐点重构误差热图标出"对不上最严重的时间区间",让工程师直接跳到可疑区段排查。
本节速览
- AE 思想:正常数据可压缩,异常破坏可压缩性;只学正常,重构误差即异常评分。
- AE 结构:编码器压缩到瓶颈、解码器还原;VAE 把潜变量概率化,多了生成能力与生成概率玩法。
- 三种检测:重构误差(最常用)、潜空间距离(表示层视角)、生成概率(VAE 特有)。
- 时序流水线:切窗口 → 逐窗口重构打分 → 高分段映射回时间轴;窗口长度取异常持续时间的 1–2 倍。
- 门槛:超参数敏感、对噪声敏感、需要足够数据——不满足就回退 PCA 或传统方法。
- 杂交形态:卷积 AE 抓形态、RNN AE 抓时序依赖,是时序重构检测的完全体。
下一节,"造数据"的模型登场——GAN。生成器学着伪造正常数据,判别器练就火眼金睛,最后让判别器当异常裁判。对抗训练的博弈,怎么变成检测工具?