7.2 标签获取与数据集构建
7.2 标签获取与数据集构建
本节摘要:异常检测的评估与建模都依赖可靠的标签,但异常标签恰恰是异常检测里最难产出的东西。本节讲清标签获取的五大挑战——稀缺性、主观性、高成本、时变性、噪声不确定性,再展开数据集构建的五大挑战——质量、特征、划分、规模、外部因素,最后给出主动学习、弱监督、众包、异常注入、时间顺序切分、数据增强等应对策略,并以工业设备故障检测为例演示全流程。
本节导航
阅读完本节,你应当能够:
- 列出异常标签获取的五大挑战,并解释为什么"稀缺+主观"是根本性的。
- 说出监督学习对标签质量的依赖风险。
- 掌握时间序列数据集划分的正确方式(时间顺序、滑动窗口、前向链),解释随机切分的危害。
- 列出主动学习、弱监督、众包、异常注入、外部因素建模等策略的适用场景。
- 为"工业设备故障检测"这类场景设计一套标签与数据集构建方案。
一、问题与直觉
假设你终于决定用监督学习(第 5.1 节)做故障检测,然后发现一个尴尬的事实:你没有"异常标签"可以训练。 过去一年设备确实坏过三次,但没人记录过"故障前 2 小时,数据具体长什么样"——因为没人想到要记录。
这就是异常检测的经典死循环:模型越需要好标签,好标签越难产出;而产出标签的过程,又高度依赖领域专家和时间。 更麻烦的是,异常标签的质量天然不稳定——两个专家对同一条波形,可能给出不同的标注结论。
这一节我们直面这个现实。它影响的不只是"能不能训练监督模型",更深远的影响是:所有评估指标(第 7.1 节)都依赖"真值标签"——如果标签本身不可靠,再漂亮的 F1 也是建立在流沙上。所以标签问题不是"监督学习才关心的事",而是整个异常检测评估体系的地基。
二、核心原理
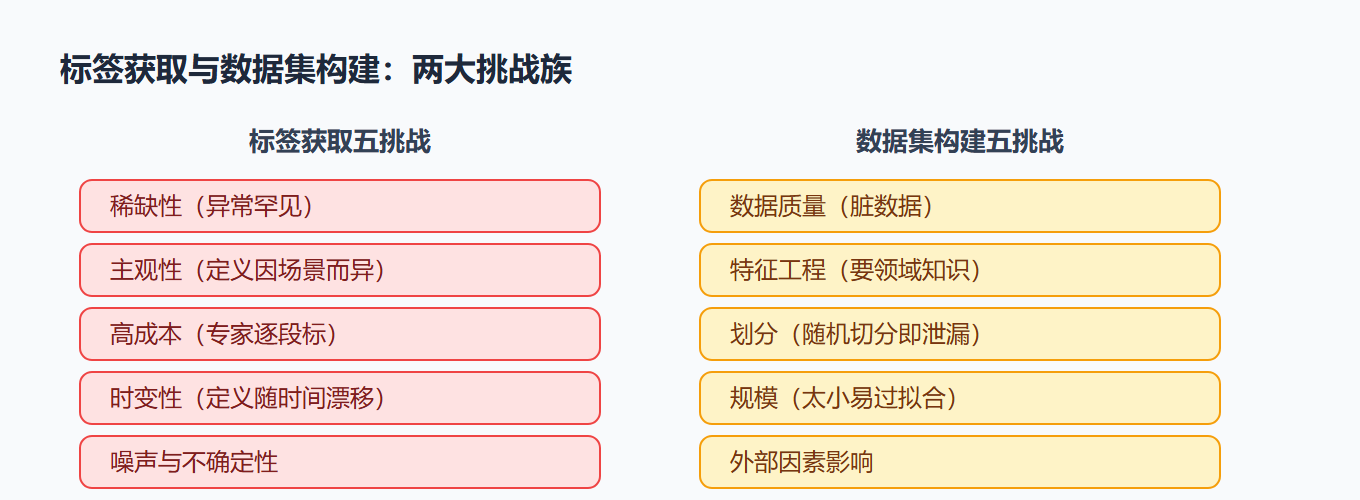
2.1 标签获取的五大挑战
稀缺性:异常事件罕见,异常样本在数据里占比极小。直接后果是类别极端不平衡,模型天然偏向"全判正常"。缓解靠过采样、异常注入等,但都是治标。
主观性:"什么是异常"高度依赖场景与领域知识。一笔大额转账在金融是异常,在电商促销期就是正常;一次温度突降在冬天正常,在夏天可疑。标注必须靠领域专家,而专家的判断本身带主观性。
高成本:人工标注时序数据极贵——专家要逐段审查波形、判断每个可疑点。高频数据(每秒采样)的标注成本指数级上升,一条 24 小时的振动数据,人工标完要几个小时。
时变性:异常的定义随时间漂移。网络攻击手法在更新,昨天的"正常"行为今天可能成了"可疑"。标签需要持续更新,否则很快过期。
噪声与不确定性:即使专家也难以对每条可疑数据给出确定结论——数据有噪声、异常成因复杂,标注结果本身带不确定性。
2.2 数据集构建的五大挑战
数据质量:缺失、噪声、重复、异常值(第 2.1 节)——脏数据直接污染标签与训练。
特征工程:从原始序列提取有效特征是模型上限的关键(第 2.4 节),但好的特征需要领域知识,本身是难点。
数据集划分:时序数据不能随机切分。随机切分 = 数据泄漏——训练集里"未来"的样本泄漏进测试集,评估虚高,上线即翻车。正确做法:时间顺序切分(前 80% 训练、后 20% 测试)、滑动窗口、前向链(扩展窗口逐次预测)。
数据集规模:太小易过拟合。缓解靠收集更多数据或数据增强。
外部因素影响:天气、节假日、政策、季节都对时序有影响。不考虑外部因素,周期性的"外部驱动波动"会被误判成异常。对策:把外部因素做成特征(第 2.4 节),或用专门模型建模。
图:标签与数据集的挑战全景
2.3 应对策略:标签获取
主动学习:不盲目标注,让模型挑"最不确定、最可能出错"的样本给专家标。把标注预算花在刀刃上——同样的成本,信息收益翻倍。
弱监督学习:利用已有的弱信号——设备报警日志、运维工单、规则初筛结果——当"弱标签",训练弱监督模型辅助人工标注。把人工从"全量标注"解放成"复核机器候选"。
众包标注:多标注者并行标注,投票或协商定标签。降低单人工作量,但需要设计质量控制(一致性检验、gold 标准题)。
异常注入:人工合成异常(模拟故障、加扰动),增加异常样本数量、缓解不平衡。注意:合成异常要贴近真实分布,否则模型学到的是"假异常"。
领域知识融合:制定明确的异常定义与标注手册,减少主观性——"什么算异常"先写成书面标准,再让专家照标准标,比让专家各自发挥靠谱得多。
2.4 应对策略:数据集构建
数据清洗与预处理(第 2 章全流程):缺失值处理、去噪、异常值处置。
时间序列划分三件套:时间顺序切分、滑动窗口(窗口训练+预测)、前向链(滚动扩展窗口)。原则就一条:永远不把时间上"未来"的信息泄露进训练。
数据增强:时间扭曲、幅度缩放、加随机噪声——扩充正常样本,提升鲁棒性。对深度模型(第 6 章)尤其有用。
外部因素建模:把节假日、天气等做成特征(节假日 one-hot、天气温度数值),让模型学会"外部因素导致的波动不算异常"。
2.5 半监督与无监督:绕开标签的第三条路
当标签成本实在不可接受,直接绕开:半监督用少量标签 + 大量无标签(自训练、标签传播),无监督完全不依赖标签(聚类、密度、重构,第 5.2 节)。现实工程的默认顺序往往是:先无监督/半监督跑量,再让系统报警+人工复核沉淀出标签,等标签攒够再演进到监督。 标签不是天上掉的,是系统自己"喂"出来的。
三、工程实践要点
3.1 一个完整的案例:工业设备故障检测
假设你要给压缩机做故障检测,标签几乎为零。一套可落地的方案:
- 弱监督起步:收集设备运行日志与报警记录,把"触发过报警的时段"当弱标签,粗训一版模型。
- 异常注入:根据故障机理模拟注入(如模拟轴承磨损的振动特征),补充异常样本。
- 特征工程:提取振动信号的时域统计特征、频域主频分量、窗口特征(第 2.4 节)。
- 外部因素建模:把环境温度、湿度、工况负荷做成特征。
- 半监督兜底:用少量确认标签 + 海量未标注数据训练半监督模型。
- 人工复核闭环:模型报警 → 工程师复核 → 确认/排除 → 回流成新标签 → 迭代模型。
这个流程的精华:标签不是前置条件,而是系统运行过程中持续产出的副产品。 第 5.3 节说半监督是"标签孵化器",这里就是完整画面。
3.2 标注成本控制的三个抓手
- 先机器后人工:用规则/无监督模型先筛候选,人工只标"机器拿不准"的边缘样本。
- 段标注代替点标注:时序异常常是"一段",按段标注(标"第 3 分钟到第 9 分钟是故障")比逐点标注省 10 倍人力。
- 定期抽检复核:已标标签定期抽样复核,抵抗时变性(攻击方式更新后旧标签失效)。
⚠️ 常见坑:随机切分时序数据集。 这是时序 ML 的头号低级错误——随机切分后模型"偷看"了未来,测试分数虚高,上线实际效果打折。记住:时序数据永远按时间顺序切分,或用滑动窗口/前向链。
💡 关键直觉:标签质量问题比数量问题更致命。 500 万条噪声标签训练出来的模型,不如 5 万条干净标签。异常检测里"标签的可靠性"优先级高于"标签的规模"——因为异常定义本身就模糊,掺水的标签会系统性教坏模型。
3.3 评估与标签的联动
最后回到评估:第 7.1 节的指标建立在标签之上,但标签自身的可信度要单独评估。实践中常用两个指标:标注者间一致性(两位专家对同一批数据的标注重合率)、标注者与"金标准"的一致性。先标定标签可信度,再谈模型 F1——这是专业团队和业余团队的分水岭。
3.4 时间序列划分的三种标准姿势
数据集划分对时序任务格外关键,三种标准姿势各有用处:
| 划分方式 | 做法 | 适用场景 | 关键点 |
|---|---|---|---|
| 时间顺序切分 | 前 80% 训练、后 20% 测试 | 有明确时间先后、一次性评估 | 严禁随机切分 |
| 滑动窗口 | 固定训练窗 + 预测窗,滚动评估 | 评估"模型随时间退化"的情况 | 窗口长度按周期定 |
| 前向链(扩展窗口) | 训练窗逐步扩大,逐次预测下窗 | 模拟"滚动重训"的生产形态 | 最接近生产真相 |
三个姿势的共同纪律:训练数据永远只用"当前时刻之前"的信息;任何"用未来信息算出来的统计量"(如全序列均值)都不能当特征。这三种姿势里,前向链最接近生产环境的真实形态——模型在生产里就是"用过去预测现在",评估方式与生产方式一致,评估结果才有参考意义。
3.5 弱标签的可靠度管理
现实里很多项目只能用"弱标签"(报警日志、工单记录、规则初筛结果)起步。弱标签的可靠度管理有三条原则:一是分层置信——报警日志的"确定性"(硬报警可信,软报警存疑)要有标注;二是抽样验证——定期抽一批弱标签人工核对,估算其准确率,并把准确率纳入后续评估的修正系数;三是渐进强化——弱标签训练出的模型用于辅助标注,确认后的结果回流成强标签,弱标签体系逐步升级为强标签体系。弱标签不是"凑合着用",而是一条通往强标签的渐进路径——用好它,标签问题就不至于卡死项目。
实战问答
问:标签实在弄不到,项目还能做吗?
能,用第 7.2 节的"三条路":先无监督/半监督跑量 → 系统报警+人工复核沉淀标签 → 标签攒够再演进监督。标签不是前置条件,而是系统运行过程中持续产出的副产品。 别让"没标签"卡住整个项目。
问:异常注入的合成数据,会影响模型真实性吗?
会,所以注入要"贴近真实机理"。根据故障机理合成(模拟轴承磨损的振动特征、模拟攻击流量模式)比随机加噪声可信得多;注入的数据还要做标记,评估时区分"合成异常检出率"和"真实异常检出率",别混为一谈。
问:标注规范怎么写才算好?
三要素:异常的精确定义(什么算异常,举正反例)、标注粒度的约定(逐点还是逐段,边界怎么算)、不确定情况的处理(拿不准时标"待定"还是"不标")。规范越明确,标注者间一致性越高,标签质量越稳。
问:外部因素导致的波动算异常吗?
取决于业务定义。如果"节假日导致的销量波动"业务上算正常,就要把节假日做成特征(第 2.4 节),让模型学会"这种波动不算异常";如果业务上就是要抓"非节假日的异常波动",则相反。"算不算异常"是业务决策,不是技术决策——先和业务对齐定义,再做数据设计。
要点速记
- 标签五挑战:稀缺、主观、昂贵、时变、不确定——"稀缺+主观"是根本性的。
- 数据集五挑战:质量、特征、划分、规模、外部因素。
- 时间顺序切分是铁律:随机切分=数据泄漏,正确用时间切分、滑动窗口、前向链。
- 标签策略:主动学习、弱监督、众包、异常注入、领域知识手册化——把标注预算花在刀刃上。
- 绕开标签:先无监督/半监督跑量,系统报警+人工复核沉淀标签,再演进监督。
- 标签质量优先于数量:先标定标签可信度,再谈模型评估。
下一节,也是全书最后一节——检测出来了,怎么跟人说清楚?可解释性 XAI 登场:SHAP 分配归因、LIME 局部代理、注意力可视化,让黑盒模型的结论变成"可以负责的理由"。