2.4 数据集划分与采样
2.4 数据集划分与采样
本节摘要:特征备好后,还要把它合法地切成做实验用的三份。本节覆盖留出法的比例与分层、时序数据的按时间切、K 折交叉验证,以及类别不均衡时的采样选择,并给出划分对验证信号可靠性的影响。
学习目标
阅读完本节,你应当能够:
- 按数据量决定留出比例,并做分层划分防止子集类别失衡。
- 对时序/偏序数据按时间切分,避免未来信息前漏。
- 在数据小时选用 K 折交叉验证,并理解其时间成本。
- 在不均衡场景下判断用重采样还是加权重,并认清其风险。
一、切分先于一切
上一节我们有了特征齐全的数据,下一步就是第一次真正"动手切"。切分看似平凡,却是整个实验可信度的闸门——你第一章立的"基准是未见数据"这条规矩,靠的就是这里的切法。两套完全相同的模型,仅仅因为切分方式不同,得出的结论就可能两极。
二、留出法:比例与分层
最常见的是按比例随机留出,比如训练 70% / 验证 15% / 测试 15%。比例没有唯一解,但有几条经验:
- 数据量海(几十万行以上):可以压一点验证/测试的比例,比如 90/5/5,训练样本充足。
- 数据量中(几万行):偏向 70/15/15 或 80/10/10。
- 数据量小(几千行):单靠留出太脆,直接考虑 K 折。
分层切分(stratify)几乎是标配:让训练/验证/测试三个子集各类别比例与原数据一致。否则随机抽可能让测试集不幸缺了某类,指标被噪声劫持。
三、时序数据:必须按时间切
如果样本带时间先后且目标可能随时间演化(预测风控、推荐、销量),绝不随机切——随机会把未来样本塞进训练集,模型偷看了未来,验证分数虚高。正确做法是用时间轴切开:靠前的作训练,靠后的作验证/测试。必要时还用"滚动的时序验证"多次评估,更贴近真实上线的时间感。
# 示意:按时间切分而非随机 import pandas as pd df = df.sort_values("ts") cut = int(len(df) * 0.8) train = df.iloc[:cut] # 只用过去 test = df.iloc[cut:] # 才算未来
四、数据量小时:K 折交叉验证
按数据量把"该用哪种切分"总览成一张图,方便对照上手:
按数据量与时序性选择切分策略
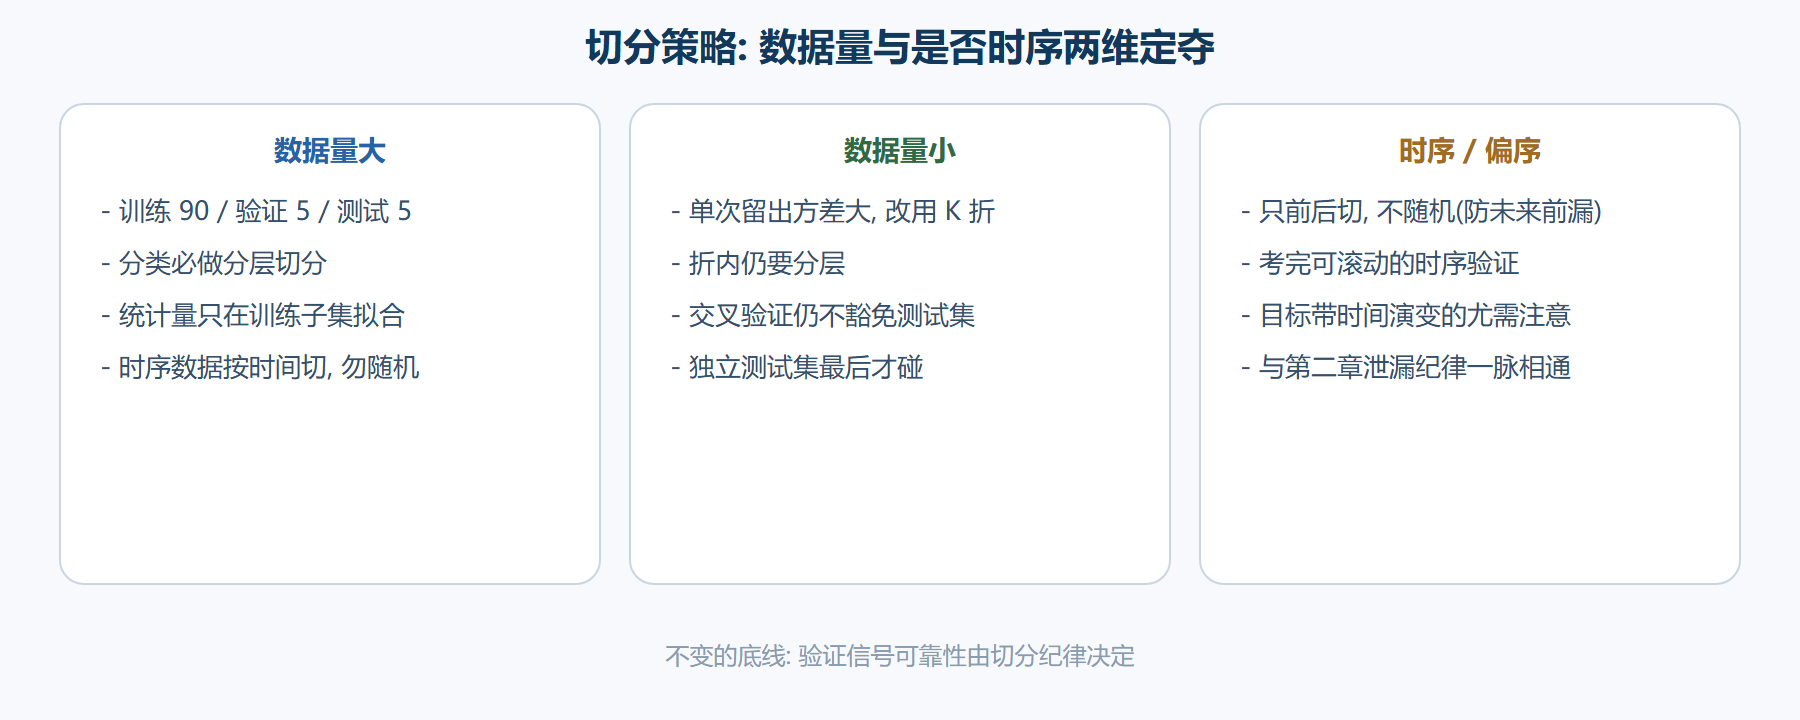
数据量一旦下来,单次留出的方差极大——也许你只是切到了一个"运气好"的子集。换 K 折(常见 K 取 5 或 10):把数据切成 K 份,轮流留一份当验证、其余 K-1 份训练,最后平均折成绩。代价是训练 K 次、时间约乘 K;换来的结论明显更稳。前面第一章的闭环图已经演示过这个回路,本节不再重复画,只强调一个执行要点:交叉验证内部的"训练子集"也要继续分层,别在折叠内部失衡。
交叉验证得出的最优超参,仍要在那一个一次都不参与调参的独立测试集上复核——K 折解决的是"评估方差",不是"测试集免碰"。
五、类别不均衡:重采样与加权重
当某类极少(如癌症阳性占 1%),直接训练会整体偏向多数类。可选手段:
| 手段 | 动作 | 代价 |
|---|---|---|
| 欠采样 | 砍多数类样本到与少数类相近 | 丢失信息,可能有偏 |
| 过采样 | 复制/合成少数类(如 SMOTE) | 可能过拟合合成样本 |
| 加权重 | 损失里给少数类更高权重 | 需调权重超参,稳定但考验调参 |
更重要的一步先于采样:把第一把尺子里的"类别不均衡别用裸 Accuracy"重新请回来。重采样的真正作用区域是让模型学到结构,而最终的用尺与阈值另算。别指望采样一步解决评估偏颇的问题。
六、切分卫生:一个便宜的自检清单
切分太重要又太容易被手滑出问题,动手前建议跑一套"切分卫生"自检:①切完后重新统计每份样本量与各类别占比,确认你的切分配置真的生效(而不是某个随机因素悄悄覆盖了它);②对时序任务,随机抽几行确认训练集的时间轴全部早于验证/测试,杜绝"未来信息穿越";③拿一个"弱基线"(比如常数预测)在三份上各跑一次,若测试上的弱基线分明显高于验证,多半是切出问题或两组分布不一致;④记下切分的随机种子与配置文件,方便别人复现你的切法。这四条加起来只需几分钟,却能把"切分这一环悄悄毁了整个实验"的风险压到很低。
这里再补一个常被忽略的角度:切分的"比例"不该是拍脑袋,而要和"决策噪声"联动。验证集太小,读数抖得厉害,你每次改动消化的是噪声而非真信号;验证集太大,留给测试的信息又不够。所以数据量中等时,宁可用"时间换稳定":段子太少就上 K 折、或把验证比例往上抬一点,先把"读数可信"摆到"样例更多"之前。这一权衡的本质,和你在第一章注意到的"尺子要稳才拧得动旋钮"是同一个量级的决定——切分不是数据处理的边角料,而是实验可靠性的第一道闸门。
⚠️ 常见坑:在切分之前就做了过采样——合成出的样本在训练和验证里各自成对出现,等于把"背题"放进验证集,验证分数虚高。规范做法是先切分,再仅在训练折叠内做采样。
💡 关键直觉:很多实践者把验证/测试切分布置成和真实线上分布一致,是一种比"均匀分层"更贴近业务的做法——线上罕见类在测试里也罕见,才测得准真实表现。
再补一句关于"seed 固定"的价值。跨模型或跨超参数对比时,同一个随机种子往往能让差异更可判读:各组共用一套划分,彼此的差异就主要来自"模型/超参"而非"换了个随机子集"。当然这不等于永远锁死同一个种子——最后宣判时仍建议换 2-3 个播种再各跑一次,看结论是否对"偶然的划分"稳健。固定是为了"拿掉划分这一项差异",换播种是为了"确认结论不依赖这次运气",两步缺一不可,共同构成"切分这一环"在实验记录里该有的可复现性。
本节要点回顾
- 要点一:留出比例按数据量定,小数据直接走 K 折。
- 要点二:分类数据做分层切分,时序数据按时间切分,别随机切。
- 要点三:K 折解决评估方差,独立测试集仍只在最后碰。
- 要点四:欠采样、过采样、加权各有代价,且采样只在训练折叠内进行。
- 要点五:验证信号的可信度由切分纪律决定,切不好则调参全失真。
数据端至此备齐。下一章把视角转向"在这份数据上选哪个模型、从什么起点开始训练"。