4.1 损失函数与优化器
4.1 损失函数与优化器
本节摘要:训练的第一块基石是"目标函数"与"更新规则"。本节解释常见损失函数各在惩罚什么、如何按任务选型,以及优化器 SGD、Momentum、RMSProp、Adam 各自修正了什么,帮你理解"训练在求什么、用什么方式去求"。
学习目标
阅读完本节,你应当能够:
- 为回归、分类、排序等任务选对损失函数,并解释其行为差异。
- 说明 MAE 与 MSE 对离群值敏感度的差别及取舍。
- 说出优化器之间的关键差异:动量、自适应学习率、Adam 为何常用。
一、训练的全部意义,浓缩成一个数
训练过程中,模型每接受一批数据,都先做前向计算得到预测,再与真值比出一个数——损失。训练就是不断通过这个数去反向调整参数,让它在数据集上尽可能小,所以"选什么损失"几乎是先于"调多少参数"的决定。
二、损失函数:在量"哪种错"
回归里,最常用的是 MSE 与 MAE。MSE 对误差平方,放大了大误差的惩罚;MAE 对误差取绝对值,量纲直观、对离群值更稳。当数据里有脏的异常点,MSE 会被少数大误差牵着走;而当你看重平均行为时,MSE 又有好梯度。实际上还有 Huber,结合两者:小误差用平方、大误差裁成线性,是个不错的折中。
分类里,最常用的是交叉熵。它把模型输出的概率分布与真实 one-hot 拉近,本质上是"对数似然的负值"。它与软最大化配合,给出概率化的预测,梯度行为也友好。对类别不均衡,可在交叉熵里加权(重温第一把尺子的 F1/AUC 那段)。
排序/学习排序里,有面向位置的损失(如按对的排序损失)。这里点到为止,排序任务可以单开一本册子。
| 任务 | 常用损失 | 特性 |
|---|---|---|
| 回归 | MSE | 强惩罚大误差,最小二乘对应 |
| 回归(含异常值) | MAE / Huber | 更稳,背起离群点的代价 |
| 二分类 | 二元交叉熵 | 输出概率,配 Sigmoid |
| 多分类 | 交叉熵 | 输出概率,配 softmax |
| 类不均衡分类 | 加权交叉熵 | 重少数类 |
三、优化器:在下坡路上怎么迈步
用一个并排图把"损失怎么选 + 优化器怎么走"两张反思拼在一起看:
损失与优化器的配对直觉
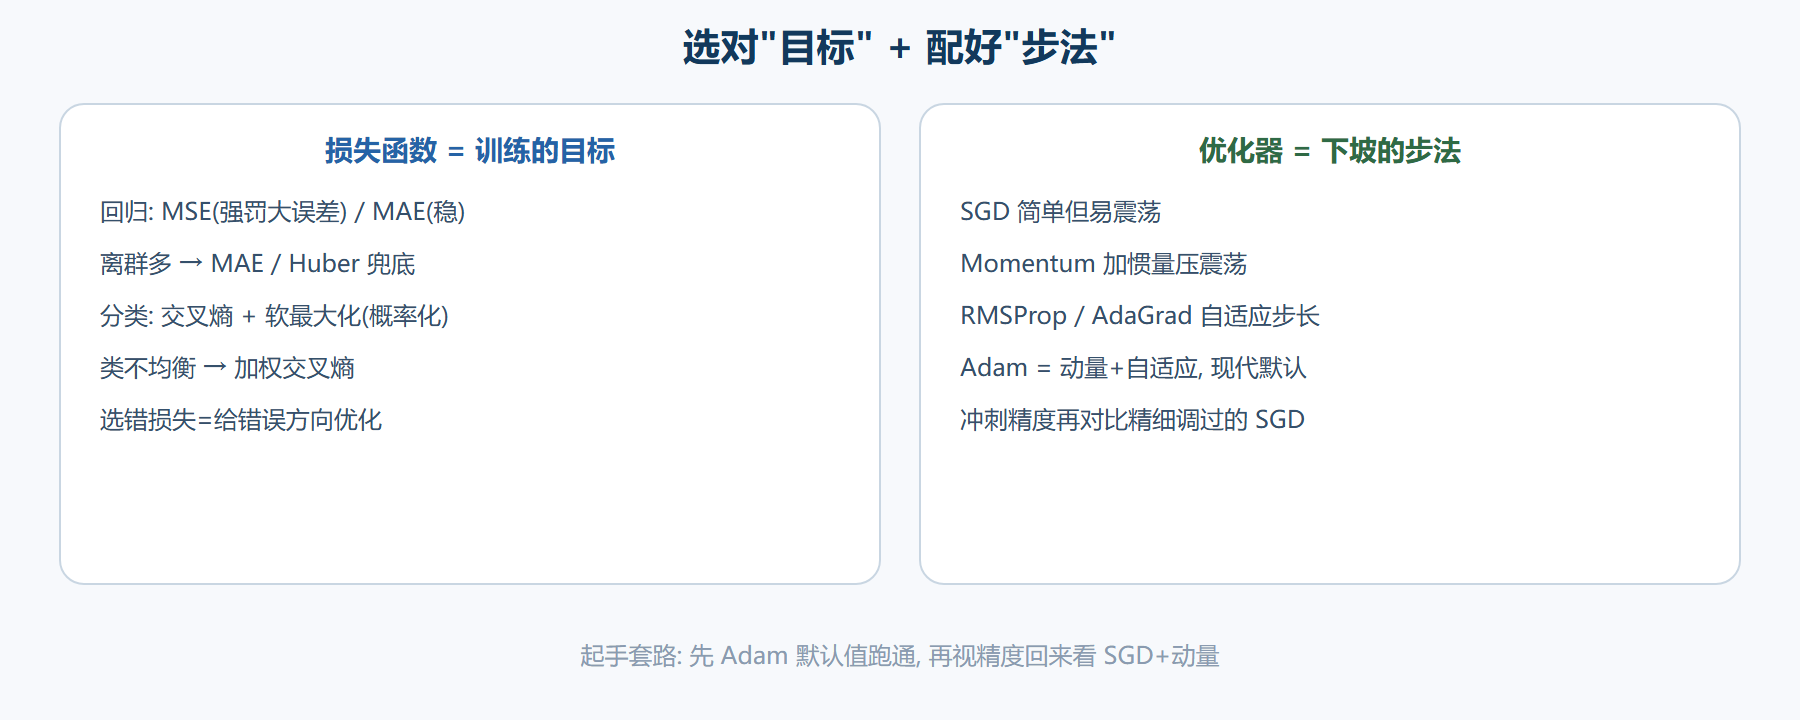
损失给出了"往哪下更陡",优化器决定"这一步迈多大、怎么迈"。暖场后看四大代表:
- SGD:每次按当前点梯度迈一步。简单,但易震荡、对学习率敏感。
- Momentum:给更新加"惯量",把过去几步的方向折进来,能跨过小洼地和振荡,更快稳定下滑。
- RMSProp / AdaGrad:按每维梯度历史自动缩放步长,对每个参数分开管学习速率。
- Adam:好比"动量 + 自适应步长"合体,几乎成了现代深度学习默认入口。收敛快、对默认超参稳健,但个别场景被证明不如精细调过的 SGD。
# 示意:不同优化器的实例化(概念性) import torch.optim as optim sgd = optim.SGD(model.parameters(), lr=0.1, momentum=0.9) rmsprop = optim.RMSprop(model.parameters(), lr=1e-3) adam = optim.Adam(model.parameters(), lr=1e-3)
四、上手建议
没有"永远最好"的优化器,但有起步套路:先从 Adam 的默认学习率起,把模型训通、把其他环节跑顺;等要冲刺更高精度或追求更稳收敛时,再回来对比精细调过的 SGD + 动量。别在优化器上过早陷入玄学,先把损失选对、把流程跑通。
落到真实实验,有几条"选损失"的经验值得记进笔记。一是别只看主损失,要学会加辅助项:比如回归里常用 MAE 主损失却偶尔配一点 MSE 项,让大误差的惩罚既不至于失控又能被牵住;正则项本质也是往损失里加一项,理解这一点,你就能把"选损失"和"调正则强度"放在同一个心智模型里看。二是损失的可微与数值稳定性:SVM 的 hinge、深度网络的交叉熵都经过精心挑选,让梯度不至于爆炸或消失,这提醒你"换个损失"不等于简单换个函数,还要看它和激活、输出层相不相配。三是保存"无损失公式"的记录:你最终跑出好结果的损失配置(含所有辅助项与权重)必须一字不差地存进实验日志,否则换个人重跑就得到不同的数。这三条一起,能让"选损失"从感觉变成可复现的工程决策。
⚠️ 常见坑:损失函数与业务目标"割裂"。比如优化目标是交叉熵,但业务真正关心的是精确率/召回率的某个阈值点——这两者往往只在大方向一致。别指望优化损失就自动满足业务口径,最后可能还要在部署阈值上做收敛。
💡 关键直觉:看到"训练损失下不去",先别怀疑优化器不行——多半是学习率太大导致震荡、或模型容量/数据不匹配导致欠拟合。优化器只是"下坡的步法",不是"坡本身"。
还有一点容易被经验覆盖到的易错位:"选优化器"和"选学习率"常常要绑在一起看,而不是各选各的。同一个 Adam 配 0.01 与配 0.0001,效果天差地别;而一个调好的 SGD + 动量在某些任务上甚至能反超默认的 Adam。所以务实的方式是"以优化器为容器、以学习率为变量"来一起扫:先固定优化器,把它那个合理的默认学习率扫两三档;如果要对比另一台优化器,也把各自的学习率带到它的合理区间再比。这样你得到的结论是"哪套组合在我的数据上更行",而不是"哪个优化器名字更高级"。
本节要点回顾
- 要点一:损失函数定义了训练的"目标",选错损失等于给错误方向做优化。
- 要点二:MSE 强罚大误差、MAE 对离群更稳,按数据污染情况与平均行为取舍。
- 要点三:分类线交叉熵配软最大化,输出概率化预测。
- 要点四:SGD、Momentum、RMSProp、Adam 各自修正"步长与方向",Adam 是常用默认入口。
- 要点五:先用 Adam 默认值把流程跑通,再回来对比精细调过的 SGD。
目标与优化器就位后,下一步解剖一个完整 epoch——训练流程与批处理。