5.1 正则化方法
5.1 正则化方法
本节摘要:正则化是对抗过拟合的第一件武器。本节讲清 L1 与 L2 如何"给复杂度付费"、它们行为上的差异、以及网络里 Dropout 的机制与适用场景,还提醒正则化加错方向会压成欠拟合。
学习目标
阅读完本节,你应当能够:
- 说清 L1 常产生稀疏解、L2 常把权重整体压小,并解释原因。
- 理解 Dropout 在训练时随机丢弃的动机与预测时的规则。
- 判断什么时候该先怀疑"正则化加过头"而非"模型容量不够"。
一、给模型"背题"套上枷锁
上一章我们认识到训练会滑向"把训练集背下来"。正则化登场——它不是一个开关,而是一类**在损失目标上加一条"复杂度罚金"**的做法,逼着模型在"拟合得好"和"参数别太张扬"之间找平衡,从而更不愿去抄那些只有训练集才有的偶然细节。
二、L1 与 L2:两种"付费方式"
两者都在损失里加一项和权重大小有关的罚金,但形态不同决定了性格不同:
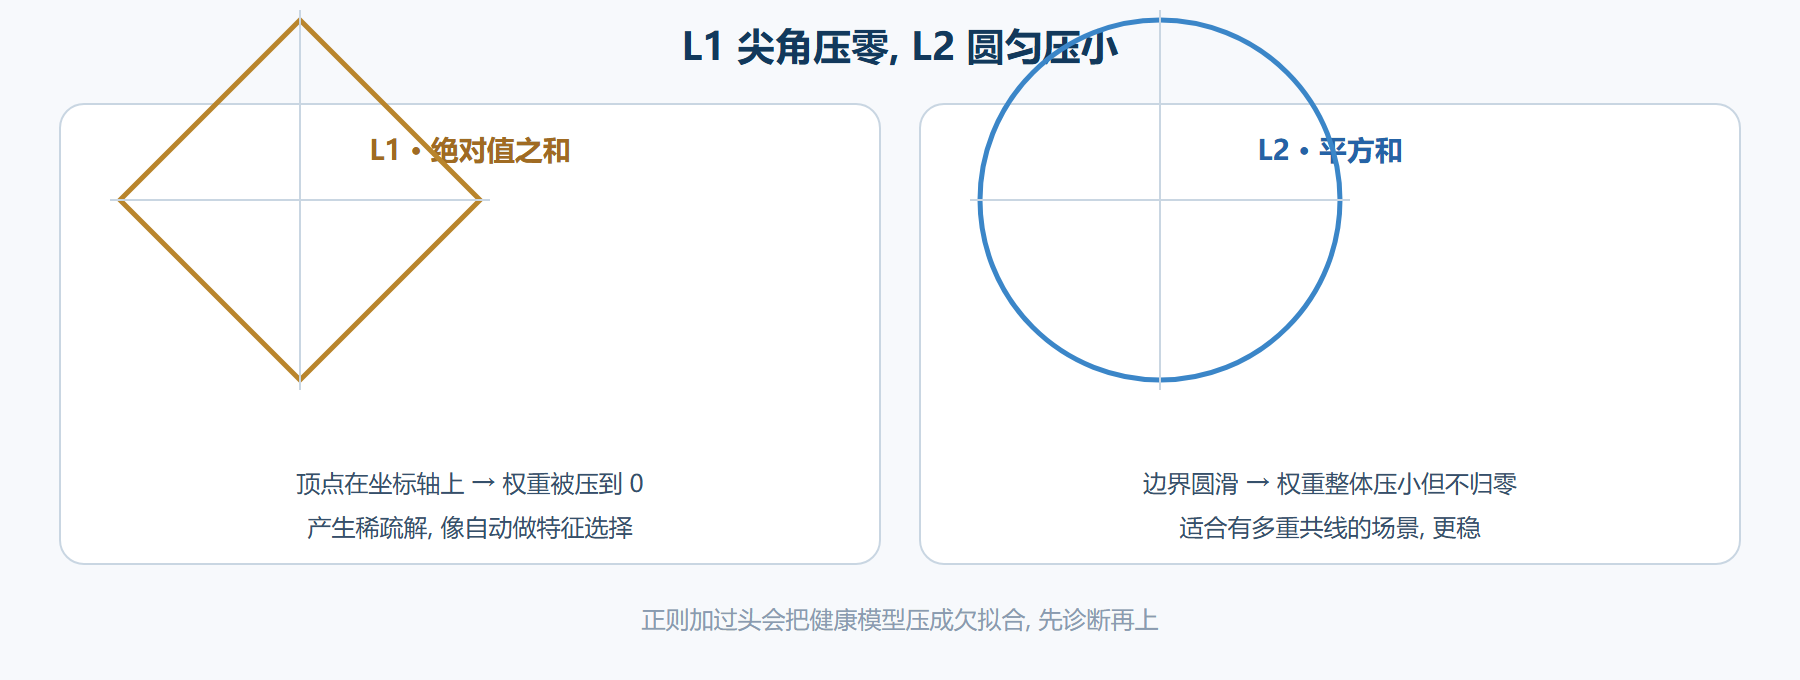
- L1(套索):罚权重的绝对值之和。它倾向于把一部分权重真正压到 0,产生稀疏解——相当于自动做特征选择。适合你想"让模型自己挑哪些特征重要"的时候。
- L2(岭):罚权重平方和。它把所有权重整体压缩但几乎不真归零,相对"分摊",对多重共线更稳。
直觉:绝对值函数在 0 处有个尖角,梯度驱动权重精确落在 0;平方函数在 0 附近很平,停机或走到很小的非零值。落实到模型上,一个有大量无意义特征的数据, L1 能帮你砍;想让所有特征都保留一点贡献,L2 更顺。
用一张图对比 L1 与 L2 在参数空间里的"罚区"形态,直觉更直观:
L1 与 L2 罚区形态对比
深度网络里一种很有画面感的正则——训练时每个神经元按某个概率随机"关机",一批一批地变。这样网络被迫学会用冗余的路子表达,不依赖任何单个神经元的偶发强信号,从而更鲁棒、更不易背题。开 Dropout 有个关键细节:预测时要把权重按保留概率缩放(把"随机丢弃"折算成"期望输出"),否则推理和训练分布不一致。现代框架这一缩放通常自动处理好,但你该知道它存在。
| 技术 | 主要杠杆 | 适用 | 代价 |
|---|---|---|---|
| L2 | 正则强度参数 | 线性/回归/网络通用 | 需调强度 |
| L1 | 正则强度参数 | 稀疏化/特征取舍 | 可能与L2混用致解释复杂 |
| Dropout | 丢弃概率 | 全连接层 | 训练变慢 |
四、加错方向:把健康模型压成欠拟合
正则化的反面风险常被忽略:过量的正则会让本可以学好模型,什么都学不到,反而欠拟合。所以引用正则前,先回到第四章的训练监控和第一把尺子确认:你真的在过拟合(验证升、训练低)吗?如果明明是欠拟合(双双下不去),你加正则就南辕北辙。
# 示意:给损失附加 L2 的做法之一(权重衰减) optimizer = optim.Adam(params, lr=1e-3, weight_decay=5e-4)
⚠️ 常见坑:Dropout 的丢弃概率开得过狠(比如 0.9),训练损失久久不下,于是又去加容量、加数据,越搅越乱。排查时先看训练曲线:如果训练损失本身就高,那是欠拟合问题,正则不是方向。
💡 关键直觉:L2 实现上常用"权重衰减"直接做在优化器里,而不是真的往损失里加一项——两者在 Adam 这类自适应优化器下不尽相同。理解你在用哪种实现,避免对"同一个正则参数"的期望落空。
五、正则的"开机自检":先想清楚要治什么
正则不是所有问题的答案,动手前先做个"开机自检",能省下大把乱调的时间。先确认真启动了"过拟合通路":如果你还没看到训练与验证两个损失拉开剪刀口,就提前堆正则,往往是把一个还能进步的模型提前按住了。所以我的建议是按顺序来——先把模型训练到真的出现过拟合迹象、把这个现象看得清清楚楚,再决定用哪件武器去治它。这和你修车不先查出是轮胎还是发动机就把所有零件全换一遍,是一个道理。记住一句:看清了病再开药,而不是看到"正则"就无脑加。
其次,正则之间也要会取舍。L1、L2、Dropout、提前停止并不是越多越好、互相可替代。L2 便宜、普适,几乎不挑模型;L1 带着"自动选特征"的私心,适合你确实想砍掉一堆无意义特征的时候;Dropout 主要伺候全连接网络;提前停止则是几乎零成本的"最后一层兜底"。选哪个,取决于你"最想治的是哪种过拟合"——是整体权重太张扬(L2)、是存在一堆没用的特征(L1)、还是深度网络里神经元的共线性(Dropout)。多数时候一个主采一个兜底就够,堆太多正则反而互相缠斗、解释不清。把这些想清楚,正则就从"每个参数都试一遍"变成"对着病根点药"。
还有一个执行上的坑值得专门讲:正则的"强度"不是越大越稳,往往存在一个甜点区间。L2 的强度调得太大,模型会连该学的基础规律都压住,陷入"既没拟合好也没泛化好"的两头空;Dropout 概率太高则训练损失的收敛会拖慢、最终上限被压低。所以正则参数不是"含义越深就越该开大",它同样要像超参一样用验证信号来收敛到一个合理区间。进行到这里,你大概也能体会到:这一节讲的正则,和第六章讲的超参搜索是一脉相承的——正则强度是"影响泛化的旋钮",搜好它,才能把"防过拟合"做到点子上。
把正则放进本册的整体图景里,它的定位其实很清楚:正则是对抗"方差"那一侧的工具,它治的是过拟合,而不是欠拟合。认清这条边界,你才不会被"正则能提升泛化"这句笼统的话误导到在欠拟合时乱加正则、把一个还能继续学的模型按死。判断要不要用正则、用多重,答案永远回到那两根曲线和每把尺子上。把它和提前停止、数据增强这些"同一汪里的水"放一起看,你会意识到:泛化不是靠某一招厉害的魔法,而是靠这几件看得清边界、用得对时机的工具合力守出来的。
本节要点回顾
- 要点一:正则化是往损失里加复杂度罚金,权衡拟合与"别太张扬"。
- 要点二:L1 产生稀疏解(压到0)、L2 整体压小,二者性格不同。
- 要点三:Dropout 训练时随机关掉神经元,预测时按概率缩放权重。
- 要点四:正则加过头会把健康模型压成欠拟合,先诊断再上。
- 要点五:L2 常经权重衰减实现于优化器,理解实现差异以免期望落空。
下一件武器与正则互补——提前停止,在某些场合几乎零成本地守住泛化。