6.3 自动化调优技术贝叶斯与进化
6.3 自动化调优技术贝叶斯与进化
本节摘要:网格与随机都"不看结果反馈"地烧预算,自动化调优让搜索"越搜越聪明"。本节讲贝叶斯优化的代理模型与下一组怎么挑、进化算法用遗传操作迭代,以及它们在昂贵训练里如何少步直达好点的优势。
学习目标
阅读完本节,你应当能够:
- 说清贝叶斯优化"代理模型 + 采集函数"的分工。
- 解释为什么它能在昂贵训练里用更少组数找到好点。
- 认识进化算法(遗传)在超参优化里的思想与适用场景。
一、聪明地把算力花在刀刃上
网格和随机有一个共同弱点:它们不看已经跑过的结果反馈——随机采样更是纯凭运气,不管你试到第几组。而真正贵的模型,一次全量训练几小时,你希望每一组都"更接近"好点。自动化调优的核心,是把之前所有实验的结论变成下一步的方向。
二、贝叶斯优化:猜一个代理模型,挑最有希望的下一组
贝叶斯优化把"超参数 → 验证分数"当成一个黑箱函数。策略分两步走:
- 建代理模型:用已经试过的若干组(x与y),拟合一个"像但便宜"的预估器,给出空间里每个点的预估均值与不确定度。
- 采样函数挑点:在"此处预计值高"与"此处还没怎么试(值得冒险)"之间做平衡,挑出下一组该试的点——要么带高期望,要么是未探索区域。跑完后把结果并入样本,更新代理,继续循环。
贝叶斯优化的采样与更新循环
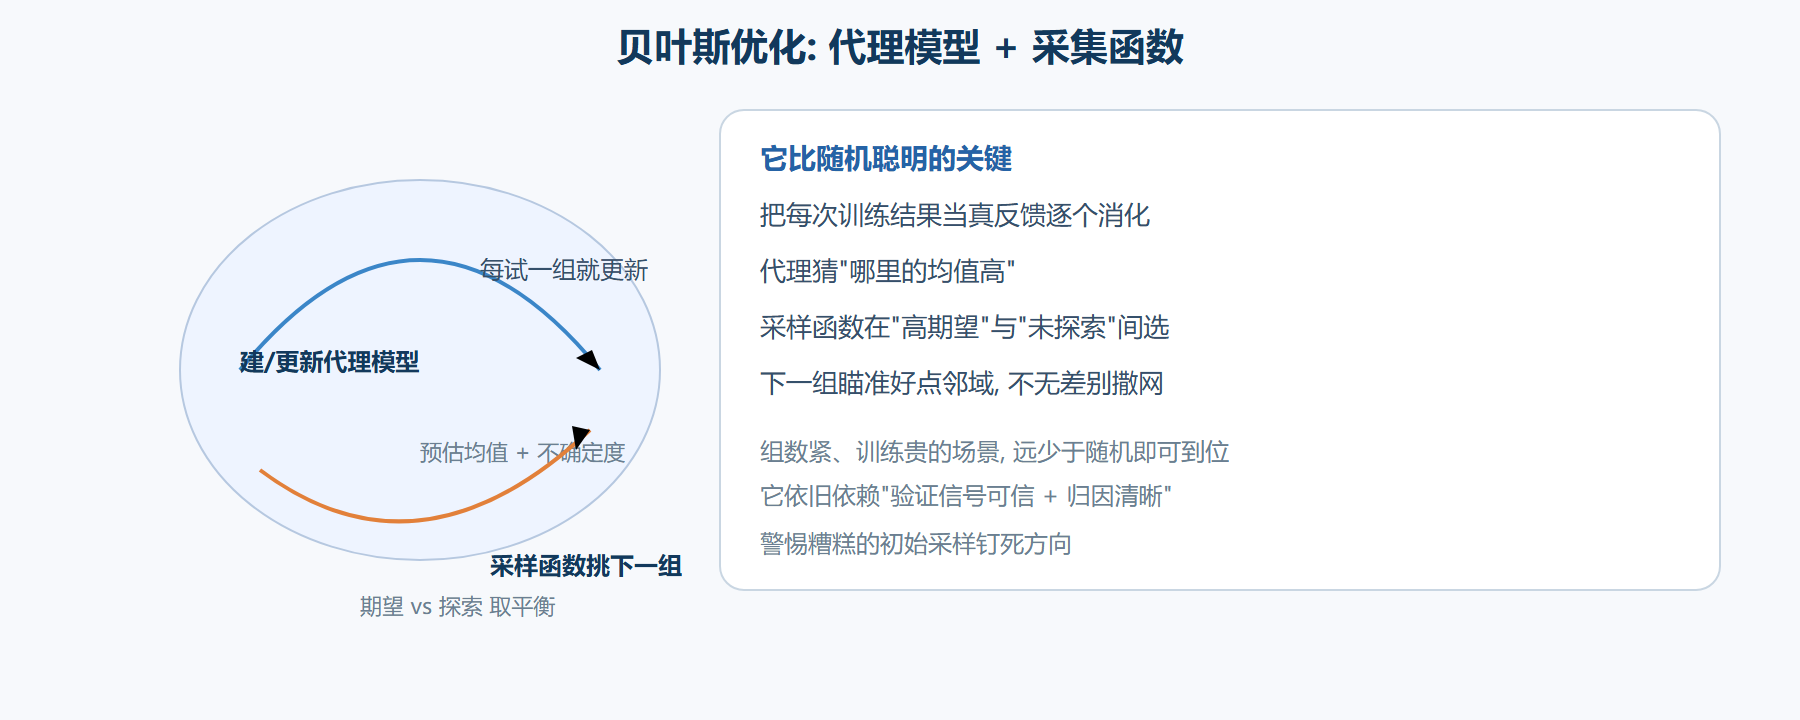
它能用远少于随机的组数找到好点,是因为它把每次训练当反馈逐个消化,而不是一遍遍地无差别撒网。代价是每次选点要算代理模型,但对昂贵训练来说这点代价不值一提。
三、比随机更省的一个直观
假设有一维是对结果影响很大的学习率。随机采样会均匀撒;而贝叶斯优化在试过几组后,很快就意识到"学习率太大全炸、太小不下"——代理模型会把置信度集中到学习率的某个有利区间,接下来几组都往那附近探。于是它把预算"花在刀刃紧邻处",而不是撒满整片。
# 示意:贝叶斯优化的一种常见面向对象用法(概念性) import optuna def objective(trial): lr = trial.suggest_float("lr", 1e-4, 1e-1, log=True) bs = trial.suggest_categorical("bs", [32, 64, 128]) reg = trial.suggest_float("reg", 0, 1e-2, log=True) score = train_eval(lr=lr, bs=bs, reg=reg) # 昂贵的全量训练 return score study = optuna.create_study(direction="minimize") study.optimize(objective, n_trials=40)
四、进化算法(遗传)的另一条路
与贝叶斯优化平行,进化类方法借鉴自然选择:对一组候选超参数做"适应度评估,好则保留",再用交叉与变异产生下一代。它的优势是对非连续、离散、甚至混合类型的搜索空间宽容,有不错全局探索;缺点是无代理预估,可能要用更多组数,且收敛速度未必赶上贝叶斯优化。当你的超参数里有大量离散配置时,可以考虑它。
五、如何选策略:一张速查
| 预算/特点 | 推荐 |
|---|---|
| 组数很紧、训练很贵 | 贝叶斯优化 |
| 纯离散/混合型空间 | 进化并配交叉变异 |
| 想先快速定范围 | 先随机,再转贝叶斯精修 |
| 用现成平台 | 直接用平台的 Bayes/TPE 方法 |
⚠️ 常见坑:贝叶斯优化的起点很依赖"初始采样"。若初始只试了学习率很糟糕的几组,代理会误判区域,后面可能一直绕远。较多实现会自动做"先随机探几组再转贝叶斯",但也值得留神——别让糟糕的起点钉死方向。
💡 直觉:自动化调优不是"托管玄学",它仍要建立在"单因子可归因 + 信号稳定"之上。贝叶斯帮你搜索,但"搜到什么值、验证信号是否可信"仍是你的职责;把验证协议做稳,自动化才能事半功倍。
六、别让"自动化"替你做所有决定
自动化调优最诱人的地方,就是那句"点两下就帮你搜完"。但我要给你泼盆清醒水:自动化省的是"怎么选下一组"的苦力,不省"空间设计"和"结果判断"。空间设计,指你要把哪些旋钮放进去、各自用什么分布采样——这一步还是得你按"旋钮地图"来定,放进一堆无关紧要的旋钮只会稀释预算。结果判断,指贝叶斯帮你在某个区域内找到了高分,但你要回头确认"这个高分是否建立在可信的验证信号上",而不是一次偶然折叠的虚高。所以我的建议是:把人眼的"范围设计和结论复核"与机器的"点选与迭代"分开——机器负责跑量和迁利,你负责设局和收口。两者配合,才是自动化调优的正确打开方式。
另一个常见困惑是"为什么搜出来的结果换了多个种子就不稳"。这多半不是贝叶斯的问题,而是目标函数本身方差大(数据少、验证割折数小、评估噪声高)。遇到这种情况,先别急着怪搜索算法,回过头把验证协议做稳(加大割折、多次种子平均),再让自动化去搜。这和前面"尺子要稳"是同一件事——自动化算法只能在一个稳定的评估下才发挥作用。先稳评估,再谈"越搜越聪明"。
顺带提一下"多目标"的现实:很多真实任务不只一个验证指标,比如既要准又要快、既要召回又要保精度。贝叶斯优化也能处理多目标——把几个指标折成一个带各种权重的目标,或用专门的多目标采集策略同时逼近帕累托前沿。但前提仍是先把每个指标的验证都做稳,否则多目标的"稳"会乘上一个更大的噪声。我的建议是:尽量先收敛到一个主指标,把其他作为约束和参考;确有必要多目标时,再引入多目标搜索。把这个问题在动手前想清楚,比在搜索跑了一半时才到处找"哪个分数才算数"要省心得多。
本节要点回顾
- 要点一:贝叶斯优化 = 代理模型预估 + 采样函数在期望与探索间取平衡.
- 要点二:它把每次训练反馈逐个消化,一次比一次更靠近好点,适合昂贵训练。
- 要点三:进化用交叉变异迭代,对离散/混合空间宽容,但组数可能更多。
- 要点四:组数紧走贝叶斯,纯离散走进化,起手常先随机再精修。
- 要点五:自动化调优的前提仍是验证协议可信、信号归因清晰。
策略有了,最后一步是把它落进工具与一套可复现的实验管理。