7.3 模型剪枝与量化
7.3 模型剪枝与量化
本节摘要:当模型大到设备吞不下时,不只是"换个小的训",还可以直接给当前模型做手术。本节讲结构剪枝与权重剪枝去掉冗余、量化把浮点瘦成低精度,给出各手段省什么、伤什么,以及压完必须重训/微调的问题。
学习目标
阅读完本节,你应当能够:
- 区分剪枝(去结构/去冗余)与量化(压精度)两个维度。
- 说清剪枝后为什么要再训练来补偿精度损失。
- 判断你的模型是否值得压、压完会付出什么。
一、模型大了,除了"重训小的",还能"动手术"
知识蒸馏换了个小模型;而这一节,是在现有的模型本身上做减法。好多训练好的网络,里面的参数远超它真正用到的——剪枝就是把这些冗余去掉;而量化,是把每个数的存储精度从高浮点压到低精度,换取更小的体积与更快的推理。
二、剪枝:去掉不太重要的连接或结构
剪枝有两个粒度:
- 权重剪枝:把绝对值很小的权重直接置零。直观、灵活,但会得到不规则的稀疏结构,硬件利用往往一般。
- 结构剪枝:把一整层有通道或整块结构直接删掉。结构更加规则,落地到硬件更友好,通常也更省。常见判据是"该通道对输出的影响(重要度)低",就把它裁掉。
剪枝与量化的两条瘦身路径
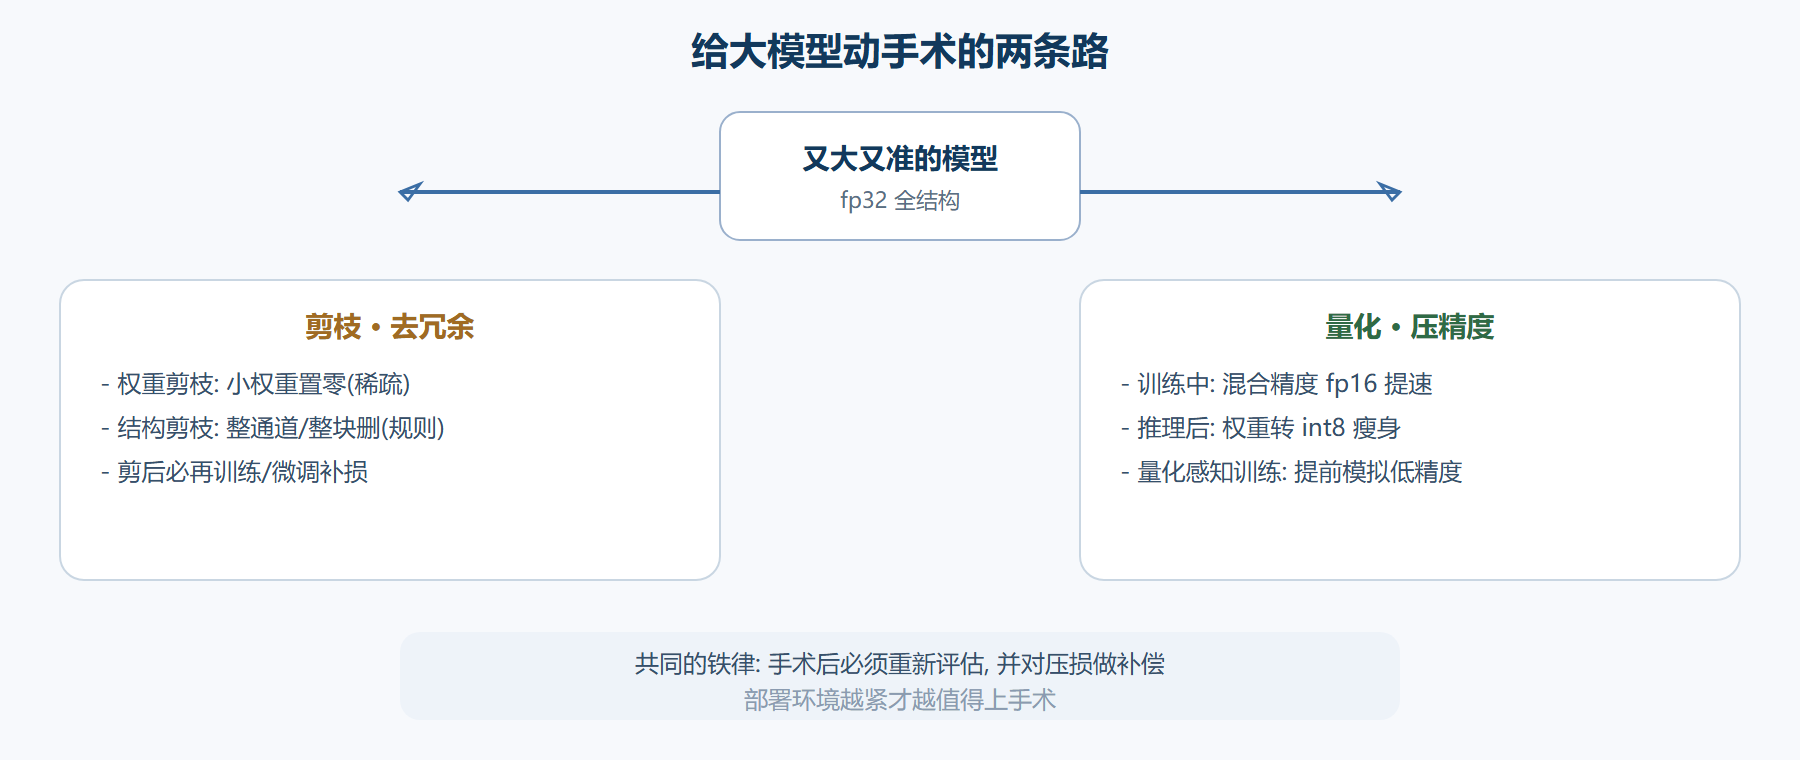
关键动作是**“先训一个又大又准的、再贪心剪、再微调补偿”**:一口气剪太多会崩,剪完要再训几轮把压损补回来。权重越小越快砍,但别一次砍猛,分几轮“剪-再训-再剪”更稳。
三、量化:把每笔账从浮点压成低精度
量化不在结构上动刀,而是改变数值的存储与计算精度。最典型的是把 fp32 压成 fp16 或 int8:
- 训练中(混合精度):用低精度加速前向与反向后,仍保留高精度的关键更新。这在分布式里尤其常见。
- 推理后量化:训练完成后,把权重量化为 int8,大幅压缩体积、提升推理速度。代价某些层可能略掉精度,于是有了"量化感知训练"——在训练时就模拟低精度损失来提前适应。
四、省什么、伤什么,一张对照
| 手段 | 动作 | 省下的 | 可能伤的 | 必要补做 |
|---|---|---|---|---|
| 权重剪枝 | 置零小权重 | 理论稀疏 | 精度 | 再训练补偿 |
| 结构剪枝 | 删整通道/块 | 体积/速度 | 精度 | 再训练补偿 |
| 量化(推理) | 权重转int8 | 体积/速度 | 精度 | 校验损失 |
| 量化感知训练 | 训练前半量化 | 速度/精度稳定 | 训练复杂度 | 校准 |
⚠️ 常见坑:只剪一个 seed、并把"剪+微调"当成不经过全量重训的捷径。剪枝/量化后的模型,必须在新验证上重新评估,并通常需要再训练或量化校准,别拿旧分数假装新模型.
💡 直觉:这些手段的本质都是"删除冗余,换取便宜"。判断值不值的标准很简单——你的部署环境(内存、单次推理延迟预算)到底紧不紧,紧才值得上手术,不紧就别自找精度损失的风险。
五、"先剪谁、剪多少"不是拍脑袋
剪枝最怕的不是"剪坏了",而是"不知道哪一刀是致命的"。一个负责任的流程是先把模型"体检"一遍:跑一遍验证,记录每个通道/块的重要度(有的是看它对输出损失的影响、有的是看它权重规模、有的是看能否被其他通道替代),按重要度从低到高排一个"牺牲名单"。然后再决定"这轮剪多少"——经验值是每轮只剪一小段、随后做一次微调评估再接着剪,而不是幻想"一次到位"。这种"度量-排序-渐进"的节奏,其实和调参里的"单因子、看验证"是同一套纪律:你在每次"剪一刀"前后都要能说出精确率变化了多少、因为什么变了。这样才能保证最后的模型不是一个"误伤了一堆关键结构、却只换来一点点体积"的半成品。
六、化整为零:剪枝与量化常常是组合拳
很多人把剪枝和量化当成二选一,实际上成熟方案往往是先剪再量化。理由是:剪枝先砍掉参数量、把有效的稀疏结构留下来;量化再把这些剩下的参数压到低精度。两件事叠加,往往能同时拿到"体积更小 + 推理更快"的两头好处,而任何一件单独做都只能吃它那部分的红利。当然叠加也意味着每一环都可能丢精度,所以一定要在剪完、量化完的最终模型上重新评估一次,而不是只看中间过程的分。这里有个执行提醒:评估用的那组验证样本要和训练/校准用的严格分开,否则你分不清"压得好"的结论是真压缩收益,还是又一场评估泄漏的幻觉。
七、什么时候"根本不值得压"
不是所有模型都该动手术。当部署环境充裕、又不缺精度时,保持原样往往是最省心的选择——每做一次压缩,都引入一层精度损失的风险和后续微调的维护成本。判断信号有三:一是模型体积、推理延迟是否真的越过了硬门槛;二是业务对精度的敏感度(压掉 1% 是否就跌破崩线);三是你的团队有没有能力为"压过的模型"做持续的再训练维护。如果三个答案都是"不紧、不敏感、不缺人手",那与其折腾,不如留着预算去做更值得的事。这种"知道自己不需要省"的判断,和"知道该省"一样,都是成熟的工程决策。
再补一个"压缩"这一步常被低估的工程点:工具的成熟度与复现成本。剪枝和量化如果靠手写算子去实现,容易在推理部署环节踩出各种"精度正常、但某种 CPU 指令下结果微妙地不同"的坑。成熟的选择是优先用框架自带的、被广泛验证过的算子与工具链(如量化感知训练、现成的剪枝接口),把"压缩"这一环的复现成本压到最低。毕竟你追求的是"最后部署出去又快又稳",而不是"证明自己能把 fp32 手工压成 int8"。把工程上的稳妥放在炫技之前,压缩才能真正落到生产里、而不是停留在实验记录上。
一句话收束本节:剪枝与量化给"模型大了装不下"多了一条不依赖"重训一个小模型"的出路,但每一分节省都以"重新验证精度"为代价。它们和知识蒸馏放在一起,其实是同一个问题的三种解法——换小、砍掉冗余、压低精度——选哪条取决于部署的瓶颈在哪里。把这套"看瓶颈在哪、再选压缩路径"的思路带在身上,你面对任何体积/速度/精度的权衡,都不至于手足无措。
本节要点回顾
- 要点一:剪枝去冗余(权重/结构),量化压精度(fp32到int8),两条互补路径。
- 要点二:剪枝要"先准后剪再补",别一次砍猛,分多轮剪-再训。
- 要点三:结构剪枝更规则、对硬件友好,权重剪枝灵活但稀疏硬件利用一般。
- 要点四:量化分训练中混合精度与推理后量化,推理后转int8最常用。
- 要点五:剪/量化后的模型必须重新评估并补偿精度,别拿旧分数冒充。