3.5 变基(Rebase)
3.5 变基(Rebase)
本节摘要:
git rebase把当前分支的提交"剪切重放"到目标分支之上,生成全新的提交,得到一条线性历史。本节讲清 rebase 的五步工作原理、它与 merge 的本质区别,介绍交互式变基(rebase -i)的 pick/reword/edit/squash/fixup/drop 六种操作,最后强调"绝不 rebase 共享提交"的黄金法则及其原因。
本节地图
阅读完本节,你应当能够:
- 用自己的话说清 rebase 的五步工作原理与"重写历史"的含义。
- 对比 merge 与 rebase 在历史形态、提交哈希、适用场景上的差异。
- 用 git rebase 把功能分支同步到主干,保持线性历史。
- 用 git rebase -i 对一系列提交做 reword、squash、fixup、drop、reorder。
- 解释"绝不 rebase 共享提交"的黄金法则及违反它的后果。
一、问题与直觉
先看一个场景:你的功能分支 feature 从 main 分出后,main 又前进了两个提交。现在 feature 想要拿到 main 的最新改动。两个选择:
- merge:把 main 合进 feature,产生一个合并提交,历史里出现分叉与汇合。
- rebase:把 feature 的提交"搬"到 main 的最新提交之后,看起来就像 feature 从头到尾都基于最新 main 开发的。
merge 诚实但历史带分叉;rebase 整洁但"动了历史"。
再想想另一个更日常的场景:你在 feature 上提交了五条——"添加页面""调试""修 typo""加注释""再调试"。这种杂乱的历史如果直接合并进主干,别人看历史会被噪音淹没。你希望在合回主干前,把这五条整理成一条干净的"实现登录功能"。这个"整理历史"的需求,只有 rebase -i 能满足。
这就是 rebase 的两大价值:把分支同步到最新基线(保持线性),和整理本地提交历史(让历史可读)。理解它的工作原理,你就知道它为什么强大、也为什么危险。
在深入之前,先给一个诚实的提醒:rebase 是本章最难的一节,也是争议最多的一节。Git 社区对"该不该用 rebase"吵了十几年,两边都有大量拥趸。吵的不是命令本身,而是"历史该诚实还是该整洁"这个价值观问题。所以本节不教你"必须用 rebase"或"永远别用 rebase",而是把机制、场景、代价都摊开——你带着自己的判断力去选。工具没有道德,用对场合就是好工具,用错场合就是事故源。
另一个常见的困惑值得先澄清:既然 rebase 会重写历史,它和"修改历史"(第 5 章)有什么区别?区别在重写的范围。rebase 重写的是"从某个基点以来的一条分支",目标明确、可回退;而第 5 章讲的历史修改(amend、rebase -i 到深处、filter-branch)范围更大、风险更高。本节先掌握 rebase 本身,第 5 章再在它的基础上玩更复杂的改写。
二、核心原理
rebase 的五步工作原理
当你在 feature 分支上执行 git rebase main,Git 依次做:
- 找共同祖先:定位 feature 和 main 的分叉点。
- 收集提交:把 feature 从共同祖先之后的所有提交"暂存"起来(按原顺序)。
- 移动基线:把 feature 指针移动到 main 的最新提交处。
- 逐个重放:把收集的提交按顺序重新应用(replay)到新基线上。
- 生成新提交:每重放一个就创建一个新提交对象——哈希和原来完全不同。
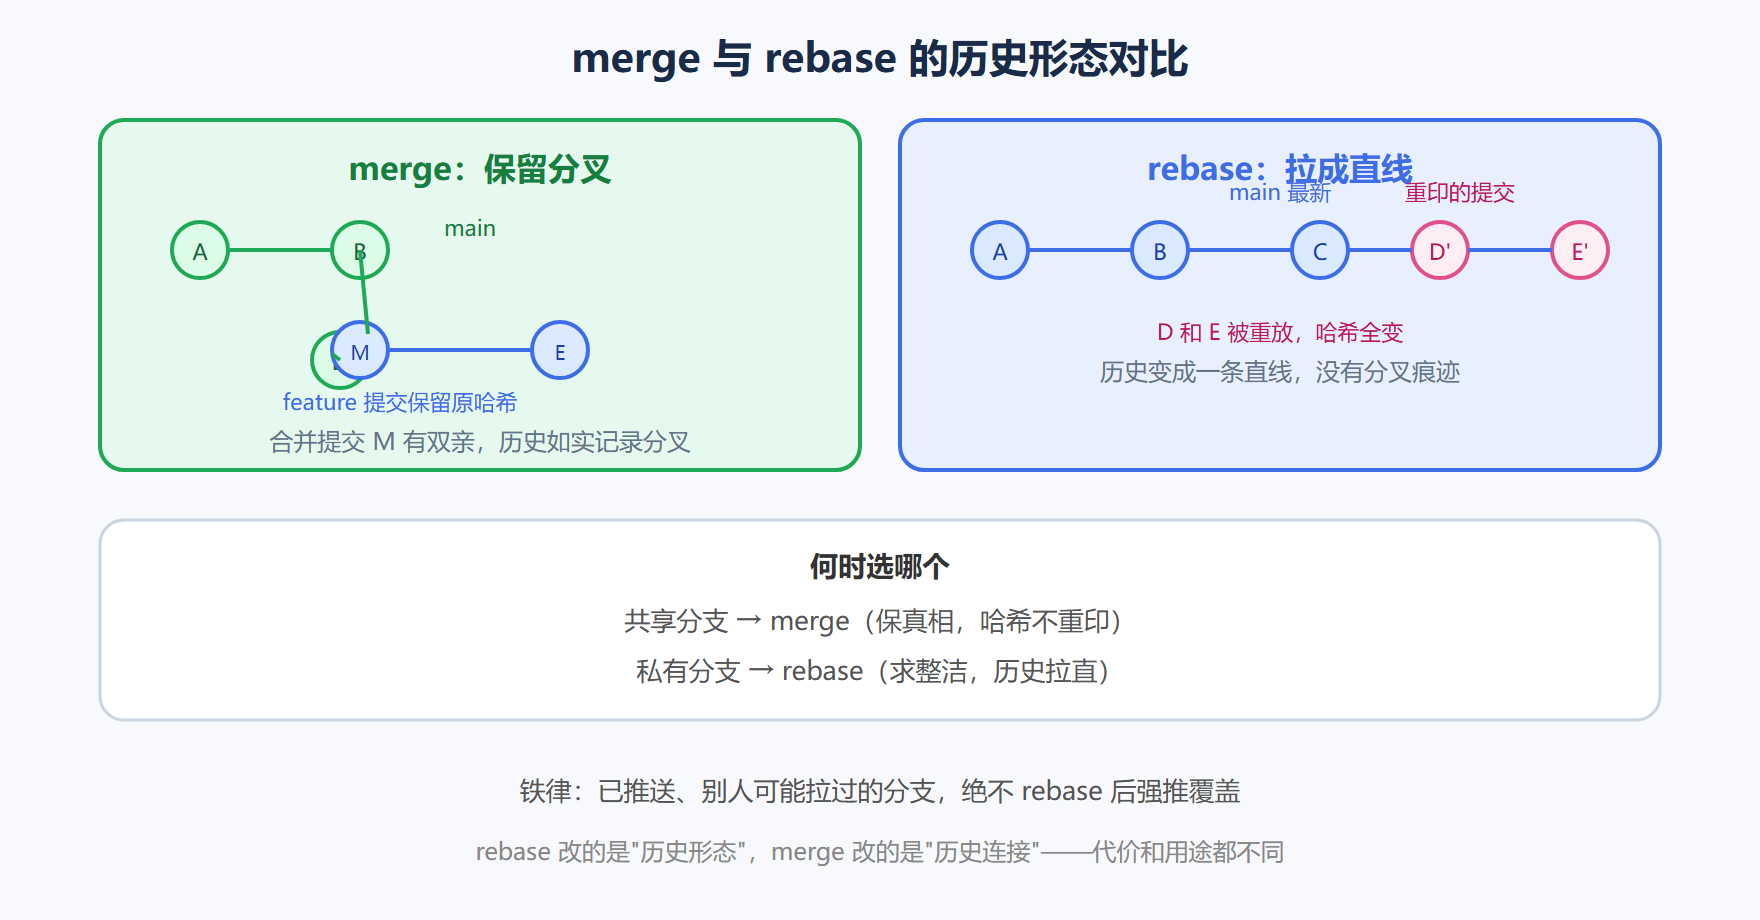
结果:feature 的提交链变成"main 最新提交 → 新 D' → 新 E'",看起来 feature 仿佛从未分叉过。
rebase 后,feature 的每个提交都被"重新印"了一遍——内容相同,身份证号(哈希)全换。这就是"重写历史"的准确含义。
rebase 与 merge 的本质对比
| 维度 | merge | rebase |
|---|---|---|
| 历史形态 | 保留分叉,产生合并提交 | 拉成直线,无合并提交 |
| 提交哈希 | 原提交哈希保留 | 被重放的提交哈希全变 |
| 对历史的影响 | 非破坏性 | 破坏性(改写本地历史) |
| 冲突处理 | 一次性处理 | 可能每个重放提交都冲突 |
| 适用场景 | 集成共享分支 | 整理本地私有分支 |
一句话总结:merge 是"把两段历史接起来",rebase 是"把一段历史挪到另一段之上并重印"。前者尊重历史,后者美化历史。
图 3-5 merge 与 rebase 的历史形态对比
交互式变基:rebase -i
git rebase -i HEAD~N 会打开编辑器,列出最近 N 个提交,每行一个,前缀是默认的 pick。把前缀改成不同命令,就能对该提交执行不同操作:
| 命令 | 含义 |
|---|---|
| pick | 保留该提交 |
| reword | 保留内容,修改提交信息 |
| edit | 保留并在应用时暂停,允许改内容 |
| squash | 与前一个提交合并,合并后编辑信息 |
| fixup | 与前一个提交合并,丢弃本提交的信息 |
| drop | 删除该提交 |
典型用法——把三条零碎提交合并成一条:
pick abcdef1 实现登录表单 squash 2345678 修 typo squash 9012345 补注释
保存退出后,Git 把后两条 squash 进第一条,并让你编辑合并后的提交信息。
黄金法则:绝不 rebase 共享提交
这是 rebase 最重要的规则:如果某个提交已经被推送到共享仓库、且别人已经基于它做了工作,就绝对不要 rebase 它。
原因很直接:rebase 重写提交哈希。你改了哈希,等于在别人不知情的情况下,把"他们脚下的地基"换掉了。他们的本地历史和你的新历史对不上,push 时被拒,pull 时一片混乱——整个团队为了你的一次"整理"付出巨大代价。
什么时候可以安全 rebase?
- 你私有的本地分支,从未推送。
- 你的功能分支,想同步最新 main(然后 push 时用 --force-with-lease 谨慎处理)。
- 你确认只有你在用这条分支。
拿不准时,用 merge,永远不亏。
一个能亲手观察的 rebase 实验
用最直白的命令序列,亲眼看到"哈希变了、历史拉直了":
git init rebase-demo && cd rebase-demo echo a > a.txt && git add . && git commit -m "C1" git switch -c feature echo b > b.txt && git add . && git commit -m "F1" echo c > c.txt && git add . && git commit -m "F2" git switch main echo d > d.txt && git add . && git commit -m "C2" git switch feature git log --oneline --graph --all # 看 rebase 前的分叉 git rebase main git log --oneline --graph --all # 看 rebase 后:feature 变成 main 的直线延伸
注意第二次 log 的输出:feature 的提交 F1、F2 的哈希变了,且历史变成了 C1 → C2 → F1' → F2' 的直线。对比 merge 的效果(会产生一个合并提交、保留原哈希),两种方式的分野一眼就清楚了。这个实验值得亲手做一次,它是理解"重写历史"最直观的教材。
rebase -i 的完整操作流
交互式变基的操作流相对固定,第一次做建议照着走:
git rebase -i HEAD~3 # 打开编辑器,列出最近 3 个提交
编辑器里把想改的行前缀改掉,比如把第二条改成 reword:
pick abcdef1 实现登录表单 reword 2345678 修 typo pick 9012345 补注释
保存退出后,Git 在应用第二条时停下来,打开另一个编辑器让你改提交信息——改成"完善登录表单细节"再保存。整个过程对 reword 来说就是"改个标题",对 squash/fixup 则是"合并内容并重新起名",对 edit 则是"暂停后手动改文件再 commit --amend"。
一个重要的纪律:rebase -i 前先 git log --oneline -n N 确认要整理的提交范围没选错。选错范围(比如把已经推送的提交也框进来)等于给自己挖坑。范围选对了,整理就是几分钟的顺手事。
三、工程实践要点
rebase 同步功能分支的标准动作
git switch feature git rebase main # 把 main 的最新提交作为新基线 # 若冲突:解决 → git add → git rebase --continue # 想放弃:git rebase --abort
冲突处理与 merge 类似,区别是可能要在每个被重放的提交上处理一遍。解决后 --continue 继续,--abort 放弃。
rebase 还是 merge:一张决策表
| 场景 | 推荐 |
|---|---|
| 把功能分支合回共享主干 | merge(或 --no-ff) |
| 个人私有分支同步最新主干 | rebase |
| 提交进共享分支前整理本地历史 | rebase -i |
| 任何人共享的分支 | 绝不 rebase |
| 想留"功能分支存在过"的证据 | merge --no-ff |
⚠️ 常见坑:对已推送的分支 rebase 后强制推送,把团队其他人推的提交冲掉。推送前确认分支是否共享;必须强推时优先 --force-with-lease 保护他人成果。
💡 关键直觉:把 merge 想成"把两卷胶带粘在一起,保留各自的纹路";rebase 想成"把一卷胶带剪下来,重新贴到另一卷的末端,纹路是新的"。胶带(内容)没变,但"身份"变了——这正是共享分支上绝对不能 rebase 的原因。
常见问题与 FAQ
"rebase 和 merge 哪个更好?" 不存在绝对更好。我的结论是:共享分支 merge(保真相),私有分支 rebase(求整洁)。很多人把"rebase 更高级"当信仰,但高级不等于合适——在共享分支上炫技,代价是队友的命。
"rebase 后还能找回原来的提交吗?" 能,用 reflog 或记下的旧哈希。rebase 只是让分支指针指向新提交,旧提交对象还在对象库里,直到被垃圾回收。所以 rebase 玩砸了,靠 reflog 一般能救(第 5 章)。
"rebase 遇到冲突,能中途放弃吗?" 能,git rebase --abort 会回到 rebase 前的状态,仿佛没发生过。这和 merge 的 --abort 类似,是保底退路。
"rebase -i 的 N 选多大合适?" 一次别贪多。N 越大,越可能撞冲突、越难理清。整理 2-5 个提交是舒服的范围;几十个提交的整理建议分批做,或先 squash 成几大块再细调。
"rebase 之后分支看起来像直线,那分支还存在吗?" 存在。rebase 只是让 feature 的历史"看起来"长在 main 后面,feature 指针依然指向重放后的最新提交。你之后仍然可以 merge 它(此时大概率快进合并)、继续提交、或者 push 它。直线只是历史形态,不是分支的终结。
rebase 里容易被忽略的三个细节
第一,rebase 不会移动目标分支。 执行 git rebase main 时,被移动的是当前分支(feature),main 的指针原地不动。这是新手常有的误解——以为 rebase 会"更新 main"。想更新 main,那得 main 自己 pull 或 merge。
第二,冲突解决后每个被重放的提交都要经过一次"应用"。 如果 feature 有 10 个提交且多个都改了同一区域,你可能会遇到多次冲突、多次 --continue。这比 merge 的一次性冲突繁琐,也是"rebase 整理大量提交"时要掂量的成本。
第三,rebase 之后 push 需要强制推送。 因为本地历史被重写,与远程的分支对不上,普通 push 会被拒。此时用 git push --force-with-lease——它比 --force 安全,只在"确认远程没有被别人动过"时才强推,是对共享分支的最后一道保护。很多团队事故都死在用 --force 无脑覆盖上,记住 --force-with-lease 永远优先。
一次 rebase 的完整时间线
把抽象步骤放进具体命令序列,你会看到 rebase 的真实节奏。假设 feature 分支从 main 分出后,main 又进了两条新提交,你现在想把 feature 对齐到最新 main:
git switch feature git log --oneline -5 # 先看自己的提交,心里有数 git rebase main # 开始变基:收走 feature 的提交 # 输出:First, rewinding head to replay your work on top of it... # Applying: 实现搜索功能 # Applying: 修复搜索排序 git log --oneline -5 # 变基后:feature 的提交接在 main 最新提交之后
如果中间某个提交应用时冲突,输出会变成:
Applying: 修复搜索排序 error: could not apply 3a4b5c6... 修复搜索排序 CONFLICT (content): Merge conflict in search.js
此时按 3.4 节的流程解决冲突、add、git rebase --continue;不想继续就 git rebase --abort。整个流程的体验是:rebase 帮你把"对齐主干"这件事拆成了几个小步骤,每一步都可以暂停、可反悔,最后把一条分叉的历史"缝合"成直线。
rebase 在团队里的两种常见用法
用法一:合并分支前清理本地历史。 功能开发了一周,本地攒了十几个"update"式提交。在提 PR 之前,用 rebase -i 把碎片提交 squash 成三四个有意义的提交,再 push。这样做的好处:review 的人看的是"3 个清晰的提交"而不是"15 条流水账",审查质量明显提升。
用法二:保持功能分支与主干同步。 团队频繁往 main 合代码,你的 feature 越拖越"落后"。定期 git rebase main 让 feature 始终基于最新主干,最后合回去时大概率快进合并、无冲突。注意:这个用法只适用于还没推送过的个人分支;已经推送、别人可能拉过的分支,用 merge main 而不是 rebase main。
一节小结
- rebase 本质:把当前分支的提交剪切重放到目标分支之上,重写历史。
- 五步原理:找祖先、收提交、移基线、逐次重放、生成新提交。
- 与 merge 对比:merge 保分叉与哈希,rebase 拉直线换哈希。
- rebase -i:pick/reword/edit/squash/fixup/drop 六种操作整理历史。
- 黄金法则:共享提交绝不 rebase,私有分支才安全。
- 冲突处理:--continue 继续、--abort 放弃,可能多次冲突。
- 决策表:共享用 merge、私有用 rebase、整理历史用 -i。
- 强制推送:必须强推时优先 --force-with-lease,别用裸 --force。
- 三个细节:rebase 不动目标分支、多次冲突可能、push 需强推。
- 心态:rebase 无道德属性,用对场合是利器,用错场合是事故源。
- 与第5章衔接:rebase 是历史改写的基础,第 5 章在其上玩更复杂的操作。
下一章进入远程协作:把本地仓库接到 GitHub/GitLab——clone、push、pull、远程分支跟踪。