4.2 克隆远程仓库(git clone)
4.2 克隆远程仓库(git clone)
本节摘要:
git clone是加入任何已有项目的标准姿势——它不只复制文件,而是把整个仓库(含全部历史、分支、标签)复制到本地,并自动配好 origin 关联与默认分支跟踪。本节拆解 clone 的五个内部步骤,覆盖指定目录、指定分支、浅克隆、单分支克隆、递归子模块等实用选项,并比较 HTTPS 与 SSH 两种协议。
本节导航
阅读完本节,你应当能够:
- 解释 clone 为什么"不只是下载文件"——它复制了整个仓库。
- 描述 clone 自动完成的五件事。
- 用 --branch、--depth、--single-branch、--recursive、--no-checkout 等选项定制克隆行为。
- 说清 HTTPS 与 SSH 协议的差异,按场景选择。
一、问题与直觉
想象你看到一个很酷的开源项目,想把它拿到本地研究、修改、甚至贡献代码。最直接的冲动是"下载 ZIP 压缩包"——但那是陷阱。ZIP 只给了你"当前快照",丢掉了全部历史、分支、标签,也丢掉了和原仓库的连接。你想看它的演进史?没有。想提交修改推回去?没有。想切换到某个老版本?没有。
git clone 的使命就是把这一切完整地带给你:它创建的不是一份"文件的拷贝",而是一个和远程平级的完整仓库。下载完,你的本地仓库拥有远程的全部历史、全部分支、全部标签,还自动记住了"我从哪里来"(origin),并已连接好可以推送回去。ZIP 下载是"借了本书的影印页",clone 是"拿到了整座图书馆的完整副本"。
这也是为什么开源参与的第一步永远是 clone 而不是下载 ZIP。理解了"clone = 完整复制 + 自动接线",后面所有远程操作就有了起点。
二、核心原理
clone 的五个内部步骤
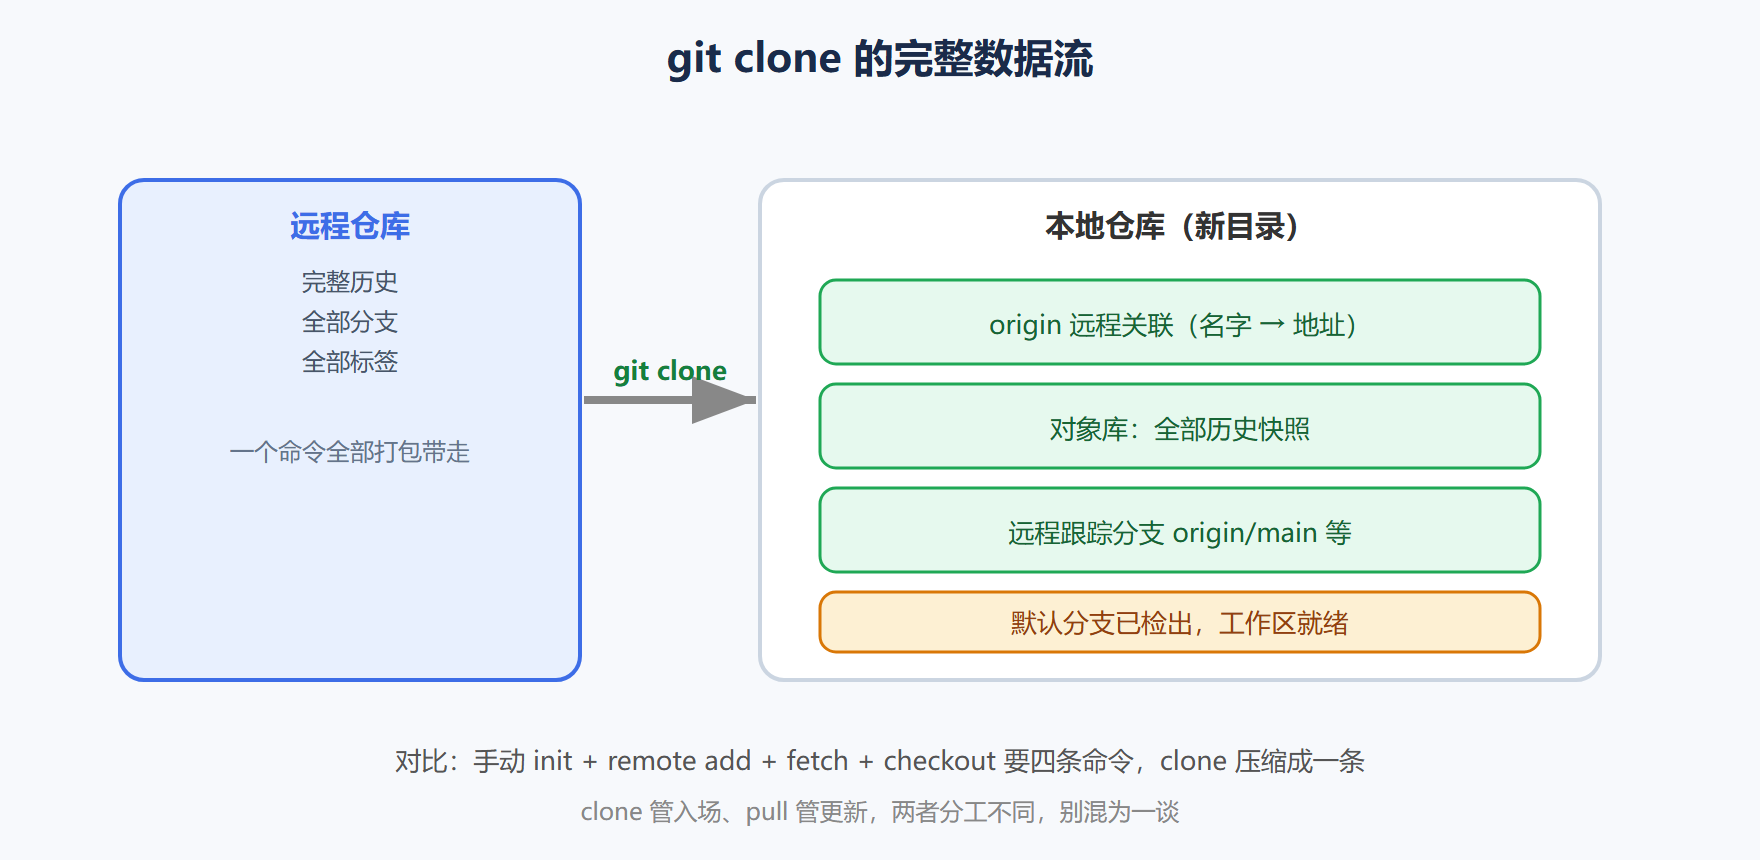
执行 git clone 远程地址 时,Git 依次完成:
- 创建目录:在当前位置创建新目录,默认用仓库名。
- 初始化仓库:在目录里执行相当于 git init 的动作。
- 登记 origin:把远程地址存为名为 origin 的远程关联。
- 下载全部数据:拉取所有提交、分支、标签到对象库。
- 检出默认分支:创建并检出 main/master,设置它跟踪 origin 的同名分支。
第五步的结果:你落地就在默认分支上,工作区是完整的可编辑状态,而且 git push/git pull 无需额外配置就能用——因为跟踪关系已经就位。
clone 是一站式"接入":目录、仓库、origin、数据、分支,五步全自动。相比"手动 init + remote add + fetch + checkout",clone 把四五个动作压缩成一条命令。
图 4-2 clone 的完整数据流
clone 的实用选项
指定本地目录名:
git clone 远程地址 my-project
不想用仓库名做目录名时指定。
指定要检出的分支:
git clone -b develop 远程地址
只影响"检出哪个分支"——数据仍全下载,只是默认站在 develop 而不是 main。
浅克隆(shallow clone):
git clone --depth 10 远程地址
只下载最近 10 次提交,大幅减少下载量与磁盘占用,适合大仓库的 CI 环境或只需最新代码的场景。代价:看不到完整历史,且与完整仓库协作时会有一些限制(如无法推送)。CI 环境常用。
单分支克隆:
git clone --single-branch --branch feature-x 远程地址
只下载指定分支的数据,进一步减小体积。适合"我只需要这一个分支"的场景。
克隆含子模块的仓库:
git clone --recursive 远程地址
克隆主仓库后自动初始化和更新子模块(第 5 章细讲子模块)。不含此选项,克隆后子模块目录是空的。
只下载不检出:
git clone --no-checkout 远程地址
下载全部数据但不检出任何分支,工作区为空。适合"只想研究历史"或"想在特定提交开始工作"的场景。
自定义 origin 名称
clone 默认把远程命名为 origin,但你可以指定其他名字:
git clone --origin upstream 远程地址
这个选项在 fork 工作流中很实用:你 clone 的是自己 fork 的仓库,但希望官方仓库叫 upstream,于是 clone 时直接指定,省得 clone 后再 rename。多远程协作时,给每个远程起一个语义清晰的名字(origin=自己的,upstream=官方的),能大幅降低混淆。
理解 clone 是"一次快照"
需要反复强调的一点:clone 建立的是"当时"的远程状态。克隆完成后,远程再发生任何变化(别人 push 了新提交、删了分支),你的本地不会自动感知。想要最新状态,必须主动 pull 或 fetch。
这解释了开发中常见的困惑:"我明明昨天 clone 的,今天怎么不是最新的?"——因为昨天 clone 之后,别人又推送过。你不是"没 clone 对",而是"没 pull"。clone 管入场,pull 管更新,两者分工不同,别混为一谈。
clone 后分支的完整形态
clone 完成后,git branch -a 通常会显示两类分支:本地只有默认分支(如 main),远程跟踪分支则列出远程的全部分支(origin/main、origin/develop、origin/feature-x 等)。这背后是 clone 的一个隐蔽细节:它下载了远程所有分支的数据,但只在本地创建了默认分支——其他分支以远程跟踪分支的形式待命,等你需要时再基于它们创建本地分支(4.6 节细讲)。
这意味着:你刚 clone 的仓库里,远程的分支"都看得见、都拿得到",但它们还没在本地落地。想切换到远程的某个分支开发,用 git switch 分支名 会自动基于同名远程分支创建本地跟踪分支;想只看看不动,用 git branch -r 列出来或 git log origin/develop 查看。这个"全量数据在手、分支按需落地"的设计,既保证了 clone 一次到位,又不让本地分支列表被远程几十个分支塞满——理解了它,branch -a 的输出就不再神秘。
协议选择:HTTPS 与 SSH
| 协议 | 优点 | 代价 |
|---|---|---|
| HTTPS | 配置简单,用账号/令牌认证,防火墙友好 | 每次 push 要验证,令牌管理要小心 |
| SSH | 配好密钥后免密、安全 | 需要生成并添加 SSH 密钥,首次配置稍繁琐 |
| Git(协议) | 快、免认证 | 只读为主,公共仓库才开放 |
| File | 本地路径直连 | 仅本机/局域网 |
新手建议:HTTPS 起步,把平台提供的 Personal Access Token 当密码用,几分钟搞定;熟悉后按需换 SSH,一次性配置,长期省心。
三、工程实践要点
clone 后第一时间做什么
git status:确认你在默认分支、工作区干净。git remote -v:确认 origin 指向正确。git log --oneline -n 5:看一眼项目最近的提交风格。git branch -a:看看有哪些本地和远程分支。
四步做完,你对这个仓库的"地形"就有了基本了解。
浅克隆的注意事项
浅克隆(--depth)看起来很美,但有两个隐藏代价:
- 无法完整地 push:浅仓库缺少历史,推送出去可能被远程拒绝,因为它只接收完整历史。
- 很多工具受限:合并、rebase、bisect 等操作在浅仓库上可能报错或行为异常。
结论:CI、快速试跑用浅克隆,正式开发环境别用。等你要在项目里长期开发,请 clone 完整仓库。
一个 clone 失败排错
clone 最常见的失败是认证问题(HTTPS 输错密码/令牌)或网络不通。排错顺序:
git clone 远程地址 # 报错 git remote -v # 如果已有仓库,先看 origin 配没配对 # 检查令牌/密码是否有效 # 换协议试试(HTTPS 不行换 SSH)
多数情况是认证凭据问题,更新令牌即可解决。
补充几个常见的具体报错:
- "Authentication failed":HTTPS 凭据错误,更新令牌或检查是否开了双重验证。
- "Could not resolve host":网络/域名问题,检查网络或代理设置。
- "Permission denied (publickey)":SSH 密钥没配好,检查是否添加了公钥到平台。
- "Repository not found":地址写错、仓库不存在,或对私有仓库没有访问权限。
每种报错都指向明确的方向,按图索骥就能定位。把报错信息当成诊断线索而不是天书,排错会快得多。
⚠️ 常见坑:clone 后直接改代码然后 push,结果 push 被拒(远程有新提交)。这不是 bug——clone 只是下载快照,远程之后又有人推送过,你需要先 pull 合并再推。4.4 节详细处理。
💡 关键直觉:把 clone 想成"办了张图书馆的全馆借阅卡"。刷卡(clone)之后,你借走的是整座馆的全部藏书(历史、分支、标签),还自动登记了"从哪个馆借的"(origin)。下次续借(pull)、还书(push)都不用重新办卡。
常见问题与 FAQ
"clone 和下载 ZIP 有什么本质区别?" ZIP 只有当前快照,没有历史、分支、标签,也没有远程连接;clone 是全量仓库 + origin 关联 + 跟踪分支。参与开发必须 clone,只想要一份文件快照才用 ZIP。
"clone 很慢怎么办?" 大仓库首克隆慢是正常的(要下载全部历史)。加速思路:网络代理、换协议、或临时用浅克隆(但注意代价)。持续开发的仓库,慢一次换永久便利。
"clone 后能改 origin 指向吗?" 能,用 git remote set-url(4.3 节)。比如远程仓库地址变更了,更新一下即可,不用重新 clone。
"clone 时想指定用户名?" 可以在地址里带上用户名(写在协议与地址之间),或用 SSH。多数场景 HTTPS 会缓存凭据,不需要每次手输。
"clone 下来的仓库能改名吗?" 能。clone 时用目录名参数,或 clone 后直接 mv 重命名目录。目录名只是文件系统的名字,不影响 Git 内部结构,改完照样 push/pull。
"一个远程仓库能被 clone 多次吗?" 能,克隆多少次都行。每人 clone 一份,形成多个本地仓库,各自 push/pull 回同一个远程——这正是分布式协作的标准形态。你甚至可以 clone 自己的仓库到两个目录,用它们模拟两个人的协作。
"clone 和 pull 是一回事吗?" 不是。clone 是"第一次接入",一次性拿全量并建好关联;pull 是"之后每次同步",只拉取增量。类比:clone 是领了张全馆借阅卡并把整个馆藏搬回家,pull 是之后每次借新上架的书。
clone 的四个典型场景
把 clone 放进真实场景,判断力会更清晰:
场景一:加入团队项目。 用完整克隆,配置好本地环境,开始开发。这是最标准的用法,没有捷径。
场景二:参与开源。 先 fork 到自己的账号,再 clone 自己的 fork(origin),加官方仓库为 upstream(--origin upstream 一步到位)。之后从 upstream 拉更新,往 origin 推提交,最后提 PR。
场景三:CI 构建。 每次构建都要最新代码,用浅克隆省时间省带宽。构建结果不需要历史,浅克隆完美契合。
场景四:快速试跑。 想看看某个项目长什么样、跑一下 demo,浅克隆或单分支克隆都行,快进快出。
四个场景里,"要历史还是要速度"是核心权衡:要完整开发就用全量克隆,只要最新状态就用浅克隆。想清楚这个权衡,clone 的选项就不再是"背下来的参数",而是"按需选的工具"。
最后说一个思维习惯:把 clone 视为"进入项目的第一道门",而不是"下载工具"。每次 clone 一个新项目,先花两分钟读历史(log)、看分支(branch -a)、读文档,你对项目的理解会远超"能编译"的层面。老练的工程师加入新项目时,第一步往往不是跑代码,而是读它的版本历史——那里藏着项目为什么长成这样的全部答案。这个习惯从你第一次 clone 就值得养成。
重点提炼
- clone 的本质:完整复制仓库(历史+分支+标签)+ 自动接线(origin+跟踪)。
- 五步流程:建目录、init、登记 origin、下载全部、检出默认分支。
- 常用选项:-b 指定分支、--depth 浅克隆、--single-branch、--recursive、--no-checkout。
- 协议选择:HTTPS 简单起步,SSH 免密进阶,Git 只读,File 本机。
- 浅克隆代价:不能完整 push、工具受限,正式开发用完整克隆。
- clone 后四查:status、remote -v、log、branch -a。
- 排错:多数 clone 失败是认证或网络问题,检查凭据与协议。
下一节管理连接:git remote 查看、添加、移除、重命名远程关联。