5.7 Git Submodule 子模块
5.7 Git Submodule 子模块
本节摘要:Git Submodule 让一个仓库把另一个独立仓库"嵌"进来做子目录,超项目只记录子模块的提交指针,不复制它的历史。本节先讲子模块的元数据原理(.gitmodules + 提交指针),再覆盖添加、克隆、更新、删除全流程,最后讨论嵌套子模块、常见陷阱与包管理器等替代方案。核心判断:子模块适合多仓拆分,简单依赖请交给包管理器。
读前必看(下)
阅读完本节,你应当能够:
- 说清超项目、子模块、提交指针三者的关系,理解 .gitmodules 的作用。
- 用 submodule add 添加子模块,用 --recurse-submodules 克隆含子模块的仓库。
- 手动或用 --remote 更新子模块指针,并在超项目里提交这个变化。
- 完整移除一个子模块,包括清理 .git/modules 残留。
- 权衡子模块与包管理器、Subtree 等方案的适用场景,避开常见陷阱。
一、问题与直觉
你的主项目要用到一个内部公共组件库——另一个团队维护的独立仓库,发布节奏和你完全不同。最简单粗暴的做法是把组件代码直接拷进你的项目目录。问题来了:组件更新了,你的拷贝还是旧的;组件修了个 bug,你要手动重新拷贝一次;更糟的是,这个组件的提交历史在你项目里完全没有,出了问题都不知道它改过什么。
另一种做法是把组件打成依赖包,用包管理器装——这对语言生态内的库很合适,但对"内部自研、跨项目共享、需要锁死版本"的组件未必好使:包还没发到私有源、或者你想直接对着组件源码调试。
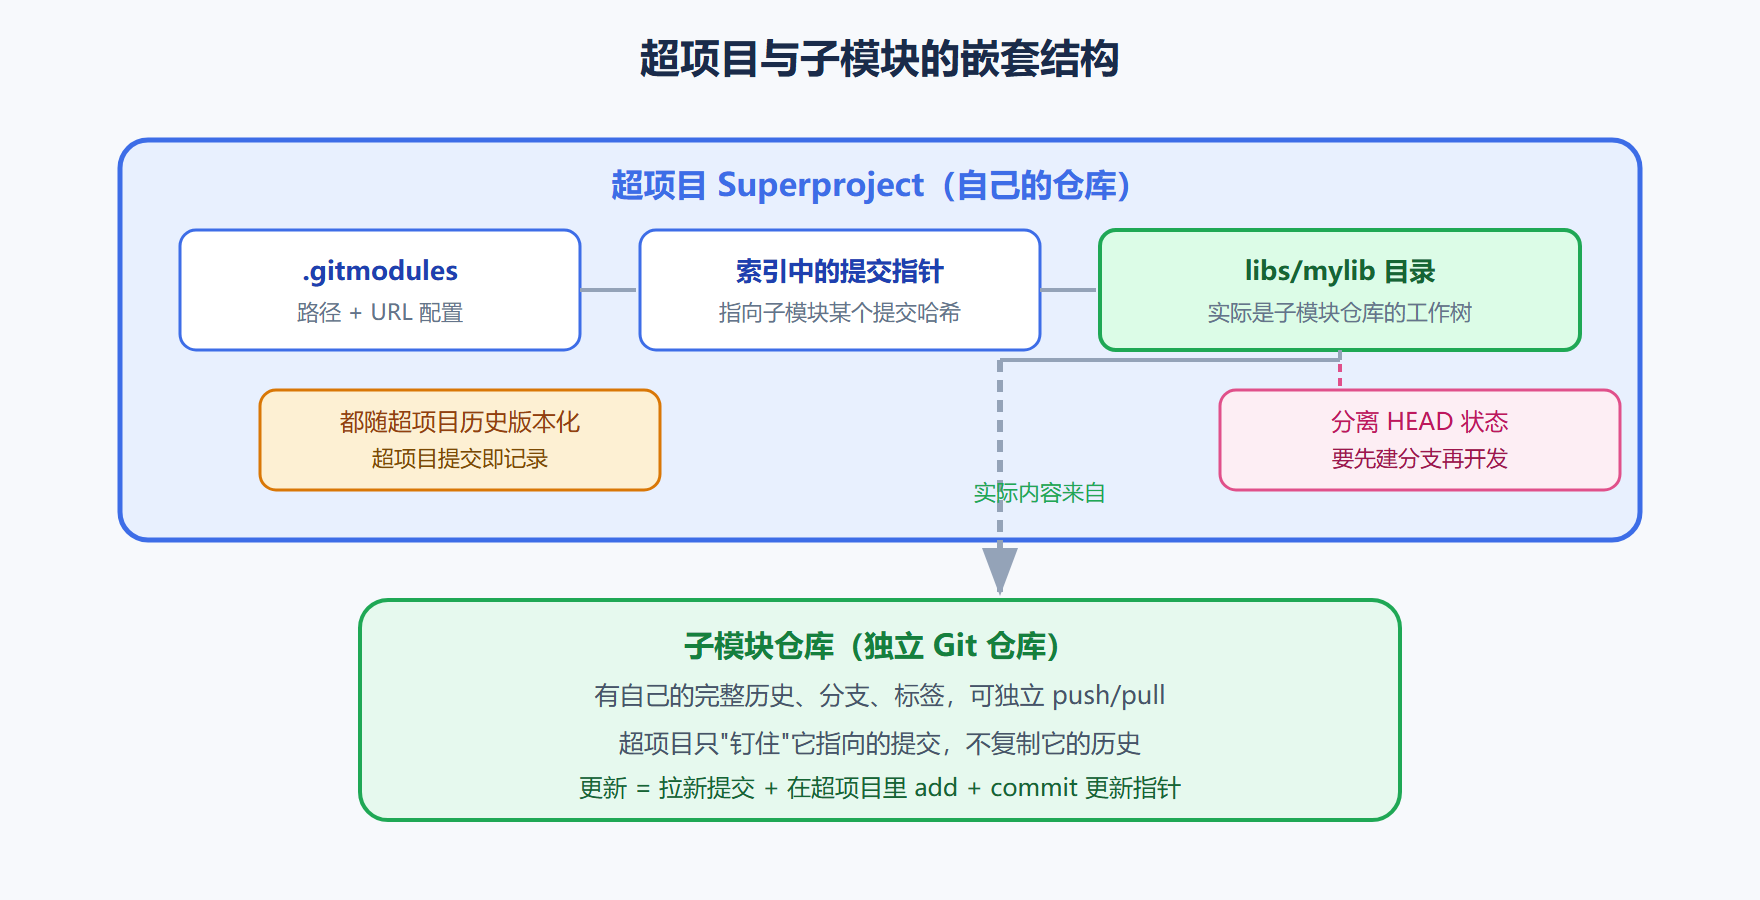
Git Submodule 解决的是"把一个独立 Git 仓库嵌进另一个 Git 仓库做子目录,同时两边各自保持独立版本控制"的问题。超项目(父仓库)不复制子模块的代码历史,只记录一句话:"我的这个目录下,应该放着子模块仓库的哪个提交"。子模块的版本、更新节奏、提交历史都归自己管;超项目只负责"钉住"它用到的那个版本。
类比仓储:主仓库是总仓,子模块是供应商的分仓。总仓不把供应商的货物全部囤进来(不复制历史),只在货架上贴一张卡:"这批货取自供应商的哪个批号"。供应商自己发新版(更新自己的仓库),总仓是否换批号,由总仓决定(更新指针并提交)。这样两边各自独立运作,又通过"批号卡"保持精确关联。
二、核心原理
子模块的元数据:一句话记两个文件
执行 git submodule add 时,超项目里发生两件事:
- 根目录生成/更新 .gitmodules 文件,记录每个子模块的路径和远程地址:
[submodule "libs/mylib"] path = libs/mylib url = https://example.com/team/mylib.git
- 在超项目的索引里,为子模块目录记下它当前指向的提交哈希——这个哈希是超项目版本的一部分,会被提交进超项目的历史。
所以超项目提交后,历史里躺着两个新东西:.gitmodules(路径+地址的配置)+ 子模块指针(一个哈希)。子模块自己的提交历史不在超项目里——想看组件改了啥,得进子模块目录看。
克隆含子模块的仓库时,默认子模块目录是空的(只有 .gitmodules 和指针,没有内容)。要拉出实际代码,需要初始化并更新。
添加子模块
git submodule add https://example.com/team/mylib.git libs/mylib
Git 克隆子模块到 libs/mylib,生成 .gitmodules,并在 status 里显示两个待提交项。然后提交超项目:
git add .gitmodules libs/mylib git commit -m "添加 mylib 子模块"
这一步不能省——不加提交,超项目历史里没有子模块记录,其他人克隆下来就是空的。
添加子模块
git submodule add https://example.com/team/mylib.git libs/mylib
Git 克隆子模块到 libs/mylib,生成 .gitmodules,并在 status 里显示两个待提交项。然后提交超项目:
git add .gitmodules libs/mylib git commit -m "添加 mylib 子模块"
图 5-7 超项目与子模块的嵌套结构
三、工程实践要点
克隆含子模块的仓库
一步到位(推荐):
git clone --recurse-submodules 主仓库地址
分步进行:
git clone 主仓库地址 cd 主仓库 git submodule init # 读 .gitmodules,写进本地配置 git submodule update # 克隆子模块并检出指针指向的提交
init + update 是经典组合,等价于 clone 时的 --recurse-submodules。记住:普通 clone 不含子模块内容,看到子模块目录空着别慌,init + update 即可。
更新子模块:谁来决定用哪个版本
子模块更新有两个层面,容易混:
层面一:子模块自己拉到最新
cd libs/mylib git pull origin main
这时子模块工作区的代码变了,但超项目记录的指针还是旧的——git status 会显示 libs/mylib 处于"修改"状态(因为它指向的提交和实际检出不一致)。
层面二:把新指针写进超项目
cd 超项目根目录 git add libs/mylib git commit -m "更新 mylib 到最新提交"
这才是关键动作:超项目要"换批号"得靠提交。如果你只在子模块里 pull,不在超项目里提交指针,那么其他人 clone/update 时拿到的还是旧指针——他们永远不会看到你的更新。
更自动化的批量方式:
git submodule update --remote libs/mylib # 把指定子模块切到其远程分支最新 git submodule update --remote # 全部子模块 git add . && git commit -m "更新全部子模块"
--remote 会进子模块拉取远程更新并切到最新,但仍然要你手动在超项目里 add + commit 记录新指针。想在 .gitmodules 里指定跟随哪个分支,可以给子模块加 branch 配置。
⚠️ 常见坑:在子模块里提交了新内容,却忘了回超项目 add + commit。结果就是"我自己改了组件,队友拉下来却是旧的"——这类 bug 最隐蔽,因为本地一切正常,错只错在指针没记录。
在子模块里开发:先建分支
子模块检出的是特定提交,处于分离 HEAD 状态。直接在里面提交,提交会"漂浮"在任何一个分支之外。正确姿势:
cd libs/mylib git checkout -b feature/xxx # 先建分支再开发 # 修改、提交、推送 git push origin feature/xxx cd .. # 回超项目 git add libs/mylib && git commit # 更新指针
开发流程的口诀是:进子模块先建分支,改完回超项目提交指针。两步缺一不可。
删除子模块:四步一个都不能少
git submodule deinit libs/mylib # 1. 清本地配置 git rm libs/mylib # 2. 从索引移除并删工作区内容 # 3. 手动从 .gitmodules 删对应段落 rm -rf .git/modules/libs/mylib # 4. 清理模块残留数据 git commit -m "移除 mylib 子模块"
最容易漏的是第 3、4 步——漏删 .gitmodules 段落,下次 clone 还会去找这个子模块;漏删 .git/modules 下的残留,仓库里埋着垃圾数据。
子模块 vs 替代方案
| 维度 | Submodule | 包管理器 | Subtree |
|---|---|---|---|
| 历史归属 | 超项目不存子模块历史 | 依赖版本由锁文件记录 | 外部历史并入超项目 |
| 版本控制 | 指针精确锁提交 | 语义化版本范围 | 跟着超项目历史走 |
| 更新复杂度 | 较高,双仓联动 | 一条命令 | 中 |
| 适用场景 | 多仓拆分、锁定精确版本 | 语言生态内的第三方依赖 | 想把外部项目完整纳入 |
| 协作成本 | 高,队友要理解指针 | 低 | 中 |
我的判断:大多数"引入外部库"的场景,包管理器是更优解——一条命令装依赖、锁文件锁版本、升级简单。Submodule 的真正价值在"你自己的多个相关项目要互相引用、且要锁死精确提交"的场景,比如微服务间的公共协议包、多仓共享的配置文件仓库。用之前先问一句:包管理器够不够?够,就别上 Submodule。
嵌套子模块的两个隐蔽坑
子模块里再嵌子模块,踩坑的概率成倍上升,两个最典型的:
坑一:更新顺序必须从里向外。git submodule update --recursive 会递归处理,但如果子模块的某个提交指向了一个"还没推送出去的更深层提交",递归更新就会失败——远端根本没有那个提交可检出。遇到这种情况,先确认深层子模块的提交已推送,再逐层 update。
坑二:克隆的递归参数别漏。外层仓库的 .gitmodules 里记录了子模块的地址,但子模块自己的 .gitmodules(嵌套关系)不会被外层记录——它藏在子模块仓库内部。所以克隆时必须 --recurse-submodules 或 --recursive,否则第二层及更深的子模块目录全是空的,而且报错信息还不太好懂。判断"我是不是漏了递归"的快速方法:克隆后看 git submodule status 输出,有目录显示 - 前缀就说明没初始化到。
一次典型的"指针漂移"排错
场景:队友报告"我 clone 下来的项目跑不起来,报错说找不到某依赖目录,而那个目录是子模块"。你本地明明跑得好好的。这类问题的九成原因是指针不一致:
- 队友 clone 时用了普通 git clone,子模块目录是空的——让他执行
git submodule update --init --recursive补上。 - 队友做了 update,但检出的是超项目历史里记录的旧指针——而你的开发基于新指针。这时更新超项目到最新(pull),再 update 子模块。
- 最隐蔽的一种:你在子模块里提交了新代码、也 push 了,但超项目里指向它的指针提交没 push。队友拉超项目时拉到的还是旧指针。自查方式:
git submodule status看你本地子模块的检出哈希,和超项目记录的是否一致。
这套排查顺序几乎覆盖了所有"子模块内容对不上"的场景。记住底层逻辑:超项目的指针才是契约,工作区里的实际代码只是契约的执行结果——对不上,先修契约。
💡 关键直觉:把子模块想成"供应商批号卡"。总仓(超项目)自己决定"用哪个批号"(提交指针),供应商自己更新货物(子模块仓库)。批号卡不更新,货物再新也不入库——指针是超项目和子模块之间的唯一契约。
常见问题与 FAQ
"子模块能不能也嵌套子模块?" 能。子模块里还能加子模块,形成嵌套。克隆和更新时要带 --recursive 递归处理。嵌套越多,操作越繁琐,通常该警惕——这往往说明项目拆分过度了。
"git pull 会更新子模块吗?" 默认不会自动更新子模块内容,只会更新超项目记录的指针。要同步实际代码需要 git submodule update --init --recursive。Git 2.14 之后 git pull --recurse-submodules 能一并处理,但很多人仍习惯手动 update。
"子模块切分支时老是显示脏状态,正常吗?" 正常。超项目切分支时,如果新分支指向的子模块提交和当前检出不一致,子模块就显示修改状态。此时运行 git submodule update 把子模块同步到新分支对应的提交即可,别在子模块里乱 reset。
"子模块把仓库搞乱了怎么办?" 先分清是子模块内部问题还是指针问题。子模块内部乱了,进子模块目录 git status/reset;指针不对,回超项目 git submodule update 重新检出指针指向的提交。冷静分步,问题都能拆解。
要点速记
- 子模块的本质:超项目记录"子目录 = 某仓库的某提交",不复制它的历史。
- 元数据两件套:.gitmodules(路径+地址)+ 索引中的提交指针。
- 克隆两法:--recurse-submodules 一步到位,或 init + update 分步。
- 更新双动作:子模块内 pull 只变本地代码,超项目 add + commit 才更新指针。
- 开发口诀:进子模块先建分支,改完回超项目提交指针,两步缺一不可。
- 删除四步:deinit、rm、删 .gitmodules 段落、清 .git/modules 残留。
- 适用边界:包管理器更简单,Submodule 留给"多仓精确锁版本"的场景。
- 嵌套要克制:--recursive 递归处理,嵌套过深说明拆分过度。
到这里,Git 从基础到进阶的完整地图就画完了。回到导读开头的那个问题——"改错了怎么办",现在你手里有了一整套答案:restore 救工作区、reflog 救历史、stash 救现场、bisect 查真相。把仓库想象成可以随便折腾的沙盘,剩下的就是练习了。