3.4 集中化存储与索引
3.4 集中化存储与索引
本节摘要:日志集中化不只是"把日志放到一个桶里",真正的功夫在索引模型——你愿意为查询速度花多少存储。本节对比三种主流路径的索引理念:以 Elasticsearch 为代表的全文索引、以 Loki 为代表的标签索引(不建全文索引)、以及 Splunk 为代表的商业索引方案。用"你想按字段搜还是按文本搜"这个分叉口帮你在选型间做决策,并给一张索引体积对比表。
集中化的三个层次
很多人理解的集中化就是"日志都进同一个平台"。其实要到第三个层次才算真,我按层次给你分:
- 第一层:日志收集到同一台机器/一个桶,但基本不可检索或只能翻文件。
- 第二层:能全文搜索,但没字段,精度低、速度慢。
- 第三层:结构化 + 索引,能秒级按字段精筛,能聚合,能和其它系统关联。
我们追求的目标永远是第三层。而决定你到不了第三层的瓶颈,往往就是索引模型选错了。
索引的本质是"查询速度 vs 存储成本"的互换
索引的原理一句话:提前为某些维度建好查找目录,查询时直接命中目录,不用全表扫描。但建索引要花钱——磁盘、内存、写入开销。所以一切索引策略都是在这笔交易里找平衡。集中化平台的区别,就是它们在"花多少钱买多快查询"上站位不同。
Elasticsearch:全文索引路线
Elasticsearch 为代表的路线(ELK 里的 E)会给每个日志的多个字段建倒排索引。好处是你的每条日志都能被任意文本搜索命中,查询秒级;代价是存储膨胀明显——索引体积常常是原始日志的几倍,一张 1TB 的日志,索引可能占掉 3TB。
所以 ES 路线适合"你必须全文搜、字段搜、聚合复杂"的场景:日志量中等、查询人需要很多自由维度、预算够撑起索引存储。Elasticsearch 生态里配套的还有 Kibana 做可视化,Logstash/Filebeat 做采集解析,加起来就是完整的 ELK。
原始日志 1TB └─ ES 索引(倒排+字段)≈ 3TB → 任意字段秒级检索、复杂聚合
Loki:标签索引路线(省存储)
Loki 走另一条路:它借鉴 Prometheus"万物皆标签"的思路,只对日志的标签建索引,不对日志正文建全文索引。查询时先用标签圈定一个范围,再在范围内做流式压缩匹配。
代价是:你想对正文任意搜索的时候,Loki 会表现为"扫描大片再过滤",远不如 ES 快;但换来的是存储极省——Loki 存的是压缩后的原始日志加少量标签索引,通常只有 ES 的几分之一到十分之一。
原始日志 1TB └─ Loki 标签索引 + 压缩正文 ≈ 0.3TB → 按标签圈范围,正文流式匹配
Loki 适合什么?日志量巨大、查询以"按服务/主机/标签圈范围再看正文"为主、不想为全文索引掏存储的钱。它跟 Grafana 同源,查logql像查指标一样方便。
Splunk:商业索引方案
Splunk 是成熟的商业化方案,索引模型偏向 ES 的全文理念但加了大量企业级能力:权限、审计、合规报表、机器学习、海量数据规模。贵,但大厂数据治理、安全合规要求高的场合很常见。
它的取舍:价格高、上手成本高,换来全套商业支持、深度机器学习、合规化。适合预算充足、对管理和安全合规有硬要求的组织。
三条路怎么选
给一个结构化的判断框架,你按自己场景对号入座:
| 路径 | 索引模型 | 查询灵活性 | 存储成本 | 适合场景 |
|---|---|---|---|---|
| ELK(ES) | 全文索引 | 极高,任意字段/全文 | 高(几倍原始) | 中等量、多自由查询、预算够 |
| Loki | 标签索引 | 中(先按标签圈范围) | 低(低一个数量级) | 海量、按标签查询为主、省钱 |
| Splunk | 商业全文+企业能力 | 极高+合规 | 最高 | 大厂、合规、安全审计硬要求 |
我的建议:中小团队、日志量大的选 Loki,省下的钱和运维精力很值;需要丰富自由查询和聚合、预算也不紧张的选 ES;要合规审计、财力充足的才上 Splunk。别一上来就冲着"最强"去,先算清楚你到底需要多大的查询自由度。
把代价讲透:同样的查询在两套系统里差多少
举一个具体对比,你会更直观。查询"过去一小时所有 order_id 是 A88 的支付失败日志":
- ES:直接命中 order_id 字段索引,秒级返回,不扫无关日志。
- Loki:如果 order_id 是标签,秒级;如果不是标签、只在正文里,那它会先按时间范围圈出所有日志,再逐条过滤正文,量大的时候就是分钟级。
同样是"能查到",查询人感知速度可以差出百倍。所以如果你要高频做这种礼服级精确过滤,光靠 Loki 的正文扫描不一定够;反过来,如果你大多数查询都是"这个服务这个级别今天出了什么错",Loki 的标签圈定够你用了。
两套索引模型的差异示意图
把 ELK 与 Loki 的索引差异放到一张图上,核心就一句:ELK 给正文和字段都建索引(查询快、存储贵),Loki 只给标签建索引(存储省、查询按标签圈范围再扫正文)。
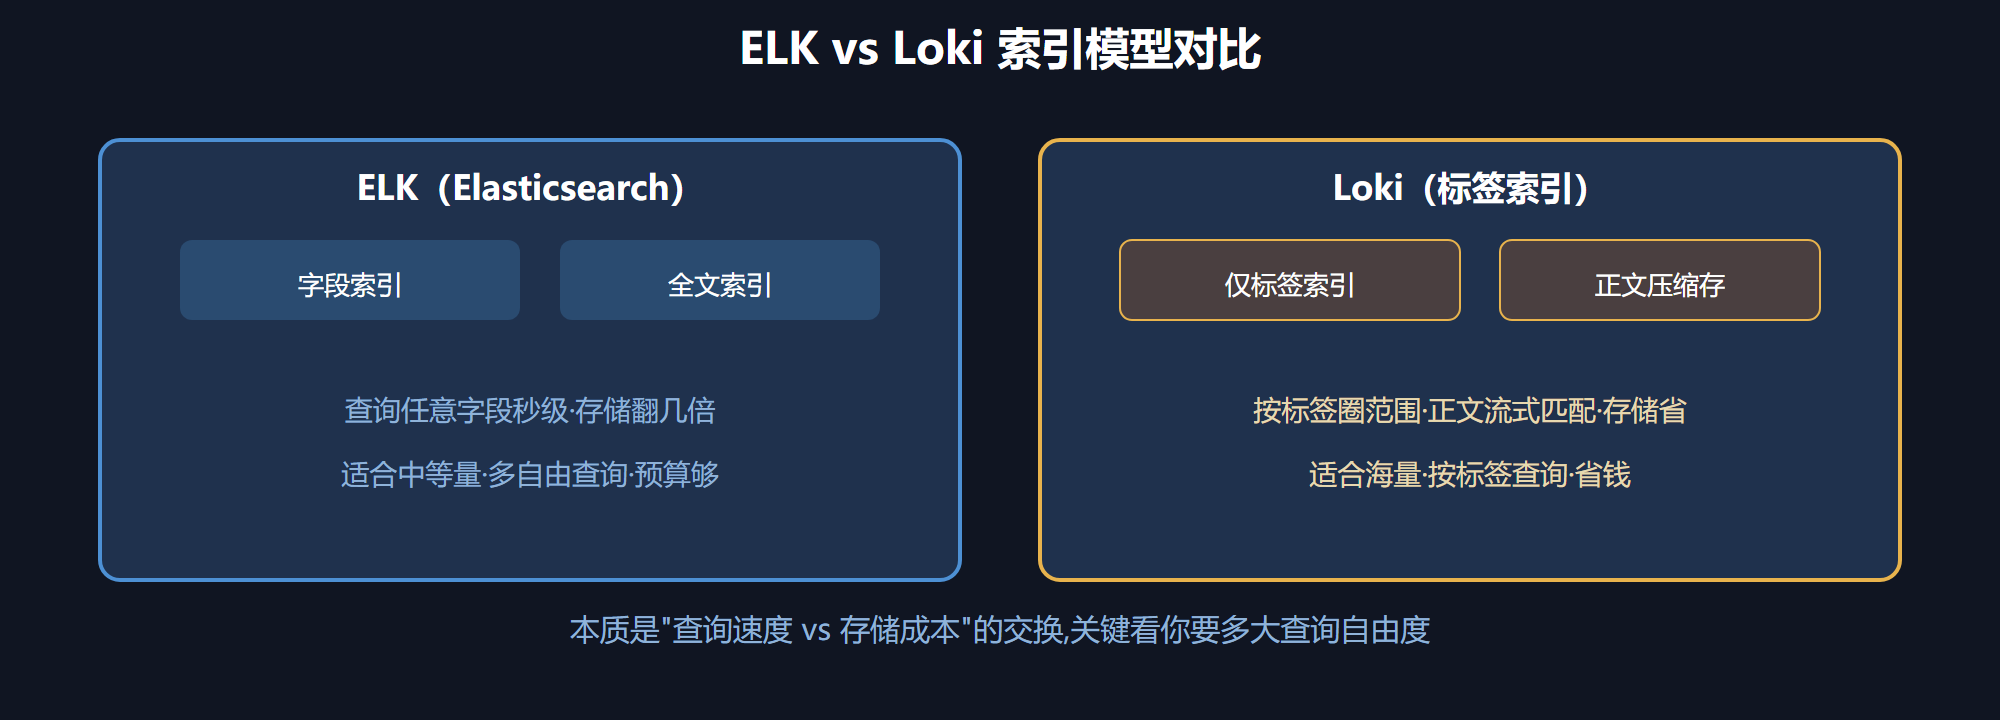
图 3-2 ELK 与 Loki 索引模型对比
选索引模型别只看现在的量
最后补一句关于增长。很多团队按"当前日志量"选型,日志少时觉得 ES 也够用、就随手选了 ES,却没想到半年后日志量翻了几倍,索引存储先烧起来。反过来,选了 Loki 的团队等真正要高频全文精确检索时才发现路线窄了。所以选型时给自己加一维"未来一年的预估量"与"未来查询形态的变化"——你未来是要越搜越细(那多加存储上 ES),还是要越录越省(那是 Loki 的主场)。索引模型一旦定下,迁移成本不低,值得多花一天把这两种走向都想清楚。
本节要点回顾
- 集中化分三层次:收集到桶、能全文搜、字段级索引与聚合,目标是第三层。
- 索引是存储换速度:提前建目录,买查询快,代价是成本和写入开销。
- ES 全文索引:任意字段秒级,但存储翻几倍,适合中等量多自由查询。
- Loki 标签索引:只索引标签不索引正文,存储省,按标签圈范围做正文流式匹配。
- Splunk 商业:全套能力+合规,最贵,适合大厂审计场景。
- 按查询自由度选型:算清楚你到底需要多大的全文自由,别为用不上的能力掏钱。
- 同样的查询差百倍:字段索引和正文扫描,在量大的场景里感知差距巨大。