4.2 搜索算法 Viterbi 与 Beam Search
4.2 搜索算法 Viterbi 与 Beam Search
面对那张巨大的状态网络,搜索都不能蛮干。维特比用动态规划精确捞出全局最优路径,但它在 ASR 里常常力不从心;束搜索用"每步只留最像的几条"换来了惊人的速度,成了工业界事实标准。本节把两者谁跟什么比、谁在什么场景赢讲透。
本节目标
- 能解释维特比"全局最优路径"到底怎么保证,代价是什么。
- 能说明束搜索怎么用"叶子只有 Beam 条活路"控制开销。
- 能比较两者在精度、速度、内存三个维度谁占优。
- 能给出选型决策:什么场景该用束搜索、什么场景值得维特比。
一、维特比:全球最优点到名的动态规划
维特比算法是动态规划在状态网络上的经典落法。它的核心是:只要一个状态走到当前时刻,能得到一个"到目前为止经过它的最佳路径分",那么到终点的全局最优路径,一定由这些局部最优拼接而成。道理像爬一道险峰,爬一个台阶只记下"这一级到这里的最高分怎么走的",整条最大路径靠分治自然浮出水面。维特比在 HMM 对齐里尤其好用——给定参数后,它总能给出无歧义的最优状态序列。
代价也很实在:它要求每一步都得把当前所有活命状态都摊开比,路径一多、词一长,内存和计算都吃紧。局部路径一旦中途被压成"已知不是全局最优",就没了翻盘机会;这适合那些目标清晰、可精确打分的场合。
二、束搜索:用怕面来拳快
束搜索的思路是干脆放弃"全局最优"这个执念:每一步只保留分数最高的 Beam 条路径(束宽 Beam Width 通常几十条),其余全砍;走完最后一步,从仅存的束里挑最好的。风险随之而来——真正的最优路如果在某一步被暂时比下去,就再也不可能出现。这是典型的"宁可错过也要快"。
束宽是束搜索的救命转盘:束宽开大,近似更接近全局最优、但更慢;束宽收小,速度快、但错过真答案的风险放大。实践里人们往往在验证集上反复试探,找一个既能提速又不致 WER 掉头的临界值。面面俱到的搜索比不过束搜索的"抓大放小"换来的流畅,这就是工业界几乎处处用束搜索的原因。
束搜索剪枝示意
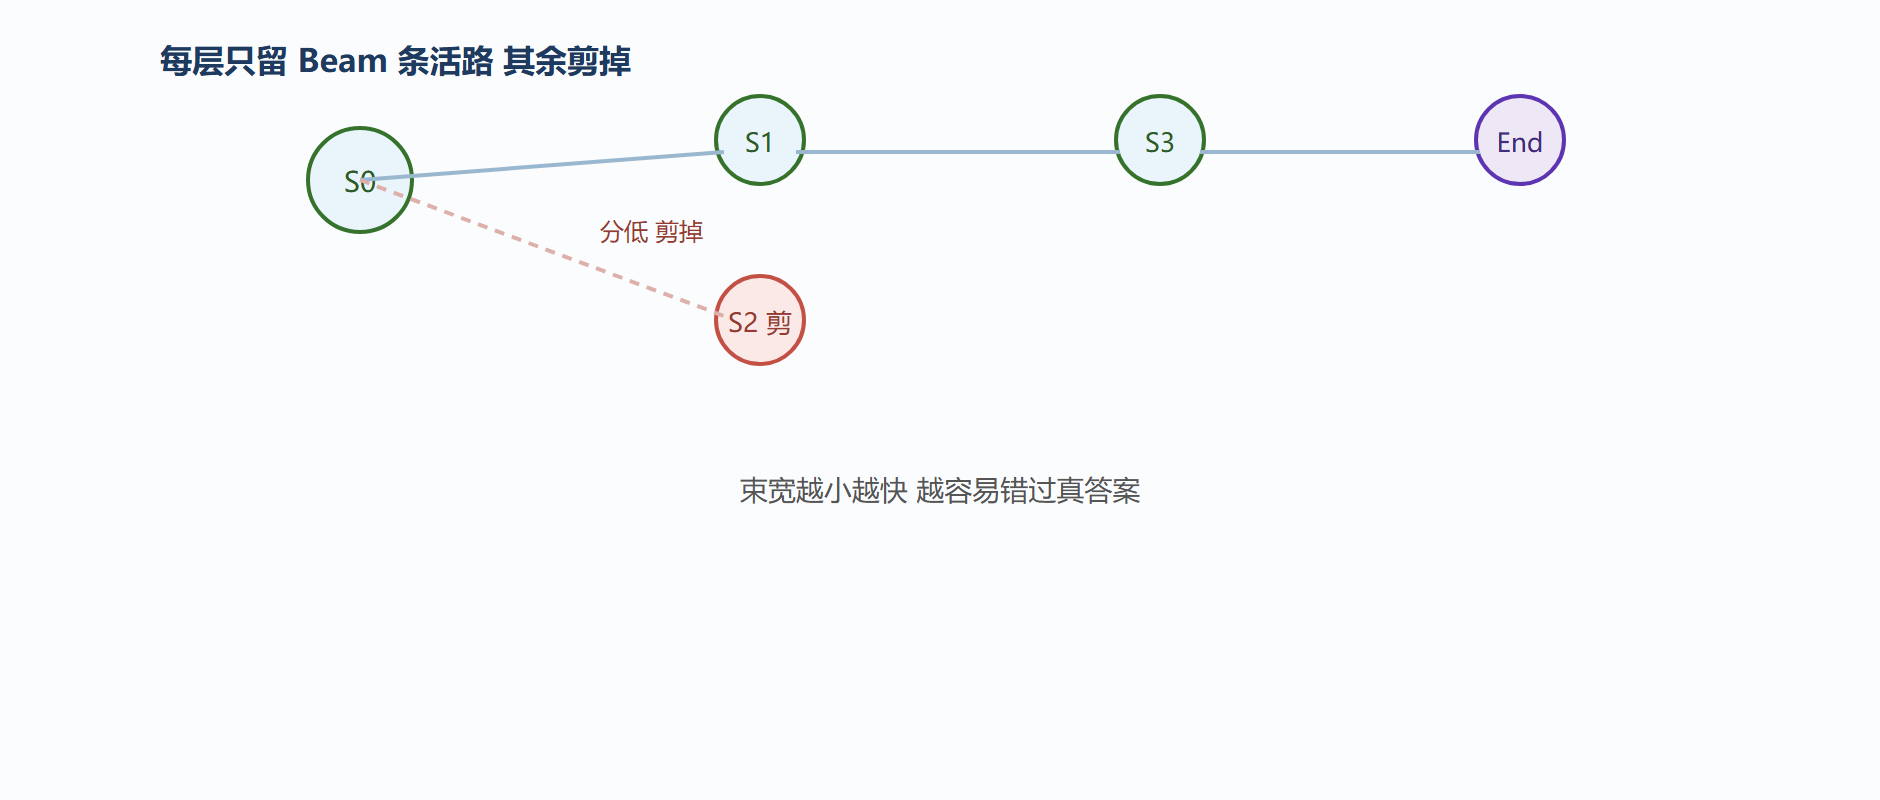
上面这张束搜索剪枝图:S2 这一步分太低,直接不探。
三、谁在什么场景赢
从三个维度摆一张对比:精度上维特比确优,但速度和内存都不敌束搜索。因此应用是分化的——需要小心翼翼对齐的 HMM 风格场景,维特比还是个可信的底座;需要处理海量候选、又快又稳的工业级解码,束搜索则是标配。后者甚至会配合多种束宽做两轮:第一轮小束宽飞快出候选,第二轮把候选拉大束宽再精修,跟语言模型重打分完美接上。
四、拿一条小路径把两种算法对峙一下
假设状态网络只有两条状态 A、B 与三段帧(共 3 步),每个状态每步的累积得分如下(数字越大越好):第 1 步 A=9、B=7;第 2 步 A=8、B=6;第 3 步 A=7、B=9。维特比算法会一直保留 A、B 两个活路,三步走完,比较全部 8 条路径,"A→A→B"累积 9+8+9=26 最高,于是它精确骗回最优。束搜索若收束宽到 1,则第 1 步只留 A(9>7),第 2 步顺着 A 只算 A→A(8)与 A→B(6),留下路径 A→A,第 3 步剩 A→A→A(24)与 A→A→B(26),只能在 26 这个"本地最优"上停。若是 A→B→B 和 A→B→A 这类早被剪掉的路径里藏着全局最优,束搜索就彻底错过了。
| 算法 | 保证全局最优 | 每步保留的活路 | 对长句/大词典 |
|---|---|---|---|
| 维特比 | 是 | 全部 | 内存与计算吃紧 |
| 束搜索 | 否(近似) | 至多 Beam 条 | 快而稳、可缩放 |
所以束搜索真正的妙处,不是每步都精明,而是"用一条剪得差不多的小路,换来对工业化量级可行"。
五、束宽之外,还有三个常用旋钮
别以为搜索就只有"束宽"一个可调项,工程里至少还有三处跟它配合。第一是"多轮重解码":先用小束宽飞快跑出 N-best,再在大束宽或更强模型上对这批候选重算一遍,兼顾速度与精度——这与第 3 章语言模型重打分是同一套路。第二是"剪枝阈值":不只看保留几条活路,还要看"分数低于当前最佳多少的路径直接砍掉",用一个绝对阈值控制剪枝的激进程度,束宽管纵向、阈值管横向。第三是"插入惩罚与词长惩罚":在决策里对每多说一个词施加代价,抑制"多出词"或"吞词"的系统性倾向,往往能从 WER 里撬出免费的一个点。
这三个旋钮看似各是各的,其实共享一个心法:搜索的核心不是"把所有路径都走完",而是"在每一次放弃里判断这条路径还值不值得继续走"。束宽决定纵向保留几条,阈值决定横向砍多狠,惩罚决定重不重视词边界。把这套"增减取舍"的心智练出来,你在任何资源受限的系统里都能把搜索调得又快又稳,而不是只会无脑加束宽、等一个更慢的结果。
束宽的直觉,用一个数字算落差更直观。一句话四个位置、每个位置 5 个候选词,若穷举要算 5 的 4 次方即 625 条完整路径;束宽收到 2,则每步至多留 2 条,总共考察的路径数锐减到几十,而且多数被砍掉的都是"局部就看得出来没戏"的。越是句子长、词表宽,束宽省下来的量越是呈指数级——这正是"抓大放小"换来可行性的硬账。反过来别忘它的代价:束宽一旦收得不合理,真句可能早在第 2 步就被甩出圈,后面再怎么精修都是无米之炊。等到第 5 章做全链路排错,这组旋钮会是你在"候选圈出事"这一类问题上最先下手的工具。
附、束宽到底该给多大
束宽不是拍脑袋定的,它是精度与速度的一笔交易。给太小,真正最优的路径可能在第一步就被剪掉,后面再也没机会翻盘;给太大,每步要并行的候选爆炸,速度成倍往下掉,却不一定换来成比例的准确。工程上常见做法是分层配束宽:第一遍用窄束快速圈出 N-best 候选,第二遍用宽束或更强模型在候选里精修。这样窄束保速度、宽束保精度两全,也是工业界几乎都用束搜索的最直白答案。
本节要点回顾
- 维特比:动态规划,全局最优路径,代价吃内存与速度。
- 束搜索:每层只留 Beam 条,拿怕面换拳快,是工业主流。
- 束宽权衡:开大近最优但慢,收小快但易错过真答案。
- 三围对比:维特比精度优,束搜索速度内存优。
- 分工:对齐用小维特比,解码用束搜索,两轮束宽可接力。
搜索算法定了,拼接时还有一个绕不开的开关——两套分怎么加权。下一节讲对数域与语言模型权重。