2.2 模型评估指标与交叉验证关卡
2.2 模型评估指标与交叉验证关卡
评估指标考点:混淆矩阵、精确率、召回率、F1、ROC 与 AUC、K 折交叉验证。通关标准:手工从混淆矩阵算出全套指标,并按业务代价选指标。这是面试出镜率最高的一关,也是上一关选好模型后的"验收法庭"。
关卡题目
关卡一(计算):某疾病筛查模型在测试集上的混淆矩阵为:真阳性 40,假阴性 10,假阳性 30,真阴性 920。求准确率、精确率、召回率与 F1。
关卡二(单选):垃圾邮件过滤场景中,把重要邮件误删的代价远高于让垃圾邮件漏进收件箱。调高决策阈值时,下列说法正确的是:
A. 精确率与召回率同时上升
B. 召回率通常下降,精确率通常上升
C. 精确率下降,召回率上升
D. 两者都不变
关卡三(单选):关于 AUC,下列说法错误的是:
A. AUC 等于随机取一正一负样本,模型给正样本打分更高的概率
B. AUC 等于零点五表示模型近似随机猜测
C. AUC 依赖具体决策阈值,阈值一变就要重算
D. 类别不平衡下 AUC 比准确率更能反映排序能力
关卡四(简答):为什么 K 折交叉验证前通常要做分层抽样?
先攻提示
- 关卡一先画二乘二矩阵再动笔,四个格子对号入座(行是真值、列是预测,或反之,先声明你的约定);
- 关卡二分清"精确率的分母是谁、召回率的分母是谁",再看阈值升高时哪些格子此消彼长;
- 关卡三回忆 AUC 的定义与阈值的关系;
- 关卡四想每折里的类别比例。
后核:标准解析
关卡一:总数 1000。准确率 = (40+920)/1000 = 0.96;精确率 = 40/(40+30) ≈ 0.571;召回率 = 40/(40+10) = 0.80;F1 = 2×0.571×0.80/(0.571+0.80) ≈ 0.667。注意这组数的教育意义:准确率九成六的模型,精确率只有五成七——报哪个数,结论完全不同。
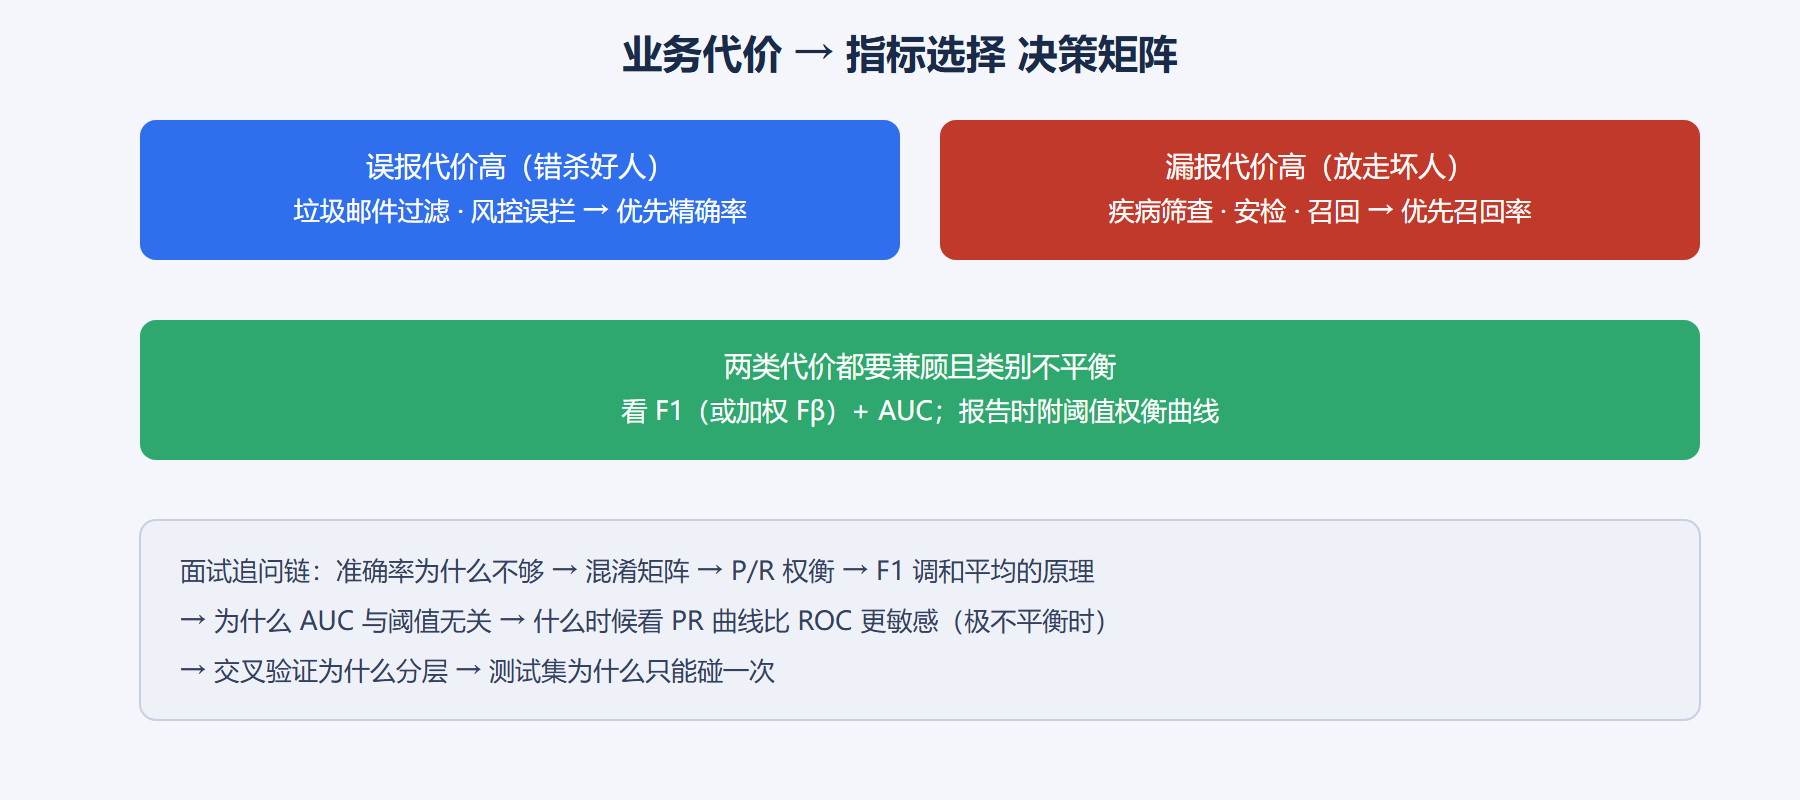
关卡二选 B。 阈值升高意味着模型更"惜报":预测为正的样本更少更精,假阳性通常下降(精确率升),但更多真患者被漏掉(假阴性升,召回率降)。反过来说,若漏诊代价高就该降阈值保召回。指标选择本质是业务代价结构的选择。
关卡三选 C(错误项)。 AUC 是 ROC 曲线下面积,遍历所有阈值计算,恰恰不依赖任何单一阈值。A 与 B 是标准等价描述;D 正确——这也是不平衡场景下推荐看 AUC 的原因。
关卡四:不分层的话,某折里正类比例可能严重偏离总体,该折上的指标失真,K 次平均的方差也被放大。分层抽样保证每折类别比例与整体一致,估计更稳。
手工复算关卡一,把四个指标一次算齐:
# 混淆矩阵全套指标手工复算 TP, FN, FP, TN = 40, 10, 30, 920 total = TP + FN + FP + TN acc = (TP + TN) / total precision = TP / (TP + FP) recall = TP / (TP + FN) f1 = 2 * precision * recall / (precision + recall) print(f"准确率 = {acc:.4f}") print(f"精确率 = {precision:.4f}") print(f"召回率 = {recall:.4f}") print(f"F1 = {f1:.4f}") # 输出: # 准确率 = 0.9600 # 精确率 = 0.5714 # 召回率 = 0.8000 # F1 = 0.6667
再演示"阈值扫描"如何生成一条权衡曲线,看 B 选项的规律在数值里显形:
# 阈值扫描:精确率与召回率的此消彼长 scores = [0.95, 0.90, 0.80, 0.70, 0.60, 0.40, 0.30] # 模型打分 labels = [1, 1, 0, 1, 0, 0, 1 ] # 真实标签 for t in [0.85, 0.65, 0.45]: pred = [1 if s >= t else 0 for s in scores] TP = sum(1 for p, y in zip(pred, labels) if p == 1 and y == 1) FP = sum(1 for p, y in zip(pred, labels) if p == 1 and y == 0) FN = sum(1 for p, y in zip(pred, labels) if p == 0 and y == 1) P = TP / (TP + FP) if TP + FP else 0.0 R = TP / (TP + FN) if TP + FN else 0.0 print(f"阈值 {t:.2f} → 精确率 {P:.2f}, 召回率 {R:.2f}") # 输出: # 阈值 0.85 → 精确率 1.00, 召回率 0.50 # 阈值 0.65 → 精确率 0.75, 召回率 0.75 # 阈值 0.45 → 精确率 0.60, 召回率 0.75
最后用 K 折划分做一个五折交叉验证的骨架演练(模型用最简单的均值预测器示意流程):
# 五折交叉验证骨架(含分层示意) import random random.seed(7) data = list(range(25)) random.shuffle(data) folds = [data[i::5] for i in range(5)] # 轮转式切五折 for i, val in enumerate(folds): train = [x for j, f in enumerate(folds) if j != i for x in f] print(f"第{i+1}折:训练 {len(train)} 条 / 验证 {len(val)} 条 / 验证集={val}") # 输出: # 第1折:训练 20 条 / 验证 5 条 / 验证集=[13, 16, 15, 21, 1] # 第2折:训练 20 条 / 验证 5 条 / 验证集=[19, 7, 0, 11, 20] # 第3折:训练 20 条 / 验证 5 条 / 验证集=[5, 24, 18, 3, 12] # 第4折:训练 20 条 / 验证 5 条 / 验证集=[22, 9, 8, 17, 4] # 第5折:训练 20 条 / 验证 5 条 / 验证集=[23, 6, 14, 2, 10]
图:指标选择的决策矩阵
复盘:易错点与变式
易错点一:混淆矩阵四个格子的位置记忆混乱。自编口诀"行真列预,先写条件":精确率问"我说是阳的里面多少真是"(列内看),召回率问"真是阳的里面我抓到多少"(行内看)。
易错点二:F1 用算术平均代替调和平均。算术平均会被单边指标虚高:精确率一、召回率零的废物模型,算术平均零点五看着及格,调和平均是零——这正是选调和平均的理由。
变式一:把场景换成"癌症初筛后还有复筛",问初筛模型该保精确率还是召回率。标准答法:初筛保召回(宁可多送复筛,不能漏),复筛保精确率(确诊干预的代价高)。指标选择嵌进了流水线结构。
变式二:面试官给出"F1 很高但线上体验差",问可能原因。高分答法:训练与线上分布不一致(时间漂移、样本选择偏差)、阈值未按线上代价校准、评估集泄漏了未来信息——把指标问题上升到分布与流程层面。
复盘产出:在决策卡上加一栏"业务代价 → 主指标"。下一关处理指标难看时的诊断:到底是模型太笨还是记性太好。