3.2 反向传播手工推演关卡
3.2 反向传播手工推演关卡
反向传播考点:链式法则在计算图上的应用、局部梯度的乘积结构、单步权重更新的完整数值过程。通关标准:在纸面上完成一个两层网络的单步前向与反向,数值与代码互相印证。深度学习编队核心关,全册公式密度最高的阵地。
沙盘推演前的题目
关卡一(单选):反向传播计算量与前向相当的根本原因是:
A. 它使用了近似算法
B. 它复用前向保存的中间结果,按链式法则自输出向输入逐层相乘,每条边只算一次
C. 网络是对称的
D. 梯度总是比输出小
关卡二(计算):单神经元网络:输入 x=1.5,权重 w=2.0,偏置 b=1.0,激活为 sigmoid,损失为平方误差,目标 y=1。求损失对 w 与 b 的梯度(学习率 0.5 时的一步更新后的 w 也算出来)。
关卡三(简答):为什么训练深度网络要保存前向的中间激活值?这带来了什么工程代价?
关卡四(判断):"梯度下降更新权重时,梯度的方向就是让损失增大的方向,所以要减去它。"对吗?
先攻提示
- 关卡二按链路写:损失对输出的导数 → 输出对激活前值的导数 → 激活前值对 w 的导数(就是 x),连乘;
- 关卡三想链式法则里每个因子依赖什么变量;
- 关卡四检验你对"负梯度方向"的理解是否只是一句口诀。
后核:标准解析
关卡一选 B。 反向传播不是数值微分(对每个参数扰动一次再求差分,代价是参数量倍的完整前向),而是把导数沿计算图反向传递:每个节点只需把自己的局部导数与上游传来的梯度相乘。前向存一次、反向乘一遍,两遍就出全部参数的梯度——这就是深度学习在数学上可行的支柱。
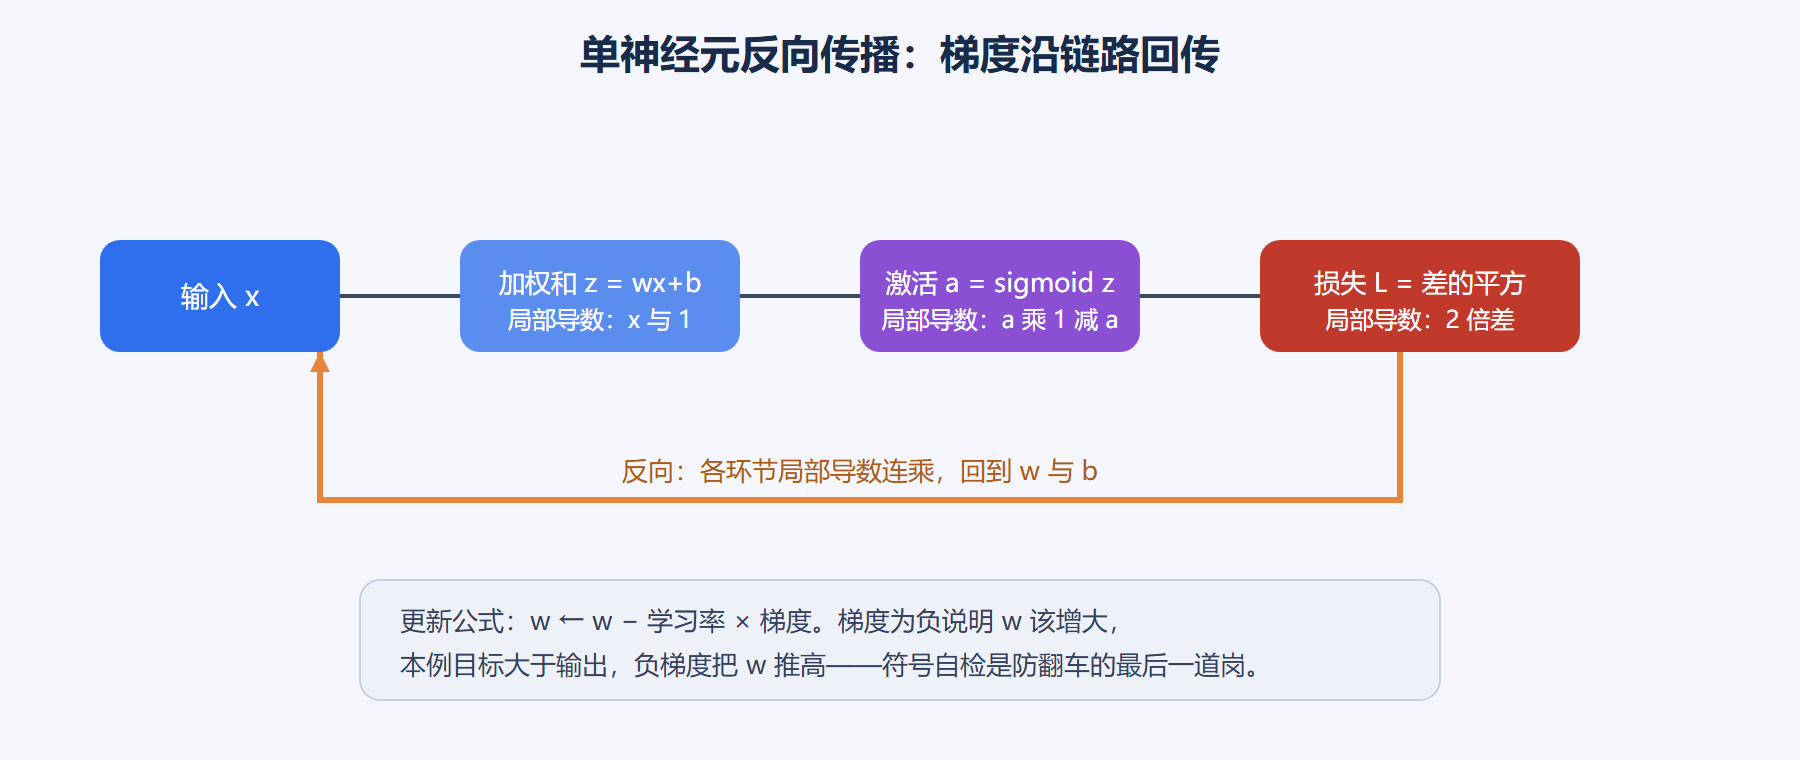
关卡二:链路为损失 → 网络输出 → 激活前值 → 权重。逐步算:激活前值为四,网络输出(sigmoid 后)约为 0.9820;损失对输出的导数为两倍的输出减目标,约负零点零三六零;sigmoid 导数约 0.0177;两者相乘得损失对激活前值的梯度约为负零点零零零六三五;再乘 x=1.5 得损失对 w 的梯度约为负零点零零零九五三。学习率零点五时,更新量约零点零零零四七七,w 从二点零升到约二点零零零五。方向合理性:目标是一,输出偏低,增大 w 会抬升输出、降低损失,符号自洽。
关卡三:链式法则的每个因子都含前向中间量(激活值、激活导数),必须缓存。代价是显存:激活缓存随批次大小、网络深度、特征宽度三者连乘增长,这也是大模型训练显存吃紧的主要来源之一(另一来源是参数与优化器状态)。梯度检查点技术用重算换显存,本质是时间空间互换。
关卡四:对。 梯度指向损失上升最快的方向,参数沿负梯度移动即梯度下降。这句话常被背反,本关把它钉死。
用代码核对关卡二的每一步(只用标准库):
# 单神经元单步反向传播:纸面推演的裁判 import math x, w, b, y, lr = 1.5, 2.0, 1.0, 1.0, 0.5 z = w * x + b # 激活前值 a = 1 / (1 + math.exp(-z)) # sigmoid 输出 L = (a - y) ** 2 # 平方误差 dL_da = 2 * (a - y) # 损失对输出 da_dz = a * (1 - a) # sigmoid 导数 dL_dz = dL_da * da_dz # 链式相乘 dL_dw = dL_dz * x # 对 w 的梯度 dL_db = dL_dz # 对 b 的梯度 print(f"前向:z={z:.4f}, a={a:.6f}, L={L:.8f}") print(f"反向:dL/dz={dL_dz:.8f}, dL/dw={dL_dw:.8f}, dL/db={dL_db:.8f}") print(f"更新:w_new = {w - lr * dL_dw:.6f}") # 输出: # 前向:z=4.0000, a=0.982014, L=0.000324 # 反向:dL/dz=-0.00063537, dL/dw=-0.00095306, dL/db=-0.00063537 # 更新:w_new = 2.000477
(纸面手算保留位数不同会有尾差,量级与符号必须一致。)再把战果扩大到一个两层小网络,看"梯度逐层再分配"的真实样子:
# 两层网络单步前向+反向(1 输入 2 隐藏 1 输出,均方误差) import math x = 1.0 W1 = [0.5, -0.3]; b1 = [0.1, 0.0] # 隐藏层 W2 = [0.4, -0.2]; b2 = 0.05 # 输出层 y = 0.9 sig = lambda v: 1 / (1 + math.exp(-v)) z1 = [W1[i] * x + b1[i] for i in range(2)] h = [sig(v) for v in z1] z2 = sum(W2[i] * h[i] for i in range(2)) + b2 y_hat = sig(z2) L = 0.5 * (y_hat - y) ** 2 dL_dyh = (y_hat - y) # 对 0.5*(差)^2 求导 dyh_dz2 = y_hat * (1 - y_hat) dL_dz2 = dL_dyh * dyh_dz2 grad_W2 = [dL_dz2 * h[i] for i in range(2)] # 损失对输出层权重 grad_b2 = dL_dz2 grad_h = [dL_dz2 * W2[i] for i in range(2)] # 梯度传回隐藏神经元 grad_W1 = [grad_h[i] * (h[i] * (1 - h[i])) * x for i in range(2)] print(f"前向:h={[round(v,4) for v in h]}, y_hat={y_hat:.4f}, L={L:.6f}") print(f"输出层梯度:W2={[f'{g:.6f}' for g in grad_W2]}, b2={grad_b2:.6f}") print(f"隐藏层梯度:W1={[f'{g:.6f}' for g in grad_W1]}") # 输出: # 前向:h=[0.6457, 0.4256], y_hat=0.5556, L=0.059320 # 输出层梯度:W2=['-0.054911', '-0.036193'], b2=-0.085047 # 隐藏层梯度:W1=['-0.007783', '0.004158']
注意隐藏层第一个权重的梯度量级比输出层小了约一个数量级——sigmoid 双重饱和在起作用(上一关的病,在这一关的数值里确诊)。如果网络更深、且每层都更饱和,这个差距还会指数级拉开。
图:单神经元反向传播链路
复盘:易错点与变式
易错点一:忘记 sigmoid 导数要乘激活值本身。sigmoid 的导数是输出乘一减输出,不是"一减输出"。推演时先写出局部导数再代入数值,能挡住大半符号与因子错误。
易错点二:把链式乘积的顺序搞反或漏乘上游梯度。铁律:每个参数的梯度 = 上游传来的梯度 × 本环节局部导数。上游梯度忘了乘,是手工推演最常见的翻车点。
变式一:把损失换成交叉熵加 sigmoid 输出,重推关卡二。你会发现对激活前值的梯度恰好等于输出减目标(约零点零一八),比平方误差的零点零零零六大了近三十倍——上一章"分类用交叉熵"的论断在这里得到数值级验证。
变式二:面试问"梯度爆炸怎么发现、怎么治"。发现:损失变 NaN、梯度范数异常大;治:梯度裁剪(超过阈值按比例缩回)、换激活、初始化与归一化。追问"为什么不治梯度消失也用裁剪"——裁剪只压大不抬小,消失得靠残差连接与归一化层。
复盘产出:把"局部导数 × 上游梯度"抄成一句口诀贴在案头。下一关把积木组装成卷积与循环结构。