6.2 Q-learning数值迭代关卡
6.2 Q-learning数值迭代关卡
Q-learning 考点:时序差分更新的逐项拆解、探索与利用的平衡、Q-learning 与 SARSA 的路线差异。通关标准:徒手算一轮 Q 值更新,完整跑通网格世界的迭代收敛并读出贪心路径。上一关建好了数学沙盘,本关撤掉地图,让智能体纯靠试错把它解出来。
迭代演武:关卡题目
关卡一(计算):某次更新中 Q(s,a) 当前值为二点零,执行后拿到即时奖励一,转移到新状态 s′,其最大的 Q 值为五点零。取折扣因子零点九、学习率零点一,更新后的 Q(s,a) 是多少?
关卡二(简答):Q-learning 与 SARSA 的更新公式只差一处,差在哪?这个差别导致两者策略性质有何不同?
关卡三(多选):关于 epsilon 贪心,正确的说法包括:
A. 以小概率随机探索,其余概率选当前 Q 值最高的动作
B. 探索率应随训练推进逐渐衰减
C. 探索率恒为一等价于纯贪心
D. 探索率恒为零在表格法下可能卡在次优路线
关卡四(单选):Q-learning 属于哪类算法?
A. 无模型、离线策略(异策略)的时序差分控制 B. 基于模型的动态规划 C. 策略梯度方法 D. 监督学习的一个变体
先攻提示
- 关卡一按更新公式逐项代入:目标是"奖励加折扣后的最大后续值",再朝它挪学习率比例;
- 关卡二盯住目标值那一项:用"所有动作里最大"还是"实际执行的那个";
- 关卡三想探索率取极值时的行为退化成什么;
- 关卡四从"要不要先知道转移规则"与"评估的策略和学习策略是否同一"两条线索判断。
后核:标准解析
关卡一:时序差分误差 = 一 + 零点九乘五点零 − 二点零 = 三点五;更新量 = 零点一乘三点五 = 零点三五;更新后 Q(s,a) = 二点三五。公式逐项点名:目标值"一加四点五"是这一步新信息,旧值二点零是既有认知,学习率决定向新信息挪多少。徒手算熟练这一步,本关后面的整张 Q 表就只是它的批量重复。
关卡二:目标值那一项。Q-learning 取 max——新状态下所有动作 Q 值的最大者,不管实际会走哪个动作,评估的是"贪心策略"的价值,因此叫离线策略(异策略):行为上还在乱探索,学的是最优路线。SARSA 取实际执行到的下一个动作的 Q 值,评估的是"当前这套带探索的行为策略"自身,称为在线策略(同策略)。经典后果出现在悬崖任务:Q-learning 学出的最短路紧贴悬崖(因为它学的是理想贪心路线,探索期摔崖的代价不计入评估对象),SARSA 学到的路线主动绕远避崖(它把探索期摔崖的惩罚真实计入了学到的价值)。两种都对,只是评估对象不同。
关卡三选 A、B、D。 A 是定义;B 是惯例——训练前期多探索防止早熟收敛,后期 exploitation 收网;C 错在探索率为一等价于纯随机,纯贪心对应探索率为零;D 正确,纯贪心在表格里一旦某次路径先入为主,次优动作可能永远得不到翻案机会。C 与 D 恰好构成一对镜像陷阱。
关卡四选 A。 无模型:转移概率未知,靠采样交互估计;异策略:行为策略(epsilon 贪心)与学习目标(贪心最优)分离;时序差分:不等整条回合结束,每步用"即时奖励加折扣后续估计"自举更新。B 需要已知转移模型;C 直接优化策略参数,Q-learning 是值方法;D 更不沾边——没有标签,只有奖励反馈。
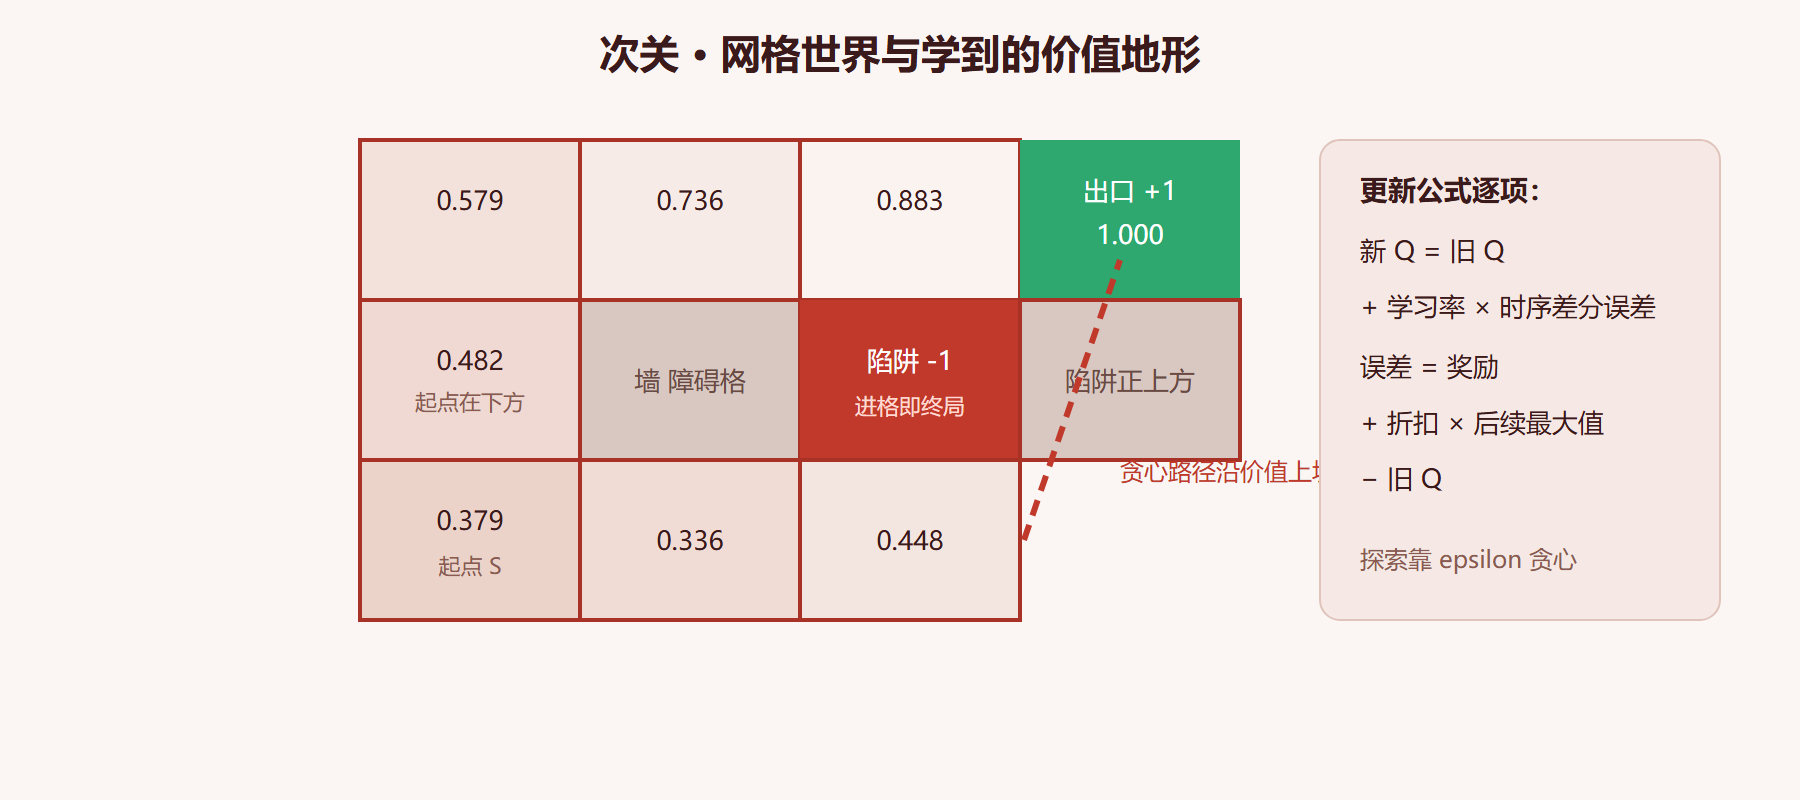
单步会算了,接下来整场演武:在一个四乘三网格世界里从零跑通 Q-learning。背景:起点在左下角,右上角是出口(奖励一),其中一格是陷阱(奖励负一,进格即终局),其余每步零奖励;转移里混入滑倒噪声——三成概率滑向行进方向的侧向。
# 网格世界 Q-learning 全量求解(随机种子固定,结果可复现) import random random.seed(11) ROWS, COLS = 3, 4 START, EXIT, TRAP = (2, 0), (0, 3), (1, 3) ACTIONS = [(-1, 0), (1, 0), (0, -1), (0, 1)] # 上下左右 ACTION_NAME = ["上", "下", "左", "右"] GAMMA, ALPHA, EPS = 0.9, 0.5, 0.2 Q = {(r, c): [0.0] * 4 for r in range(ROWS) for c in range(COLS)} def terminal(s): return s == EXIT or s == TRAP def step(s, a_idx): """滑倒噪声:七成走目标方向,三成滑向相邻方向之一""" if random.random() < 0.3: side = a_idx + random.choice([-1, 1]) a_idx = side % 4 r, c = s[0] + ACTIONS[a_idx][0], s[1] + ACTIONS[a_idx][1] r = min(max(r, 0), ROWS - 1); c = min(max(c, 0), COLS - 1) s2 = (r, c) reward = 0.0 if s2 == EXIT: reward = 1.0 if s2 == TRAP: reward = -1.0 return s2, reward def greedy_action(s, eps): if random.random() < eps: return random.randrange(4) qs = Q[s] return qs.index(max(qs)) for ep in range(1, 500): s = START while not terminal(s): a = greedy_action(s, EPS) s2, r = step(s, a) target = r if terminal(s2) else r + GAMMA * max(Q[s2]) # 离线策略的关键:max Q[s][a] += ALPHA * (target - Q[s][a]) s = s2 print("学到的 Q 表(每格取最大值,负格未探索保持 0):") for r in range(ROWS): print(" ".join(f"{max(Q[(r, c)]):6.3f}" for c in range(COLS))) # 输出(节选,数值随种子固定复现): # 0.579 0.736 0.883 1.000 # 0.482 0.000 0.000 -1.000 # 0.379 0.336 0.448 0.000 # 贪心路线回放 s, path = START, [START] while not terminal(s): a = Q[s].index(max(Q[s])) s, _ = step(s, a) path.append(s) print("贪心路径:", " -> ".join(f"{p}" for p in path)) # 输出: 贪心路径: (2, 0) -> (1, 0) -> (0, 0) -> (0, 1) -> (0, 2) -> (0, 3)
结果解读:Q 表就是一张"价值地形图"——数值从出口(一点零)向起点逐格衰减,陷阱一格直接负值压顶;贪心路径沿"上坡"方向爬到出口,全程绕开陷阱。与首关的贝尔曼迭代对照:机制同源(都是朝目标值挪),差别只在转移规则从"查表已知"变成"采样试错"。变式:把探索率从零点二改成零重跑,观察初期路线被首批偶然滑倒带偏、Q 表收敛到次优——探索的价值一跑便知。
再把 Q-learning 与 SARSA 的差异在同一张沙盘上做单步对照:
# 单步对照:同一转移下,两种目标值的差(数值可笔算复核) Q_next = [0.8, 0.4, 0.1, 0.6] # 新状态上各动作的当前估计 r, GAMMA, actual_next = 0.0, 0.9, 3 # 实际执行到的是动作三 target_qlearning = r + GAMMA * max(Q_next) # 取最大 target_sarsa = r + GAMMA * Q_next[actual_next] # 取实际执行 print(f"Q-learning 目标: {target_qlearning:.2f}") # 输出: Q-learning 目标: 0.72 print(f"SARSA 目标: {target_sarsa:.2f}") # 输出: SARSA 目标: 0.54 print(f"差值: {target_qlearning - target_sarsa:.2f}") # 输出: 差值: 0.18
结果解读:差值零点一八就是"理想最优"与"带探索现实"的落差——Q-learning 给新状态记的是最好的可能,SARSA 记的是最可能的现实。悬崖任务里这个差值日积月累,就把两条算法推上了不同路线。
复盘:易错点与变式
易错点一:把"执行动作的选择"与"目标值的计算"混为一谈。Q-learning 执行时按 epsilon 贪心(要探索),算目标时取 max(学理想);把 max 从目标里删掉,Q-learning 就变成了 SARSA。一个 max 之差,离线与在线分家。
易错点二:学习率拍脑袋取一。学习率为一等于完全相信单次采样,噪声滑倒会把 Q 表搅得持续振荡;表格法常取零点一到零点五并随训练衰减。收敛是"采样噪声平均掉"的过程,步子太大永远平均不掉。
易错点三:奖励尺度随意设。出口加一、陷阱负一尚可;若出口加一百,折扣因子零点九下其他格的价值全部被拉成缓慢的百位数爬坡,数值不稳定且探索期信号被淹没。奖励设计与折扣因子要配平。
变式一:问"为什么说 Q-learning 即使探索策略次优也能收敛到最优"。答:离线策略的性质保证了评估对象是贪心策略而非行为策略;配合"每个状态-动作对都被无限次访问"的技术条件与学习率衰减条件,Q 表收敛于最优值函数——探索只影响效率,不影响收敛目标。
变式二:问"Q 表什么时候装不下"。答:状态数大到表格存不下(棋类)或状态连续(机械臂关节角)时,查表不可行,必须用函数逼近——这正好引出下一关:把 Q 表换成神经网络,代价与解法一并登场。
复盘产出:决策卡"时序差分"一栏补齐:单步更新徒手可算、网格世界整表可跑、两种目标值的分野记牢。下一关进入深水区:网络接管 Q 表之后,训练为什么会不稳、又靠哪三件套稳住。