1.2 现场二:手写LRU缓存
1.2 现场二:手写 LRU 缓存
本节摘要:实现一个容量固定的 LRU(最近最少使用)缓存,get 与 put 都要常数时间。这道题是热身现场唯一的设计题:没有任何单一内置结构能同时满足两个操作的复杂度要求,必须组合哈希表与双链表。本节还原从列表暴力版到 OrderedDict 版再到手写双链表版的完整推演。
上一节的词频统计考"用得熟",这一节考"敢不敢自己造结构"。它在整本教程里的位置很特殊:第 6 章系统设计追问里的"缓存层怎么做",答案的地基就是这道题。
面试官提问
面试官的措辞很短:"设计并实现一个 LRU 缓存类。构造时给容量,get 拿值,put 存值;容量满了再 put,要淘汰最久没被访问的那条。两个操作都要 O(1)。"
候选人复述确认:"get 命中也算一次'使用',对吗?get 未命中返回什么?"面试官答:"命中算使用;未命中返回负一。"这两句确认很值钱——LRU 的"使用"包含读与写,漏掉读的人会在后面悄悄写错淘汰顺序。
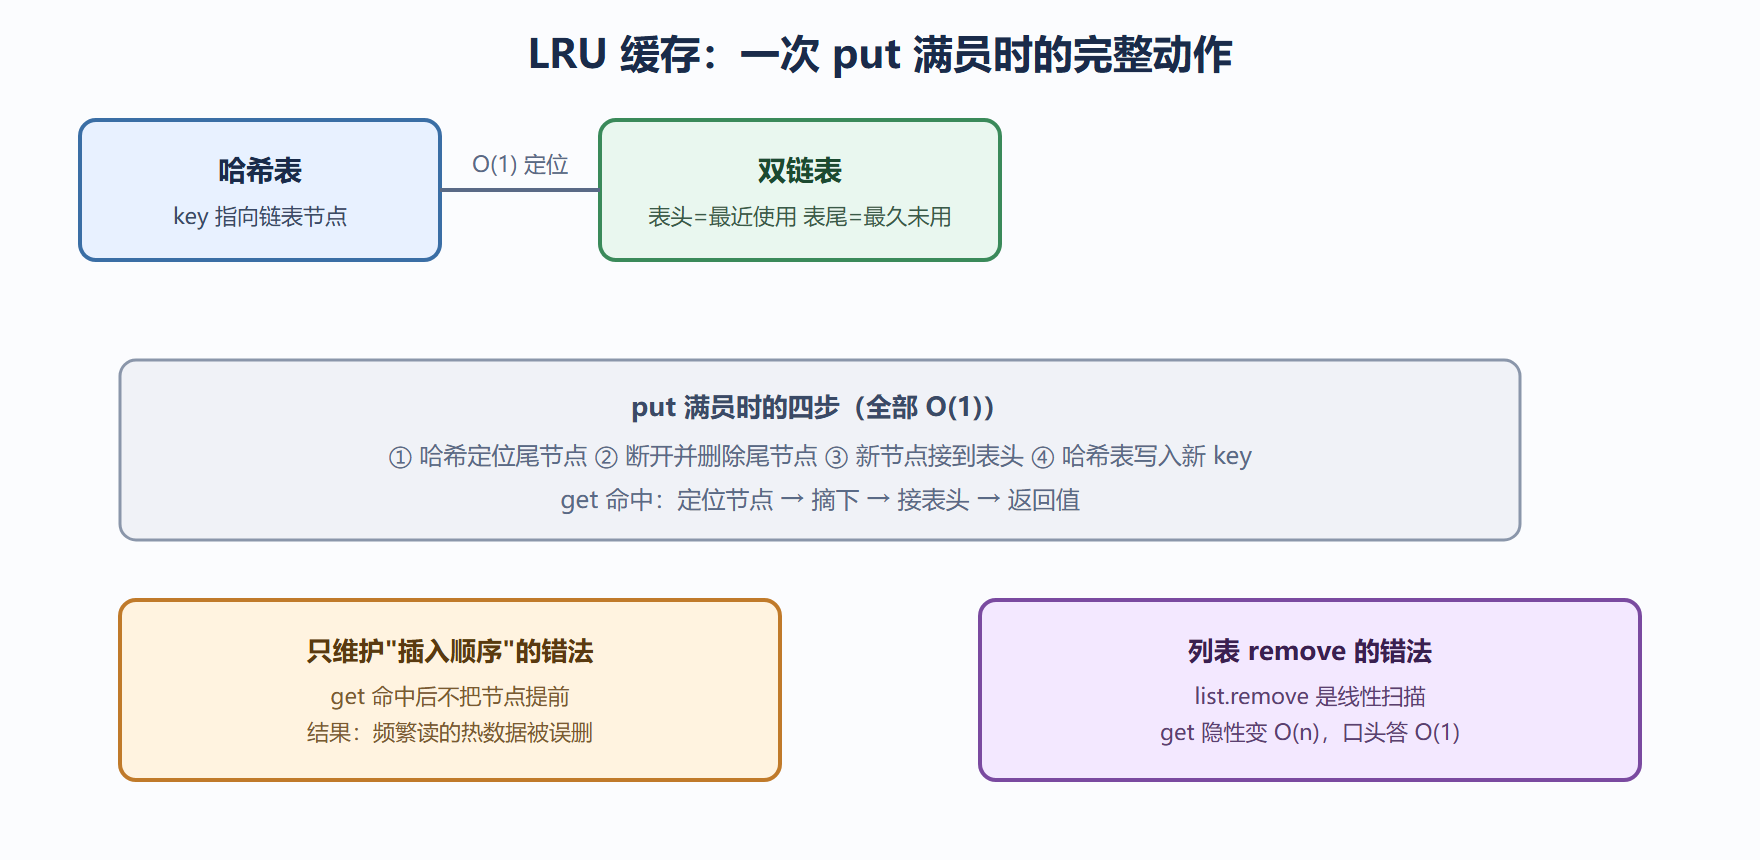
图 1.2-1 LRU 缓存读写路径与淘汰点
现场推演
候选人第一版很诚实:"我先用列表把功能写对,再优化。"暴力版十行写完,面试官看着没说话——这一版的价值是快速锁定语义正确,缺点是列表的 remove 和 index 都是线性扫描。
class LRUCacheBrute: def __init__(self, capacity): self.cap = capacity self.keys = [] # 队首=最久未用 self.vals = {} def get(self, key): if key not in self.vals: return -1 self.keys.remove(key) # 线性扫描:O(n) self.keys.append(key) # 移到队尾=最近使用 return self.vals[key] def put(self, key, value): if key in self.vals: self.keys.remove(key) elif len(self.keys) == self.cap: old = self.keys.pop(0) # 淘汰队首 self.vals.pop(old) self.keys.append(key) self.vals[key] = value c = LRUCacheBrute(2) c.put(1, "a"); c.put(2, "b") print(c.get(1)) # 访问 1,1 变为最近使用 c.put(3, "c") # 容量满,淘汰 2 print(c.get(2), c.get(3))
a -1 c
功能对了。面试官进入追问:"get 的复杂度?"候选人答"remove 是 O(n)"。追问:"怎么压到 O(1)?"——这就是本题的设计核心。
追问链
第一层:OrderedDict。 标准库的 OrderedDict 把键维护成双链表,move_to_end 与 popitem 都是常数时间,等于把底层结构替你写好了。
from collections import OrderedDict class LRUCacheOD: def __init__(self, capacity): self.cap = capacity self.od = OrderedDict() def get(self, key): if key not in self.od: return -1 self.od.move_to_end(key) # 移到右端=最近使用 return self.od[key] def put(self, key, value): if key in self.od: self.od.move_to_end(key) self.od[key] = value if len(self.od) > self.cap: self.od.popitem(last=False) # 弹出左端=最久未用 c2 = LRUCacheOD(2) c2.put("x", 10); c2.put("y", 20) print(c2.get("x")) c2.put("z", 30) print(c2.get("y"), c2.get("z"))
10 -1 30
第二层:不许用 OrderedDict,手写。 这一层筛掉只会调库的人。核心是用 dict 存 key 到节点的映射,节点自带 prev 与 next 指针,配合两个哨兵节点省掉边界判断。下面是现场白板版(面试时写出结构骨架与关键三函数即可,完整可跑版如下)。
class _Node: __slots__ = ("k", "v", "prev", "next") def __init__(self, k=None, v=None): self.k, self.v = k, v self.prev = self.next = None class LRUCache: def __init__(self, capacity): self.cap = capacity self.map = {} self.head, self.tail = _Node(), _Node() # 哨兵 self.head.next, self.tail.prev = self.tail, self.head def _remove(self, node): # 摘下节点:四个指针,O(1) node.prev.next, node.next.prev = node.next, node.prev def _add_front(self, node): # 接到表头(最近使用) node.next, node.prev = self.head.next, self.head self.head.next.prev = node self.head.next = node def get(self, key): if key not in self.map: return -1 node = self.map[key] self._remove(node); self._add_front(node) return node.v def put(self, key, value): if key in self.map: self._remove(self.map[key]) node = _Node(key, value) self.map[key] = node self._add_front(node) if len(self.map) > self.cap: victim = self.tail.prev # 表尾=最久未用 self._remove(victim) del self.map[victim.k] c3 = LRUCache(2) c3.put(1, "a"); c3.put(2, "b") print(c3.get(1)) c3.put(3, "c") # 淘汰 key 2 print(c3.get(2), c3.get(1), c3.get(3))
a -1 a c
注意 _add_front 里四行指针操作的顺序:先把 node 的两个指针接好,再让邻居指向 node。白板上最容易画反的就是这里,面试官通常会盯着指针图让你走一遍。
第三层:并发呢? 候选人答:"最简单是整个缓存套一把锁,读写都串行;如果读多写少,可以换读写锁;再往上是分段锁,把 key 哈希到多个桶,每个桶独立加锁。"面试官追问"分段锁淘汰时容量怎么算",这已经超出热身范围,候选人老实说"全局容量需要跨桶计数,实现会明显变复杂",面试官表示认可——承认边界比硬编强。
失误复盘
高频翻车点:一是不管 get,只按插入顺序淘汰,语义直接错(图 1.2-1 左下角的错法);二是用了列表 remove 还坚称 O(1),被复杂度追问当场戳穿;三是双链表指针接反,现场调试超过五分钟,节奏崩掉。另外有候选人忘了 put 已存在的 key 也算"使用",语义漏了一半。
主线候选人这一场的表现是先暴力后优化、追问到 OrderedDict 才想起 move_to_end,白板手写双链表时指针接错一次但当场发现。面试官评语:"设计感有了,手还不够稳。"
关键直觉:O(1) 的读写意味着"定位靠哈希、调序靠链表"——一种结构干不了的活,就让两种结构各干一半。