第2章 机器学习代码现场
第2章 机器学习代码现场
章节摘要:本章跟着"不许调库"这条线走——面试官把框架全部收走,只留 numpy,看线性回归、KNN、交叉验证与 AUC 这些平时一行 API 搞定的东西,能不能从数组运算层面重新长出来。三个现场分别对应训练、推断、评估三个环节,合起来就是一次完整的建模循环。
一条主线
主线还是那位候选人。进入机器学习专场后,面试官的开场白是:"你简历上写用过 sklearn,那我们把 sklearn 收走,纯 numpy 手写。先从线性回归开始。"这句"收走框架"定了本章基调——不是为了折磨人,而是框架会替你做的三件事(求梯度、做推断、算指标)恰好是理解深度模型的门槛。第 3 章手写反向传播时,本章的梯度下降循环会被原样放大。
"不许调库"现场的评分逻辑和热身现场不同:代码只占一半分,另一半在你能不能边写边说清每一步在数学上对应什么。损失为什么除以样本数、KNN 距离矩阵怎么广播、AUC 与排序的关系,这些话说不出来,代码对了也拿不到强评。
沿途站点
现场四(线性回归) 建立"训练"的现场感:手写前向、均方误差、解析梯度、参数更新四段循环,追问链压向学习率与特征缩放。它是全册所有"训练代码"的模板。
现场五(KNN) 建立"推断"的现场感:一行广播算出全部距离、argsort 取近邻、投票定标签;追问压向高维失效与近似最近邻。它演示的是 numpy 思维——循环写在数组运算里而不是 for 里。
现场六(K 折与 AUC) 建立"评估"的现场感:手写切折逻辑与 ROC 曲线下的面积,追问压向"排序对了 AUC 就是一"。评估写错的人,前面训练得再好也是在用脏尺子量东西。
图 2-1 机器学习现场三环节与共用技能
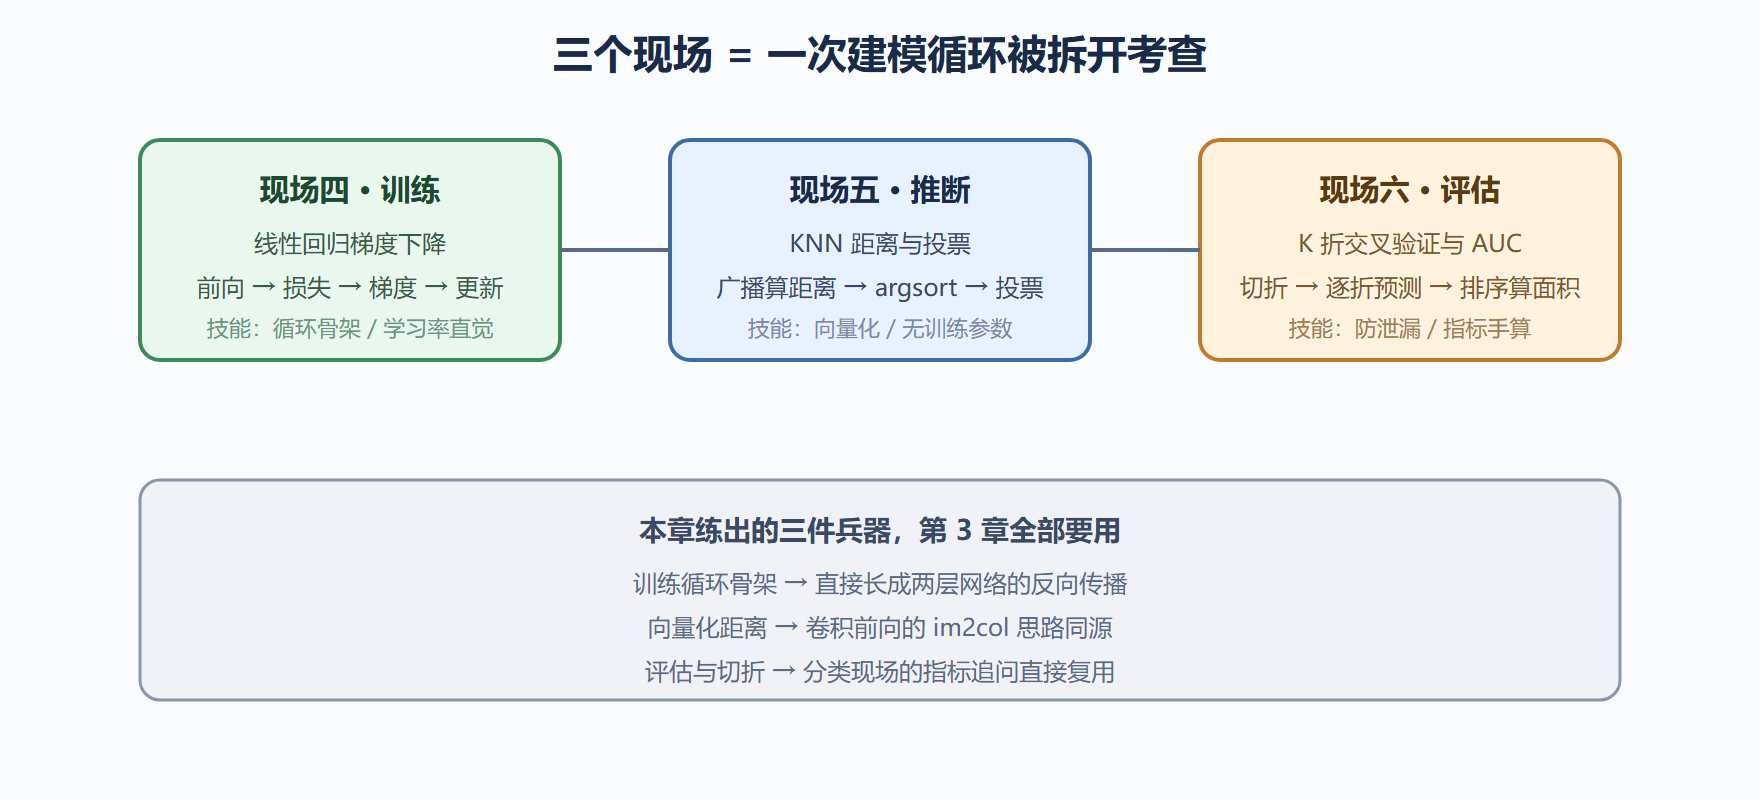
三站的顺序有讲究:先训练再推断最后评估,恰好是建模的真实工作流。面试官经常在第三站埋一个"训练指标漂亮、评估脚本有泄漏"的陷阱,看你能不能发现——读到这里可以带着这个悬念进现场六。
拐点与结论
本章的拐点在 KNN:很多候选人第一次意识到"模型"不一定是训练出来的——KNN 没有参数可学,全部计算推迟到推断时刻。想通这一点,再看"训练循环"就不是唯一范式,后面理解迁移学习的"冻结 backbone 只训头"也会顺。
结论三条:梯度下降四段循环要练到肌肉记忆;能向量化就别写 Python 层面的双重循环;评估脚本的正确性先于一切调参。三条背后是同一种纪律:每一段代码都必须能被复算与验证,算出来的数要能对回手工的账。
读完你应该
- 能默写"前向 → 损失 → 梯度 → 更新"四段循环,并解释梯度里每个矩阵的形状
- 能说明学习率过大与过小分别在损失曲线上呈现什么行为
- 能对比批梯度、随机梯度与小批量的取舍:更新噪声、单步代价与收敛路径
- 能用广播一次算出样本间距离矩阵,并说出 KNN 为何在高维空间失效
- 能手写不泄漏的 K 折切分,并用排序法手算 AUC
- 能指出"训练集上做归一化统计量再用于测试集"这类泄漏的具体位置
下一章的接力
机器学习现场结束时,面试官说了句承上启下的话:"梯度你会手算了,那把它接到两层网络上,中间加个非线性,就是下一题。"第 3 章把本章的四段循环升级成带反向传播的完整网络,并在 softmax 环节首次遇到数值稳定问题——那也是全册挂人最多的一题。