2.3 现场六:手写K折交叉验证与AUC
2.3 现场六:手写 K 折交叉验证与 AUC
本节摘要:手写不打乱顺序版的 K 折切分与基于排序的 AUC 计算,并现场识别一个"先归一化再切折"的数据泄漏陷阱。评估脚本的错误会让前面所有训练白费,这道题考的就是你手里那把尺子准不准。
前两个现场分别练了训练与推断,这是机器学习现场的收束题:评估。它看起来最不像"代码题",实际上最容易在无声无息中写错。
面试官提问
面试官给了三个小任务,连成一串:"写一个函数把下标切成 k 折,轮流拿一折当验证集;然后用排序法算 AUC;最后看一段我带来的评估代码,告诉我哪里有问题。"
第三段是预埋的陷阱,前两问是让你先长出判断力。
现场推演
切折的语义要先说清:K 折意味着每个样本恰好当一次验证集。候选人先写朴素版:
import numpy as np def kfold_indices(n, k): idx = np.arange(n) folds = np.array_split(idx, k) # 顺序切,等份尽量均匀 for i in range(k): val = folds[i] train = np.concatenate([folds[j] for j in range(k) if j != i]) yield train, val for tr, va in kfold_indices(10, 3): print("train", tr, "val", va)
train [3 4 5 6 7 8 9] val [0 1 2] train [0 1 2 6 7 8 9] val [3 4 5] train [0 1 2 3 4 5 8 9] val [6 7 9]
注意第三折验证集是 [6 7 9] 而不是 [6 7 8]——十个下标切三份是四三三,array_split 把多余的分给前面的折。候选人主动指出这个不均匀:"样本数不整除时各折大小差一,这是预期行为不是 bug。"这种对边界行为的敏感,正是评估代码最需要的品质。
接着算 AUC。候选人在白板上先写定义:"AUC 等于随机抽一个正样本和一个负样本,正样本得分更高的概率。"然后给出等价的排序实现:把样本按得分升序排序,AUC 等于正样本的秩和公式除以正负样本对数。
def auc_by_rank(scores, labels): order = np.argsort(scores) # 升序下标 ranks = np.empty_like(order, dtype=float) ranks[order] = np.arange(1, len(scores) + 1) # 秩从 1 开始 pos = labels == 1 n_pos, n_neg = pos.sum(), (~pos).sum() return (ranks[pos].sum() - n_pos * (n_pos + 1) / 2) / (n_pos * n_neg) scores = np.array([0.1, 0.4, 0.35, 0.8, 0.65, 0.9]) labels = np.array([0, 0, 1, 1, 0, 1]) print(round(auc_by_rank(scores, labels), 4))
0.7778
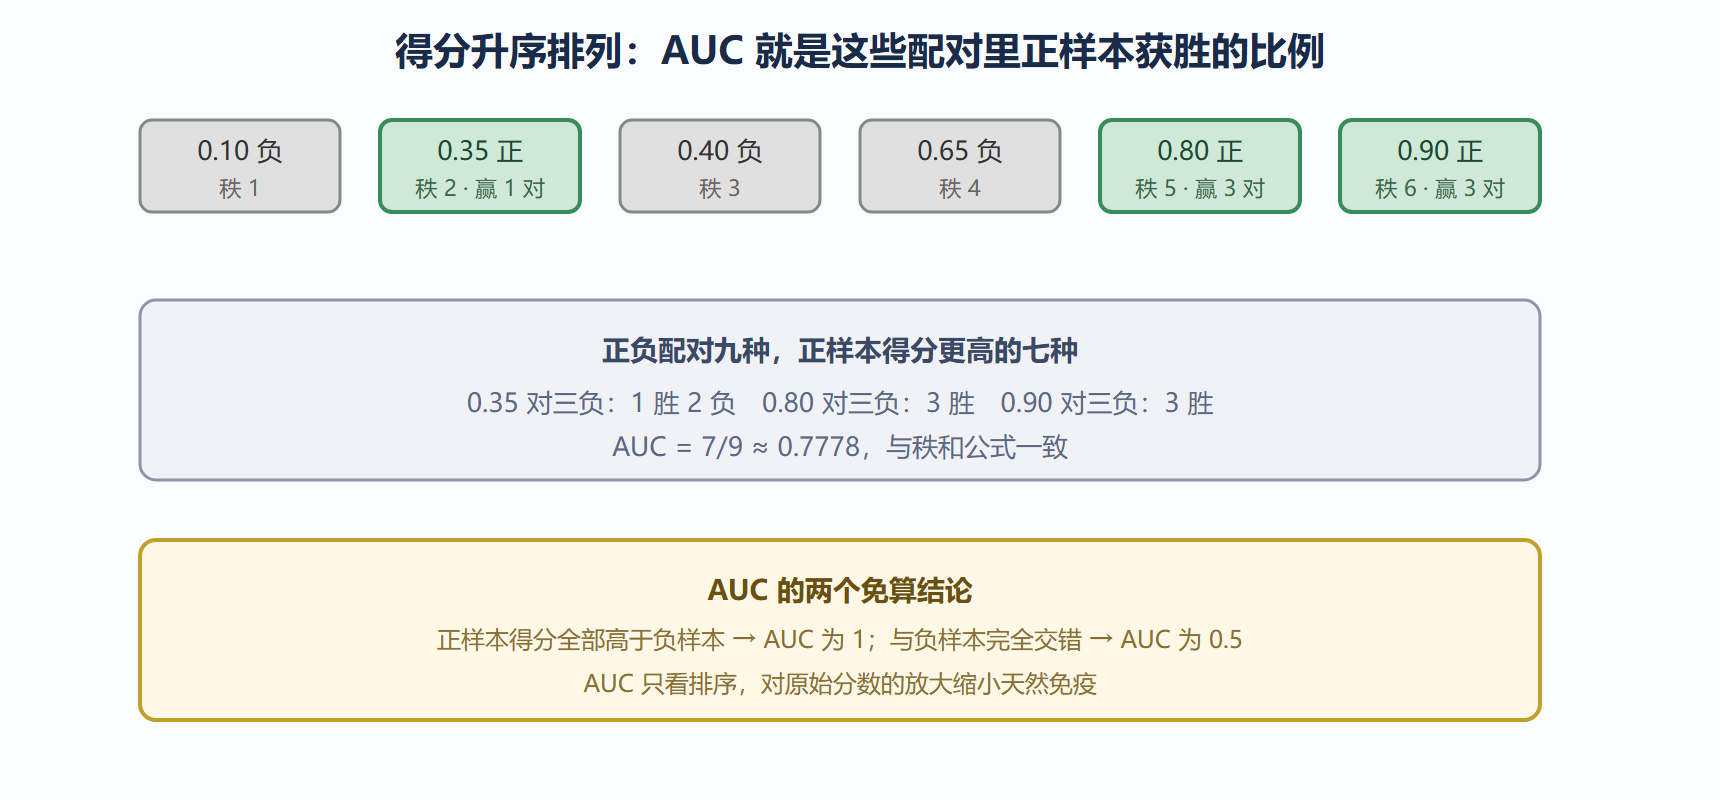
手工核对:正样本三个(得分 0.35、0.8、0.9),负样本三个。逐对清点得分更高的组合:0.35 只赢 0.10 一个负样本(输给 0.40 与 0.65);0.80 赢全部三个负样本;0.90 也赢三个。共七对胜出,七除以九约为 0.7778。
再用秩公式复核一遍:升序为 0.10(负)、0.35(正)、0.40(负)、0.65(负)、0.80(正)、0.90(正),秩依次为 1 到 6。正样本秩和 = 2 + 5 + 6 = 13,代入公式:(13 − 6) 除以 9 = 7 除以 9 ≈ 0.7778。运行代码:
print(round(auc_by_rank(scores, labels), 4)) # 排序法与逐对清点一致
0.7778
图 2.3-1 排序视角下的 AUC:九个正负对的胜负表
追问链
第一问:切折前要不要打乱? 要。真实数据常按类别或时间排序,顺序切折会让某一折几乎全是同一类。正确做法是固定随机种子打乱下标再切,或者分层抽样保证各折类别比例一致。候选人把打乱版也补了实现与自检——折大小是否只差一、并起来是否恰好还原全部下标,两个断言比肉眼可靠:
def kfold_shuffled(n, k, seed=0): rng = np.random.default_rng(seed) idx = rng.permutation(n) return np.array_split(idx, k) folds = kfold_shuffled(10, 3) print('各折大小:', [len(f) for f in folds]) print('并集还原:', sorted(np.concatenate(folds).tolist()) == list(range(10)))
各折大小: [4, 3, 3] 并集还原: True
断言全绿,切折代码才算验收通过——评估代码的测试就该这么小而硬:不追求覆盖一切,只钉住"不能错"的性质。
第二问(预埋陷阱):这段代码哪里错? 面试官贴出的片段是"先对全量数据做归一化,再切折训练"。候选人指出:归一化的均值和方差是用全部数据算的,验证折的信息已经漏进训练过程,这是数据泄漏;正确顺序是切折后仅在训练折上算统计量,再把统计量应用到验证折。他补了句工程版总结:"放进 pipeline、用 fit 只碰训练、transform 碰所有,就是为了在代码结构上杜绝这个错。"
第三问:AUC 高就万事大吉? 不。类别极度不平衡时,一个把全部样本预测为正的模型准确率很高但毫无价值,AUC 对不平衡更稳健但也不反映校准;阈值选择、精确率与召回率的平衡要看业务。评估指标永远是"配着业务选的"。
失误复盘
高频翻车点:秩从零开始数,公式却按从一起算,AUC 系统性偏小;把得分按降序排却仍用升序的秩公式;切折后训练集与验证集有重叠下标(自己 concat 时抄错折号);以及最重要的——泄漏问题看不出来,因为"代码能跑、指标还挺好"。指标好恰恰是泄漏最常见的症状。
主线候选人这场最亮的表现是逐对清点与秩公式互相印证的验证动作,面试官的原话是"我要的就是这个核对动作"。他还留了一条给自己复盘的注脚:AUC 的零点五不是"及格线"而是"瞎猜线"——任何模型先跟零点五比,再跟业务现有的规则比,最后才跟上一版模型比,三步比完的数字才有资格写进报告。
关键直觉:评估代码的 bug 不会报错,只会让数字好看——看到好得反常的指标,第一反应应该是怀疑尺子,而不是庆祝。