3.2 现场八:softmax与交叉熵的数值稳定
3.2 现场八:softmax 与交叉熵的数值稳定
本节摘要:手写 softmax 与交叉熵损失,并处理大分数进指数溢出的问题:减最大值、log-sum-exp、概率与对数概率两条路互证。这道题考"知道浮点数不是实数"的工程直觉,是深度学习现场里区分度最高的一题。
上一节反向传播是"会不会推"的问题,这一节是"知不知道数值会骗你"的问题。模型上线后半夜三点报警的,往往是这一节没学好的人写的代码。
面试官提问
"写 softmax,再写交叉熵损失。然后告诉我,如果输入是九百多这么大的数,你的函数输出什么。"——很多候选人写完函数就交卷,恰恰漏了这半句追问,而这半句才是本题的题眼。
现场推演
候选人先写朴素版,并当场跑面试官给的那组输入:
import numpy as np def softmax_naive(z): ez = np.exp(z) return ez / ez.sum() z0 = np.array([1.0, 2.0, 3.0]) print(softmax_naive(z0).round(4)) print(softmax_naive(np.array([500.0, 501.0, 502.0]))) # 大分数试探
[0.0900 0.2447 0.6652]
第二条打印的输出是一条 RuntimeWarning 加 [nan nan nan]——e 的 500 次方约是 10 的 217 次方,远超双精度上限 10 的 308 次方?不,还没超上限但三项全部溢出成 inf,inf 除以 inf 得 nan。面试官看着 nan 问:"怎么办?"
图 3.2-1 减最大值前后:指数项的量级对比
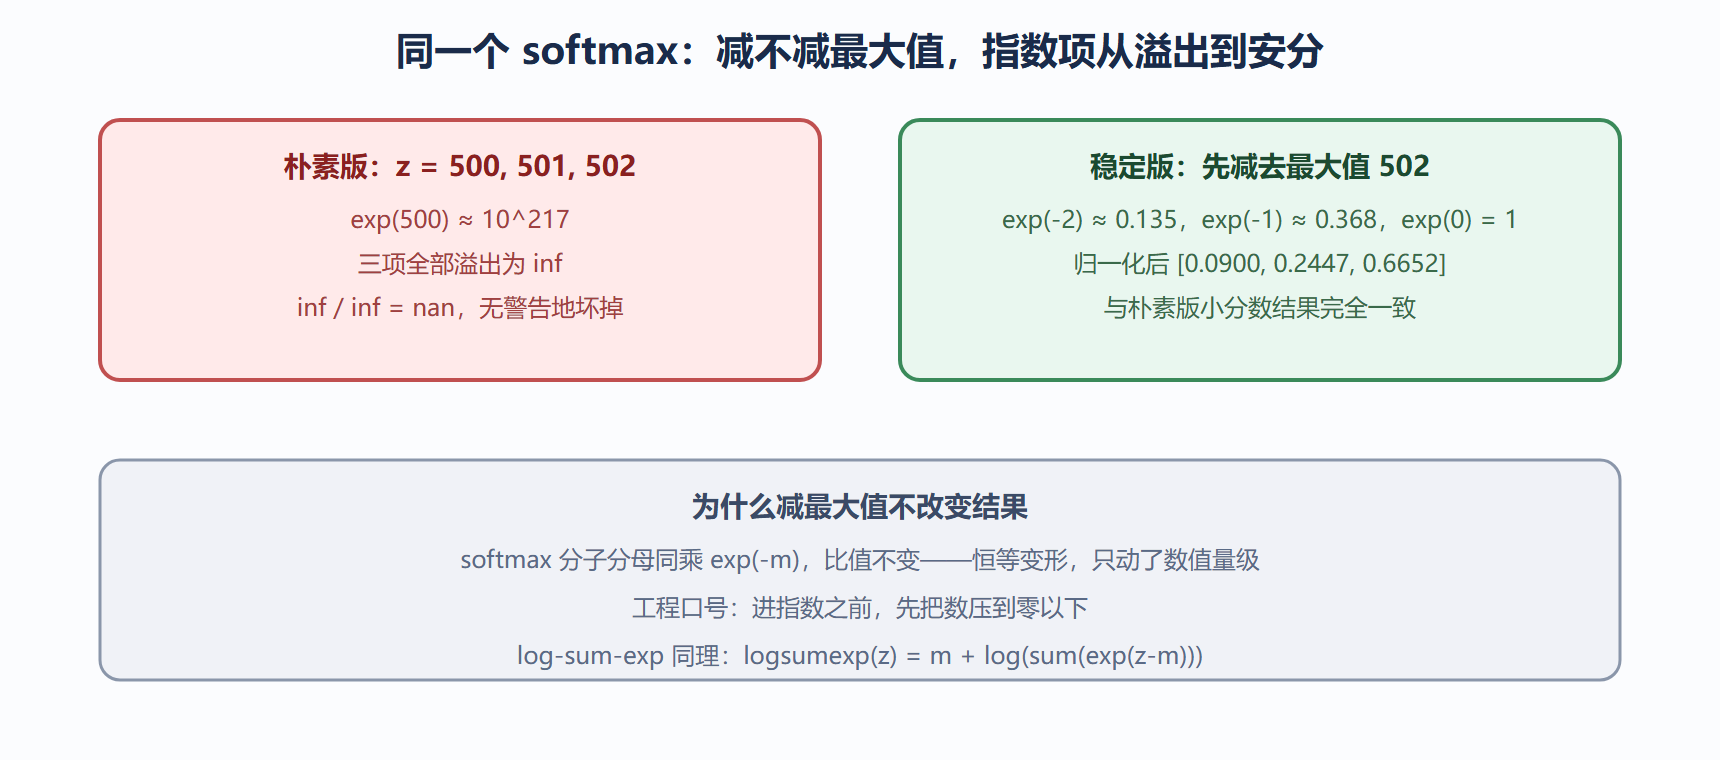
候选人写稳定版并验证恒等:
def softmax_stable(z): z = z - z.max(axis=-1, keepdims=True) # 减最大值:最大指数项变 exp(0)=1 ez = np.exp(z) return ez / ez.sum(axis=-1, keepdims=True) big = np.array([500.0, 501.0, 502.0]) print(softmax_stable(big).round(4)) print(np.allclose(softmax_stable(z0), softmax_naive(z0))) # 小分数下两版一致
[0.0900 0.2447 0.6652] True
大分数版输出与小分数那组完全一致——因为 500、501、502 与 1、2、3 只差一个常数偏移,而 softmax 对加常数免疫。这个"输出不变"本身就是减最大值正确性的证明。
追问链
第一问:交叉熵里再取 log,nan 又来了。 概率为零时 log 零是负无穷。两条出路:损失函数直接用"对数概率"通道(log-sum-exp),或者概率加一个极小值再取对数。候选人写了干净的前者:
def cross_entropy_stable(logits, target): m = logits.max() log_probs = logits - m - np.log(np.exp(logits - m).sum()) # log-softmax,全在对数域 return -log_probs[target] logits = np.array([2.0, 1.0, 0.1, -0.5, 3.0]) print(round(cross_entropy_stable(logits, 0), 4)) print(round(cross_entropy_stable(np.array([950.0, 940.0, 930.0, 920.0, 910.0]), 4), 4))
1.5697 1.2030
两个数字可复算:第一组里正确类得分 2.0 不是最高(3.0 才是),损失自然大于 1;第二组虽然分数近千,减去最大值后完全正常,且正确类(下标 4,得分最低)损失更大——行为符合直觉。全程没有一个概率显式出现,nan 无从谈起。
候选人顺手把 log-softmax 单独拎出来验性质:同值输入输出均匀的对数概率,指数化后精确还原为概率,对数概率之和则是自由能般的负数——这三个性质在数值验证里一目了然:
def log_softmax(z): m = z.max() return z - m - np.log(np.exp(z - m).sum()) print(log_softmax(np.array([1000.0, 1000.0, 1000.0])).round(3)) print(np.exp(log_softmax(np.array([2.0, 1.0, 0.1]))).round(3)) print('对数概率求和:', round(float(log_softmax(np.array([2.0, 1.0, 0.1])).sum()), 3))
[-1.099 -1.099 -1.099] [0.659 0.242 0.099] 对数概率求和: -4.151
近千的输入不再报 nan;三个概率加起来恰好为一;对数概率求和得负的四点一五一——它等于负 log-sum-exp,softmax 家族的所有数值故事都写在这一个数里。
第二问:softmax 配交叉熵的梯度是什么? 这是本题的压轴。候选人现场推:损失对 logits 的梯度恰好是"softmax 概率减 one-hot 标签",两行指数相消,只剩减法。他先写结论再验证:
probs = softmax_stable(logits) grad = probs.copy(); grad[0] -= 1 # 对正确类那一维减一 print(grad.round(4))
[ 0.0876 -0.1804 -0.0756 -0.0410 -0.6806]
正确类那一维是正的小残差(还没学够),其余类是负的回拉量,四个负数加一个正数的和为零——梯度和恒为零,softmax 的性质在数字里看得见。他补了工程句:"所以框架把两者合并成一个算子,数值稳、梯度也一步到位,分开写两个都容易出事。"
第三问:训练中还有哪些 nan 的来源? 候选人列了三个:学习率过大梯度爆炸、除以零(批归一化在批大小为一时)、损失里 log 零。排查顺序:先定位第一步变 nan 的张量,再看它上游是哪个算子——"从爆点逆流而上"与反向传播是同一个走法。
失误复盘
高频翻车点:写了稳定 softmax 却在损失里对概率取 log,前功尽弃;eps 加在错误的位置(加在指数前而不是概率上),公式悄悄变形;被问"输入全是一千输出什么"时回答"全零",忘了同值向量 softmax 输出均匀分布;梯度公式背成"标签减预测",符号反了梯度上升越训越差。
主线候选人这场答得最完整,nan 演示、恒等证明、梯度验证一气呵成。他的复盘笔记只有一句:"数值问题要用跑出来的 nan 说话,谁看着都不信的事,跑一遍就都信了。"
关键直觉:指数函数是数值放大器——任何要进指数的数,先问自己"它最大能到多少",再决定要不要先减个最大值。