第4章 CV代码现场
第4章 CV 代码现场
章节摘要:本章跟着一个 CV 项目的三段式流水线走——数据(预处理与增强)、模型(残差块)、后处理(IoU 与 NMS)。三个现场对应项目里最容易掉分的三段,追问的重心从第 3 章的"公式"切换到"张量形状与边界情况":批次、通道两个新维度加入后,形状追问的难度翻倍。
一条主线
主线候选人进入了 CV 专场。面试官是视觉组的工程师,开场就说:"视觉题不考你背网络,考你脑子里有没有一根形状的弦。"现场十考数据增强——候选人写随机水平翻转时忘了标签框要同步镜像,被一句"翻转后框还在原图位置吗"点醒;现场十一考残差块——形状追问一路从四维卷积问到全局平均池化;现场十二考 IoU 与 NMS——这是他全场唯一一次零失误,因为几何题可以画图自检。
CV 现场的题目有个共同点:都能画出来。数据增强画像素网格,残差画数据流,NMS 画框的覆盖关系。能不能主动"以图辅码",是视觉组面试官眼里区分度极高的习惯。
沿途站点
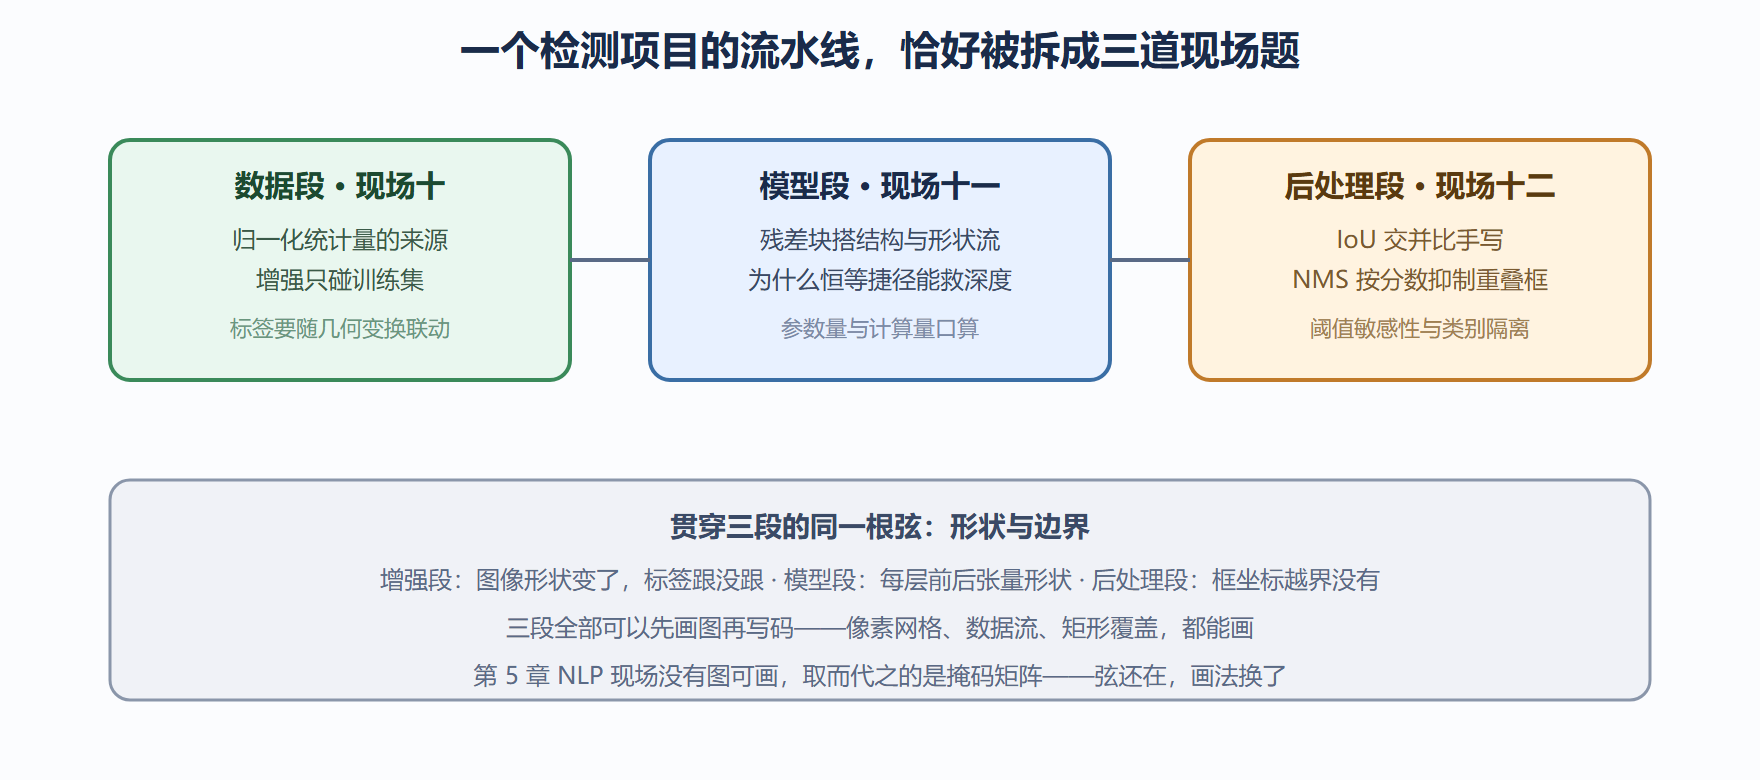
现场十(预处理与增强) 走数据段:归一化的统计量从哪来、增强为什么只作用在训练集、翻转与裁剪对标签的连带影响。它承接第 2 章现场六的泄漏话题,从表格数据搬到了图像。
现场十一(残差块) 走模型段:用框架 API 搭一个残差块并解释每个张量的形状变化、为什么残差能缓解退化、参数量怎么口算。它承接第 3 章卷积现场,把"一个卷积"放大成"一个可训练的结构单元"。
现场十二(IoU 与 NMS) 走后处理段:手写交并比、再写非极大值抑制,追问压向阈值敏感性、软抑制变体与类别处理。检测题的后处理是纯几何加排序,最像传统算法题,也最适合白板推演。
图 4-1 CV 项目三段式流水线与三个现场的位置
拐点与结论
本章的拐点在现场十的后半段:候选人意识到"数据增强不是一个函数调用,而是一个要保持图像与标签一致的变换系统"。想通这一点,他当场把翻转函数改成了双参数版本。这种"改代码改在追问之前"的动作,是三轮面试里最被认可的表现。
结论三条:视觉代码先画图,形状与边界逐个确认;增强管道里图像与标签必须同变;后处理几何题用特殊位置(相离、包含、共边)自测,比随机数据可靠。值得一提的是,现场十二的零失误并非天赋——几何题的图、排序题的表、特殊位置的测试用例,全是可以带走迁移的自检动作。
读完你应该
- 能写带标签联动的水平翻转与裁剪增强,并解释统计量泄漏在图像场景的形态
- 能徒手搭残差块,报出每个张量的形状,并解释捷径分支为何要一乘一卷积
- 能口算残差块的参数量,说明残差结构与梯度流动的关系
- 能手写 IoU(含相离与包含两种边界)与按类别的 NMS
- 能解释零填充让输出尺寸不变的公式来源,以及残差捷径分支一乘一卷积的触发条件
- 能讨论 NMS 阈值过高过低分别带来什么失效模式,以及软抑制的动机
下一章的接力
CV 现场结束时面试官说:"视觉的形状是四维的,文本的形状是三维的,但真正麻烦的不是形状,是变长。"第 5 章 NLP 现场的三个现场——分词与词向量、手写注意力、文本分类全流程——会围绕"变长序列怎么批处理"展开,掩码将从配角变成主角。