6.1 现场十六:动态规划解编辑距离
6.1 现场十六:动态规划解编辑距离
本节摘要:终面的第一题:动态规划求两个字符串的编辑距离,从状态定义讲到滚动数组,再到操作序列恢复。这道题是字符串题的母题,也是"会写"与"会讲"的分水岭——代码二十行,状态定义讲不清楚的人却占了大半。
编辑距离的出身很朴素:衡量字符串之间有多像。拼写纠错、搜索联想、查询改写、DNA 序列比对,背后都是它。终面把它放在首位,看中的恰是它的"好讲"——每一步都能追问为什么,从状态定义一路追到空间复杂度,谁在背表、谁在想,一问便知。
考题现场
"写一个函数算两个单词的编辑距离:插入、删除、替换各算一步。写完回答:动态规划表每个格子的含义是什么?怎么把空间压到一维?能不能把具体的编辑操作序列恢复出来?"
题目不带任何提示,是因为终面要的就是你自己的叙述结构:先说什么后说什么,暴露的是思维是否成体系。
现场推演
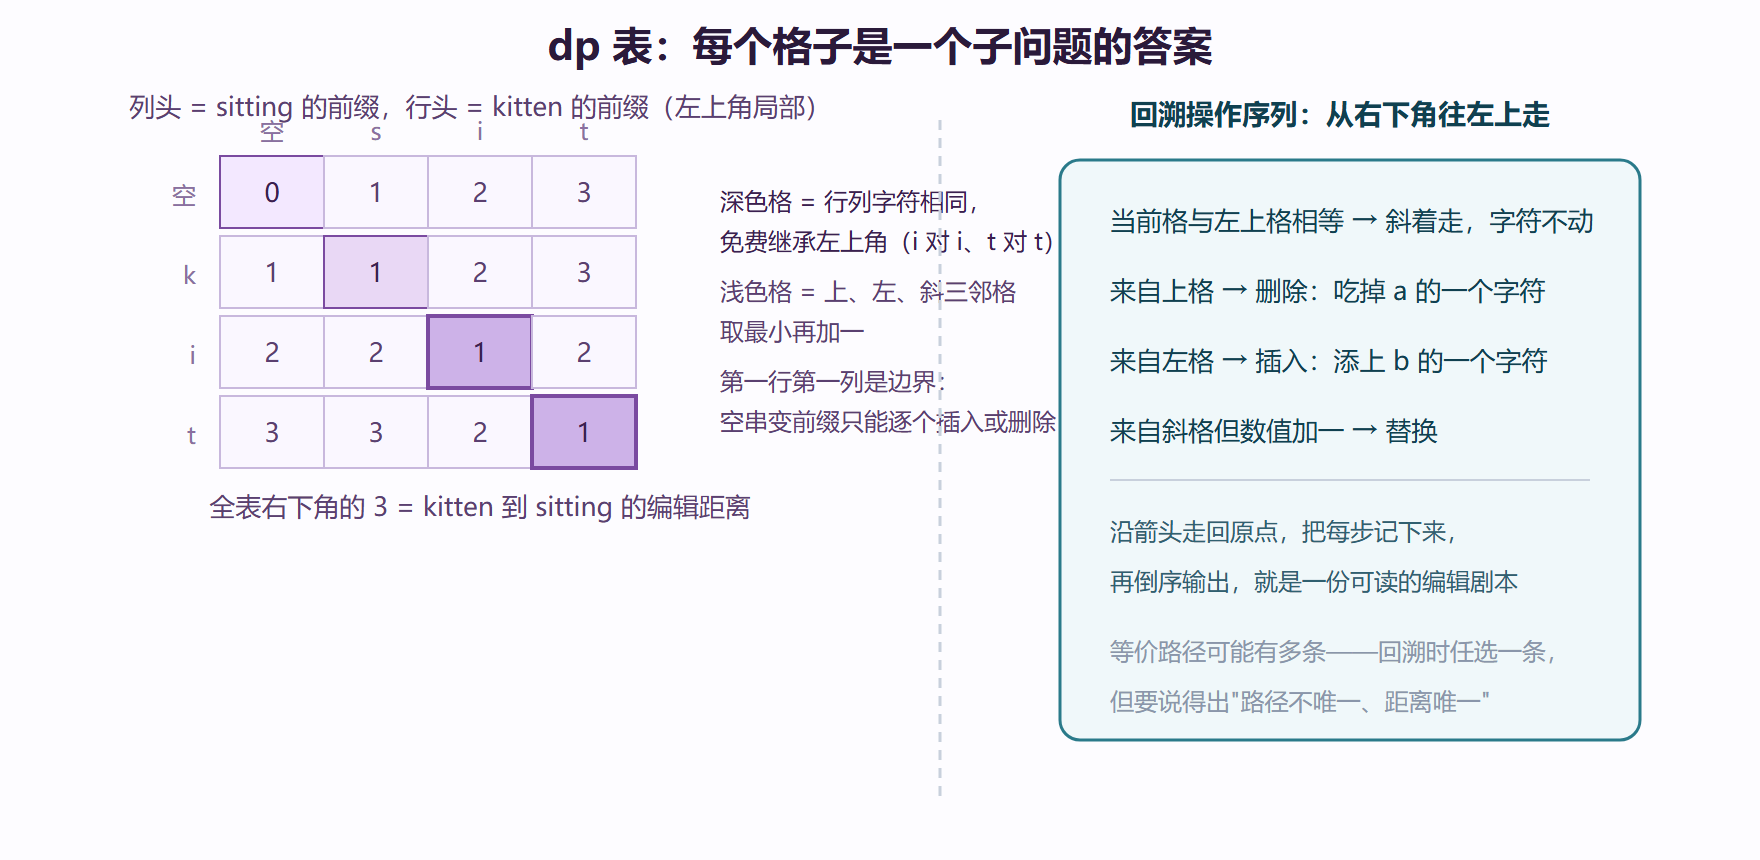
候选人先给状态下定义,再写代码——他说这是从第 4 章画数据流学来的顺序,只是这次画的是表格:dp[i][j] 表示"第一个单词的前 i 个字符变成第二个单词的前 j 个字符所需的最少操作数"。边界随之自然浮现:空串变成任何前缀,只能逐个插入;任何前缀变成空串,只能逐个删除。转移分最后一对字符相同与否:相同则继承左上角,不同则在删除、插入、替换三种走法里取最小再加一。
import numpy as np def edit_table(a, b): m, n = len(a), len(b) dp = np.zeros((m + 1, n + 1), dtype=int) dp[:, 0] = np.arange(m + 1) # 第一列:删光 a 的前缀 dp[0, :] = np.arange(n + 1) # 第一行:插入 b 的前缀 for i in range(1, m + 1): for j in range(1, n + 1): if a[i - 1] == b[j - 1]: dp[i, j] = dp[i - 1, j - 1] # 末字符相同,免费继承 else: dp[i, j] = 1 + min(dp[i - 1, j], # 删 a 的末字符 dp[i, j - 1], # 插 b 的末字符 dp[i - 1, j - 1]) # 替换 return dp D = edit_table('kitten', 'sitting') print('kitten 到 sitting 的距离:', D[-1, -1]) print('flaw 到 lawn:', edit_table('flaw', 'lawn')[-1, -1]) print('ab 到 ba:', edit_table('ab', 'ba')[-1, -1])
kitten 到 sitting 的距离: 3 flaw 到 lawn: 2 ab 到 ba: 2
数字逐个核对:kitten 到 sitting 是替换两次加插入一次;flaw 到 lawn 是删掉打错的首字母、再补一个正确的尾字母;ab 到 ba 是替换两次——候选人特意停下来指出,"交换相邻字符"在这个代价体系里不是一条合法操作,所以是二不是一;要让它变一,得改用带邻接交换的扩展定义(Damerau 距离)。终面喜欢这种主动厘清定义边界的回答:算法的能力范围是定义给的。
图 6-2 编辑距离的填表与回溯:从右下角走回原点
空间优化是必追的下一层。填表过程里,每一行只依赖上一行,整张表没必要全存——滚动数组把二维压成两行,再进一步可以压成一行加一个临时变量:
def edit_rolling(a, b): prev = list(range(len(b) + 1)) # 第 0 行 for i in range(1, len(a) + 1): cur = [i] + [0] * len(b) for j in range(1, len(b) + 1): if a[i - 1] == b[j - 1]: cur[j] = prev[j - 1] else: cur[j] = 1 + min(prev[j], cur[j - 1], prev[j - 1]) prev = cur return prev[-1] print('滚动数组结果:', edit_rolling('kitten', 'sitting')) print('时间 O(mn),空间 O(n):', 'm、n 为两串长度')
滚动数组结果: 3 时间 O(mn),空间 O(n):
结果与全表版一致,空间从两串长度的乘积降到其中较短的一串。候选人补了一句工程注解:"只求距离时用滚动数组;要恢复操作序列就得保留全表——空间换可解释性,这是个明确的选择,不是忘了优化。"
追问链
追问一:怎么恢复操作序列? "从右下角往左上回溯:当前格若与左上角相等且字符相同,斜着走、字符不动;若等于上格加一,走上方,记一次删除;等于左格加一,走左方,记一次插入;都不是则是替换,斜着走记一次。回到原点后把记录倒序输出。注意回溯路径可能有多条,但每条的步数都等于距离——路径不唯一、距离唯一,这句话能防住面试官的下一个陷阱。"
追问二:编辑距离和最长公共子序列什么关系? "只允许插入和删除时,编辑距离等于两串长度之和减去公共子序列长度的两倍;允许替换之后不能直接换算,但两个算法是同一张状态设计思想的两张皮——都是'前缀对前缀'的二维表。面试里答出'同一思想'比背换算公式更重要,因为换算公式在带替换时是错的。"
追问三:两串都很长怎么办? "按需分层回答:拼写纠错场景先按长度差和首字剪枝筛候选词,只对候选算距离;有带宽约束时用带状动态规划,只填主对角线附近的带子,复杂度从乘积降到长度乘带宽;再往上就是索引式的近似检索,把'算距离'变成'查候选'。一句话总结:先筛后算,别对全词典暴力填表。"
优化与变式
带权变式最常见:键盘上相邻键的误触概率高,把替换代价从常数换成查表函数,距离就变成了"期望代价",纠错排序立刻更聪明。递归版是面试官爱挖的坑:不带记忆化的递归编辑距离是指数复杂度——同一个子问题被反复重算;加上一张记忆表立刻回到动态规划的复杂度,这一正一反的对比恰好演示了动态规划存在的理由:重叠子问题。还有一条通往 NLP 的变式:把字符换成词,编辑距离就变成句子级的对齐代价,机器翻译早期的对齐评测靠它吃饭——这与下一场搜索类题目的状态设计一脉相承。
失误复盘
高频翻车点:边界初始化漏掉,第一行第一列乱掉全表皆错;字符相同分支写成取最小加一,白白多算一步;恢复操作序列时从左上角往右下走,方向反了;滚动数组只留一行,cur 与 prev 混用,答案时对时错;被追问复杂度时报 O(n²) 却说不清 n 是什么——m 与 n 是两个独立长度,平方的说法在面试官耳朵里是概念不清。终面特有的失误是表达顺序:先写代码后补状态定义,讲到一半发现定义有歧义再返工,节奏全毁。防御动作只有一条:状态定义先出口,代码跟在定义后面。
主线候选人这一场的处理被面试官评为"教科书式":定义、边界、转移、代码、优化、恢复,六步顺序没有任何颠倒。他的复盘笔记只有一句:"把'先讲清楚再写'当成肌肉记忆后,终面的叙述压力反而变成了节奏优势。"
关键直觉:动态规划的难度全部前置在状态定义里——定义说得清,转移是抄;定义说不清,代码是赌。