2.6 健康检查与服务依赖
2.6 健康检查与服务依赖
本节摘要:depends_on 控制服务启动顺序,healthcheck 探测服务是否真正就绪,两者组合才能保证"依赖可用之后才启动依赖方"。本节先拆穿 depends_on 只保证顺序不保证就绪的真相,再逐个解释 test、interval、timeout、retries、start_period 五个参数,随后给出 condition 条件依赖的写法与 pg_isready、redis-cli 等常见镜像的就绪命令,最后说明健康状态如何查看与流转。
读前必看
- 能解释 depends_on 的能力边界,说明它为什么管不了"就绪"。
- 能写出 healthcheck 的完整配置并解释五个参数的默认值与含义。
- 能用长语法 condition: service_healthy 实现条件依赖。
- 能为 PostgreSQL、Redis、Web 服务选择正确的健康检查命令。
- 能通过 docker inspect 与 docker ps 查看容器的健康状态并定位问题。
一、depends_on 的真相:只保证顺序,不保证就绪
2.2 节埋了个伏笔:depends_on: - db 只保证 db 容器先启动,不保证 PostgreSQL 能接连接。为什么?数据库容器启动后还要做初始化:读配置、建数据目录、恢复 WAL,快的几秒,慢的几十秒。这期间容器是 running,但端口还没开始监听。web 在这个窗口去连,报的错和数据库没启动时一模一样。
depends_on 的语义严格来说是"启动依赖":依赖方先创建、先启动;被依赖方等它启动完再启动。它不检查任何健康状态——db 启动失败了,web 照样会被拉起来,然后连环报错。还有一个副作用要记住:停止服务时顺序是反的,Compose 会按依赖关系倒序停止,先停 web 再停 db,这个行为是合理的。
依赖场景不止数据库:消息队列 RabbitMQ、Kafka 是微服务通信的桥梁,缓存 Redis、Memcached 支撑热点请求,它们都有"容器起了但服务没就绪"的窗口。所以结论先行:顺序靠 depends_on,就绪靠 healthcheck,两个都要写。
健康检查还有一个被忽视的用途:它让"就绪"这件事可观测。没有 healthcheck 时,服务起来没起来只能看进程状态;有了它,docker ps 一列状态,谁没就绪一眼可见,监控系统也能直接消费这些状态。
二、healthcheck 参数逐个拆
healthcheck 让 Docker 周期性执行一条探测命令,用命令的退出码判断健康:返回 0 算健康,非 0 算不健康。
version: "3.9" services: web: image: web-app:latest healthcheck: test: ["CMD", "curl", "-f", "http://localhost:5000/health"] interval: 30s timeout: 10s retries: 3 start_period: 5s
五个参数的含义与默认值:
| 参数 | 作用 | 默认值 |
|---|---|---|
| test | 探测命令,CMD 或 CMD-SHELL | 无,必须写 |
| interval | 两次检查的间隔 | 30s |
| timeout | 单次检查的超时 | 30s |
| retries | 连续失败多少次判不健康 | 3 |
| start_period | 启动宽限期,期间失败不计入重试 | 0s |
test 两种写法区别在解析方式:CMD 直接把命令按数组执行,不经过 shell;CMD-SHELL 交给 shell 执行,可以用管道、变量、重定向。判断一个服务"活着"还是"能干活",命令要选对。Web 服务探测 HTTP 端点,数据库探测连接,缓存探测 ping,各自见第四节。
interval 与 timeout 决定检查频率与单次上限:检查越频繁,故障发现越快,但容器与宿主机开销也越大。数据库这种秒级恢复的用 30s 间隔足够;start_period 专门给慢启动服务:启动期内失败不计入 retries,避免"初始化还没完就被判死刑"。参数值都是"数字加时间单位"的写法,30s、5m、1h 都合法;数字后面不加单位会按秒解析,写 30 和写 30s 效果相同,但显式写单位可读性更好。
三、条件依赖:长语法的正确用法
把 healthcheck 和 depends_on 接起来,就是长语法:
version: "3.9" services: web: image: web-app:latest depends_on: database: condition: service_healthy ports: - "8080:8080" healthcheck: test: ["CMD", "curl", "-f", "http://localhost:8080/health"] interval: 30s timeout: 10s retries: 3 start_period: 5s database: image: postgres:13 environment: POSTGRES_USER: example POSTGRES_PASSWORD: example POSTGRES_DB: example healthcheck: test: ["CMD-SHELL", "pg_isready -U example -d example"] interval: 30s timeout: 5s retries: 5
condition: service_healthy 的意思是:database 的健康状态变为 healthy 之前,web 不被启动。database 的探测命令 pg_isready -U example -d example 不仅检查服务能连,还顺带确认指定的数据库存在——这是比裸的 pg_isready 更严格的就绪判断。启动时序从"两个容器同时初始化"变成"数据库确认可用,web 才登场",连接失败的问题基本绝迹。多个依赖可以同时挂条件,web 等 db 和 redis 都健康才启动,Compose 会并发等待所有条件满足。
四、常见镜像的就绪命令
探测命令要打在"服务的功能"上,而不是"进程活着"。各家镜像官方或社区已经给出标准答案:
| 服务 | 探测命令 | 说明 |
|---|---|---|
| PostgreSQL | pg_isready -U 用户名 -d 库名 | 镜像自带,检查连接与库 |
| Redis | redis-cli ping | 返回 PONG 即健康 |
| Nginx | wget -q --spider 「相关地址请参见官方文档」 | 只请求不下载 |
| 通用 Web | curl -f 「相关地址请参见官方文档」 | 看 HTTP 状态码 |
| MySQL | mysqladmin ping | 镜像自带工具 |
用 CMD-SHELL 时记得考虑工具是否存在:curl 不一定装了,wget 也不一定。alpine 系镜像常用 wget,debian 系常用 curl,写探测命令前先进容器确认。检查频率按服务特性定:数据库初始化慢,start_period 给足 10 到 30 秒;缓存服务启动快,30 秒间隔加 3 次重试就够。检查命令还有一个隐蔽的失败模式:命令本身不存在时检查直接失败,精简镜像里很常见。先手工执行确认,再写进配置,能省掉一半的排查时间。
五、健康状态怎么流转
容器健康状态有三种:starting 表示还在启动宽限期;healthy 表示最近一次检查通过;unhealthy 表示连续 retries 次失败。查看状态两种方式:docker ps 的 STATUS 列会显示 healthy 或 unhealthy;docker inspect <container_id> 里 health 字段能看到检查历史与失败原因,排查时先看这里。脚本化排查时,docker ps --format 可以只输出名称与状态两列,筛 unhealthy 实例一行命令的事。inspect 的 health 输出里 Log 数组记录了每次检查的退出码与输出,配合时间戳可以还原故障时间线:是启动期失败还是运行期失败、失败前最后一次成功是什么时候,写告警时这些信息很有用。
服务依赖与健康检查状态流转图
从创建到就绪,再到异常重试与恢复,状态流转如下:
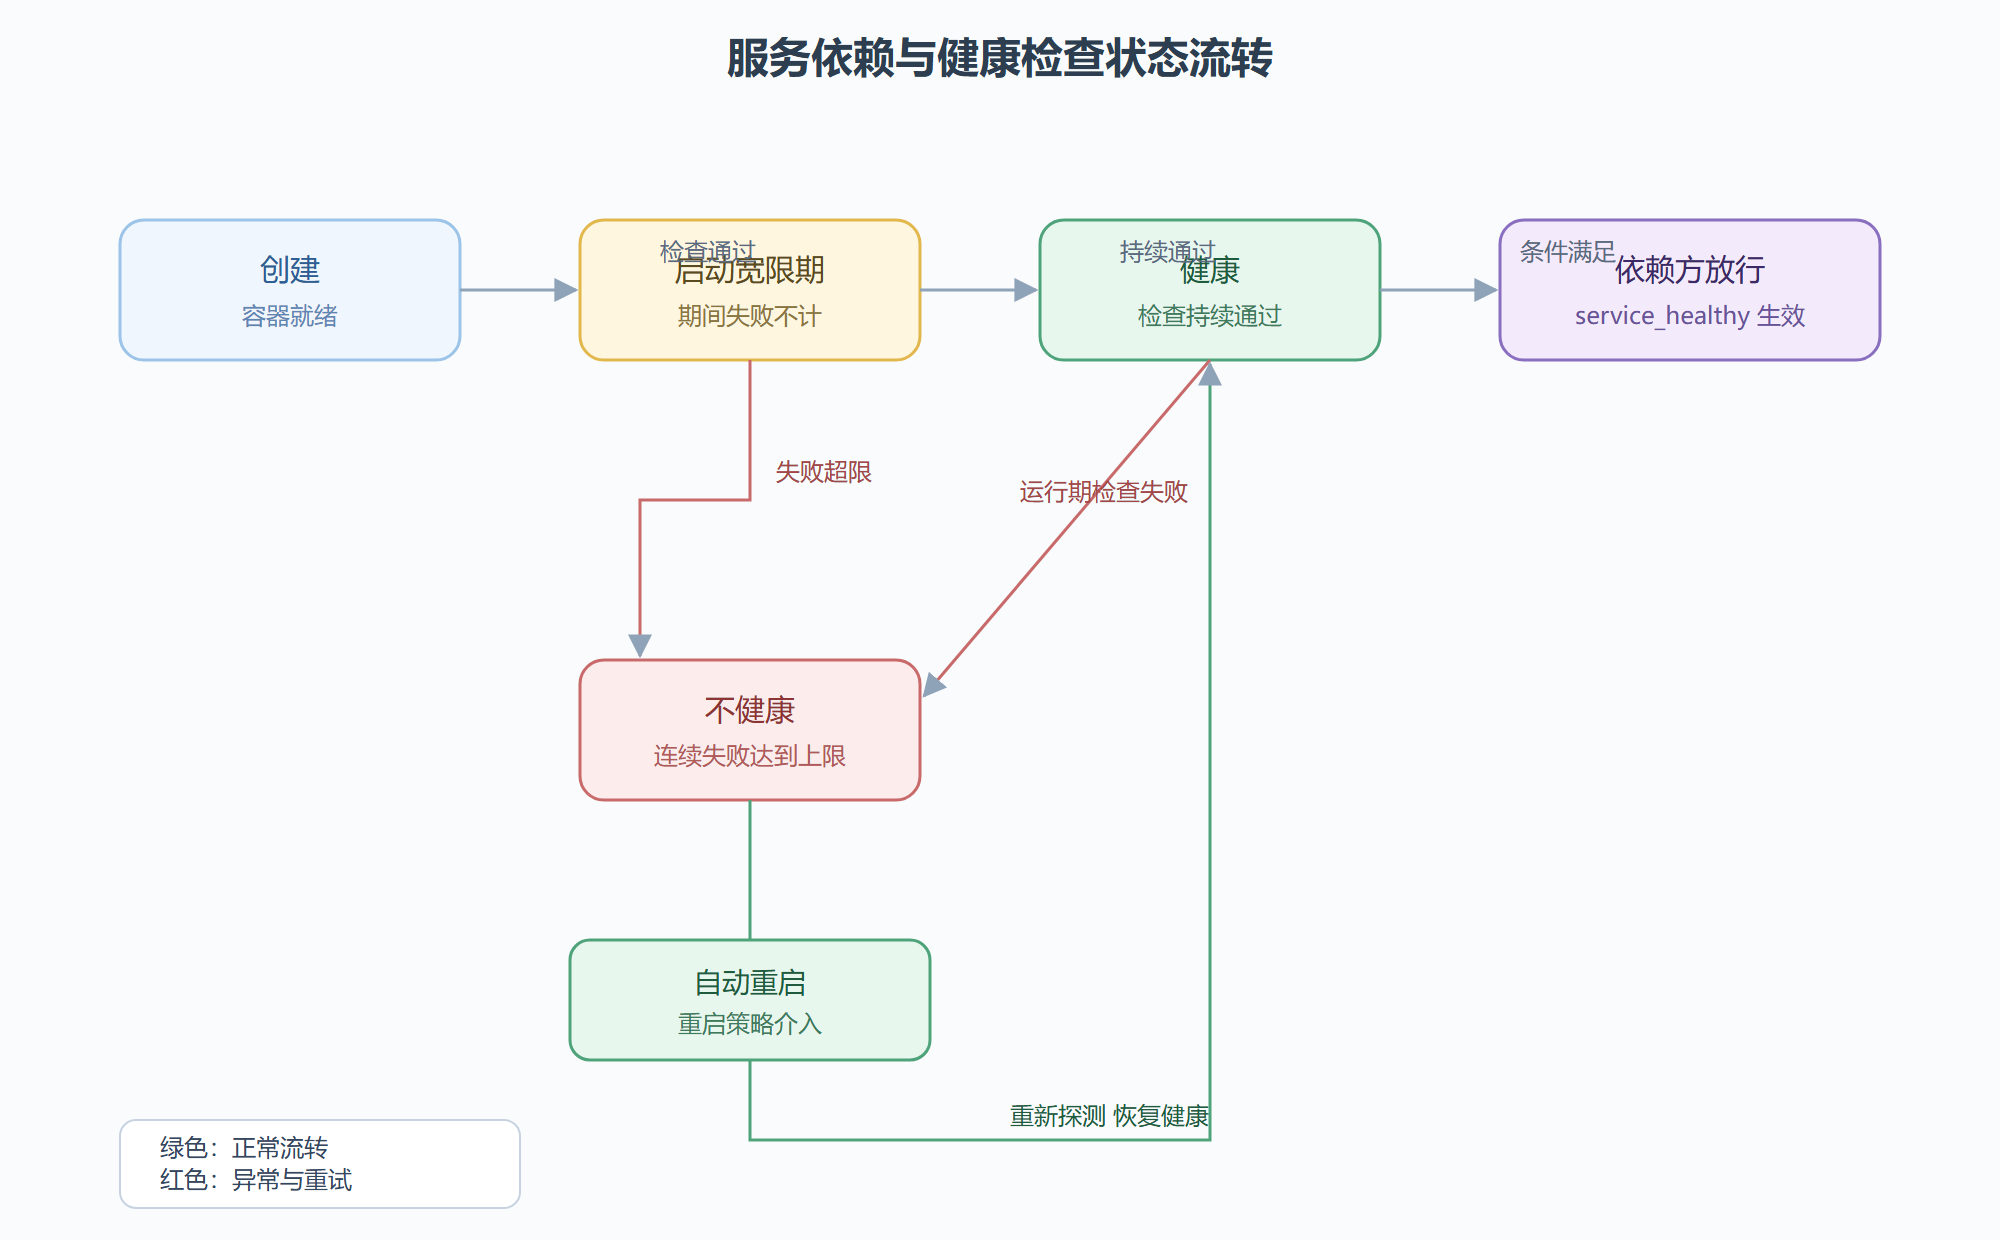
状态流转的关键点是:不健康不等于永久下线。依赖 restart 策略,容器会被重启,重启后重新进入启动宽限期,再探测、再恢复。start_period 与 retries 的配合决定了"多给一次机会"的窗口有多大。
六、健康检查的常见坑
探测命令写错对象。 检查的是服务端口却探测了管理端口,或者 curl 一个不存在于镜像里的工具,检查永远失败。先手工在容器里执行一遍探测命令,确认能跑通再写进配置。
超时大于间隔。 timeout 比 interval 长时,下一次检查会被上一次挤掉,节奏全乱。timeout 保持明显小于 interval。
start_period 太短。 数据库首启要做初始化,start_period 给 0 秒,慢环境里第一次检查失败就开始计数,重试耗尽就重启,陷入重启循环。宁可给宽裕一点。
检查太频繁。 1 秒一次的健康检查对高负载服务是负担,DB 连接池都被探测请求占满的案例真实存在。间隔 10 到 30 秒是常见区间。
探测地址用了宿主机视角。 探测命令在容器内执行,地址要写容器自己的视角:localhost 或 127.0.0.1,写宿主机 IP 反而连不通,白费一次检查。
语法写错整段作废。 healthcheck 配置写错,compose 会直接拒绝启动服务。test 数组的写法必须完整,CMD 与 CMD-SHELL 大小写敏感,写错一个字母整段配置作废,报错信息会明确指出来。参数也不是一次调好的,上线后结合监控数据再校准间隔与重试次数。
⚠️ depends_on 写循环依赖会直接报错:A 依赖 B、B 又依赖 A,Compose 无法确定启动顺序。设计依赖时保持有向无环,必要时把共享依赖提取成独立服务。
💡 开发期可以临时把健康检查的 interval 调小到 5 秒,加快反馈;上线前再调回 30 秒。改配置不用重建镜像,up 一下即可生效。
七、更多常见镜像的就绪命令
第四节给过主力命令,这里补齐:MongoDB 用 mongosh 执行 ping 确认可写;Elasticsearch 探测集群健康接口;RabbitMQ 自带官方诊断命令;没有现成工具时用 nc 探测 TCP 端口。
| 服务 | 探测命令 | 说明 |
|---|---|---|
| MongoDB | mongosh 执行 ping 命令 | 返回 ok 即健康 |
| Elasticsearch | curl 探测集群健康接口 | 看集群健康状态 |
| RabbitMQ | rabbitmq-diagnostics -q ping | 官方诊断命令 |
| 任意 TCP 服务 | nc -z localhost 端口 | 只探测端口连通 |
写探测命令前先确认镜像里装了对应工具:alpine 系精简镜像经常缺 curl 与 nc,缺什么在 Dockerfile 里补什么,或者改用镜像自带的官方工具。探测命令越简单越好:能用一个命令完成就别写脚本,脚本复杂了本身就成了故障点。实在需要脚本时,把脚本放进镜像而不是挂载进来,避免路径与权限问题。
八、健康检查与周边机制的联动
一个常见误区必须纠正:unhealthy 状态不会自动触发容器重启。restart 策略响应的是进程退出,健康检查失败只是标记状态,进程还活着 restart 就不介入。单机 Compose 里 unhealthy 容器的处置要靠外部:监控告警通知人,或者等进程最终崩溃让 restart 接手。Swarm 模式不同,service 会主动替换 unhealthy 的容器。所以生产环境要把健康检查接进监控告警,别指望它自愈。告警阈值与检查间隔要联动设计:告警延迟至少要覆盖两个检查周期,避免偶发失败触发误报。
健康检查还应与负载均衡联动:前置 Nginx 或 Traefik 周期探测后端实例的健康端点,unhealthy 实例从上游列表摘除,流量不再打过去,这是 2.7 节扩展成立的前提。定位 unhealthy 的原因看 docker inspect 的 health 字段,历次检查的命令、退出码与输出都在里面,失败原因十有八九写在最后一条输出。
九、链条依赖:三层服务串起来
依赖可以串成链条,每环都等上一环健康:
services: web: depends_on: api: condition: service_healthy api: depends_on: db: condition: service_healthy db: healthcheck: test: ["CMD-SHELL", "pg_isready -U example -d example"]
启动顺序被推导成:db 健康 api 才启动,api 健康 web 才启动,每一环的就绪标准由自己的 healthcheck 定义。链条越长启动越慢,但每环都稳,这是生产环境多服务编排的标准姿态。condition 还有另外两个取值:service_started 等价于短语法的"只等启动",service_completed_successfully 用于等待一次性任务正常结束,按语义选。链条依赖的调试也有规律:从最底层开始验证,db 先健康,再看 api,逐层向上,哪一层卡住就聚焦哪一层,别从顶层往下猜。
核心回顾
- depends_on 只排顺序:容器先启动,不代表服务就绪,就绪必须靠 healthcheck。
- 退出码即健康:探测命令返回 0 健康、非 0 不健康,命令要打在服务功能上。
- 五个参数各管一段:test 定命令,interval 定频率,timeout 定上限,retries 定容忍,start_period 给慢启动留窗口。
- 条件依赖用长语法:condition: service_healthy 让依赖方等到健康再启动。
- 就绪命令挑现成的:pg_isready、redis-cli ping、curl 与 wget 各有适用镜像。
- 状态可查可排:docker ps 看健康列,docker inspect 看失败原因。
- 参数搭配防死循环:start_period 与 retries 配合,避免慢启动服务被反复重启。
服务能健康启动了,最后一个问题是:流量上来了怎么办——2.7 节讲扩展与伸缩,以及为什么不是所有服务都能随便扩。