3.3 消息队列与缓存模板
3.3 消息队列与缓存模板
本节摘要:消息队列与缓存模板覆盖四类组件:RabbitMQ 带管理面板的完整配置、Kafka 的 KRaft 单节点与 ZooKeeper 模式对比、Redis 的持久化与内存限制、Memcached 的纯缓存定位。每份配置都给出端口、数据卷、账号与内存参数,并讲清"什么时候该用队列、什么时候该用缓存"的选型边界。
先说结论
- 能写出带管理面板和默认账号的 RabbitMQ 配置
- 能搭 Kafka 单节点,并说清 KRaft 模式与 ZooKeeper 模式的本质区别
- 能为 Redis 配置密码、持久化和内存上限
- 能理解 Memcached 无持久化的定位与适用场景
- 能根据业务特征在四种组件里做出选型
一、选型先分清两类组件
消息队列和缓存经常被放在一起提,但解决的是两个方向的问题:队列做的是异步解耦,把"立即处理"变成"稍后处理",削峰填谷;缓存做的是加速,把热点数据放在离应用更近的地方。混用是架构事故的常见源头——拿队列当缓存用,延迟和成本都受不了;拿缓存当队列用,消息丢了没人知道。
二、RabbitMQ 模板
RabbitMQ 实现 AMQP 协议,特点是路由灵活、消息确认机制完善,适合订单、通知这类要求"每条消息都被处理"的业务。官方镜像分两种:不带管理界面的纯服务镜像和管理镜像,模板直接用带面板的:
services: rabbitmq: image: rabbitmq:3.9-management container_name: rabbitmq restart: always ports: - "5672:5672" - "15672:15672" environment: RABBITMQ_DEFAULT_USER: my_user RABBITMQ_DEFAULT_PASS: my_password volumes: - rabbitmq_data:/var/lib/rabbitmq healthcheck: test: ["CMD", "rabbitmq-diagnostics", "-q", "ping"] interval: 30s timeout: 10s retries: 3
rabbitmq:3.9-management:management 后缀的镜像内置 Web 管理面板,5672 是 AMQP 业务端口,15672 是管理面板端口。浏览器访问宿主机 IP 的 15672 端口就能看到队列、连接、消息速率的实时视图。RABBITMQ_DEFAULT_USER与RABBITMQ_DEFAULT_PASS:镜像启动时创建默认管理员。如果不设置,管理面板用 guest 账号、guest 密码登录,而且官方出于安全考虑限制 guest 只能从回环地址访问——这会导致从容器外连不上,报错还很隐晦。所以这两个环境变量不是可选项,是必填项。rabbitmq_data:/var/lib/rabbitmq:消息、队列元数据、用户配置都存在这里,不挂卷的话,容器重建后所有队列和账号全部消失。- 健康检查用
rabbitmq-diagnostics -q ping,返回 pong 才认为存活,比探测端口可靠——端口通不代表 broker 就绪。
变体:内存紧张的机器可以用 alpine 版 rabbitmq:3.9-management-alpine,体积小一半;要 Prometheus 指标就换带 -alpine 加插件,或者在管理面板里启用 rabbitmq_prometheus 插件。
⚠️ 消息持久化是双层的:队列要声明 durable,消息要标记 persistent,两者缺一,RabbitMQ 重启后消息照样丢。compose 模板只负责"存储介质"这一层,业务代码里漏了声明,卷挂了也白搭。
监控面板与指标端点。管理面板的 Overview 页有几个数要常看:queue 数量与积压量、unacknowledged 消息数、连接数与 channel 数。积压持续上涨说明消费者跟不上,先看消费者日志而不是加队列。management 镜像还自带 Prometheus 指标端点,路径是 15672 端口下的 /metrics,需要登录凭据,把它加进 3.5 节的抓取配置里,队列积压就能上告警——我们实践下来,这是消息中间件最重要的监控项。
三、Kafka 模板:从 ZooKeeper 到 KRaft
Kafka 是分布式流平台,按追加日志的方式存消息,吞吐量高一个量级,代价是部署复杂度也高一个量级。传统部署依赖 ZooKeeper 做集群协调:
services: zookeeper: image: confluentinc/cp-zookeeper:7.3.0 container_name: zookeeper ports: - "2181:2181" environment: ZOOKEEPER_CLIENT_PORT: 2181 ZOOKEEPER_TICK_TIME: 2000 kafka: image: confluentinc/cp-kafka:7.3.0 container_name: kafka depends_on: - zookeeper ports: - "9092:9092" environment: KAFKA_BROKER_ID: 1 KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181 KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://kafka:9092,PLAINTEXT_HOST://localhost:9092 KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: PLAINTEXT:PLAINTEXT,PLAINTEXT_HOST:PLAINTEXT KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1 volumes: - kafka_data:/var/lib/kafka volumes: kafka_data:
配置里最绕的是监听器三件套,逐行拆:
KAFKA_BROKER_ID: 1:broker 的唯一编号,集群里必须各不相同。KAFKA_ADVERTISED_LISTENERS:告诉客户端"用这个地址连我"。容器内部客户端用PLAINTEXT://kafka:9092,宿主机客户端用PLAINTEXT_HOST://localhost:9092。这个地址写错是 Kafka 第一坑:容器内一切正常,宿主机连不上,报 unknown host 或连接超时。KAFKA_LISTENER_SECURITY_PROTOCOL_MAP:把两个监听器名映射到明文协议。KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT:broker 之间互相通信用哪个监听器。KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1:单 broker 下副本因子只能设 1,设成 3 会因副本不足起不来——复制 3.2 节的多副本思路前先数数自己有几个 broker。- 数据卷挂到
/var/lib/kafka,日志与元数据都在里面。
KRaft 模式:从 Kafka 3.3 起官方推荐去掉 ZooKeeper,让 broker 自己管元数据,这就是 KRaft。单节点模板大幅简化,一个容器搞定:
services: kafka: image: apache/kafka:3.7.0 container_name: kafka ports: - "9092:9092" environment: KAFKA_NODE_ID: 1 KAFKA_PROCESS_ROLES: controller,broker KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka:9093 KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093 KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://localhost:9092 KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1 volumes: - kafka_data:/var/lib/kafka/data
KRaft 与 ZooKeeper 模式的关键差异:
| 维度 | ZooKeeper 模式 | KRaft 模式 |
|---|---|---|
| 协调者 | 独立 ZooKeeper 集群 | broker 内嵌 controller 角色 |
| 组件数量 | 至少两套镜像 | 一个镜像 |
| 元数据存储 | ZooKeeper 数据目录 | 日志目录内的元数据分区 |
| 适用场景 | 老版本兼容、存量集群 | 新部署首选 |
单节点演示用 KRaft 最省事;但要组成多节点集群,KRaft 的 controller 数量与投票配置更讲究,生产上多数团队直接用托管 Kafka 服务。
💡 Kafka 的消费者不删消息:消费只是移动 offset,消息按保留策略过期。想验证消费行为,用 kafka-console-producer.sh 与 kafka-console-consumer.sh 一对脚本最直接,容器里自带。
四、Redis 模板
Redis 身兼三职:缓存、内存数据库、轻量消息代理。模板按"缓存加持久化"的通用形态给:
services: redis: image: redis:7.0 container_name: redis restart: always ports: - "6379:6379" command: redis-server --requirepass my_redis_password --maxmemory 256mb --maxmemory-policy allkeys-lru --appendonly yes volumes: - redis_data:/data healthcheck: test: ["CMD", "redis-cli", "-a", "my_redis_password", "ping"] timeout: 20s retries: 3 start_period: 5s volumes: redis_data:
--requirepass my_redis_password:开启密码。Redis 默认无鉴权,映射端口后等于把数据目录公开。密码会出现在进程参数里,容器内 ps 可见,同主机多租户场景要用 config 文件方式管理。--maxmemory 256mb加--maxmemory-policy allkeys-lru:限制内存并指定淘汰策略。不设上限的 Redis 会把宿主内存吃光,触发 OOM 杀进程;allkeys-lru 是"全体键按最近最少使用淘汰",适合缓存场景。--appendonly yes:开启 AOF 持久化,每次写操作追加到日志文件,崩溃后最多丢一秒数据;默认的 RDB 快照模式是定期全量落盘,两种方式可以同时开。数据写到/data卷。- 健康检查
redis-cli -a 密码 ping:开了 requirepass 后,不带密码的 ping 会返回 NOAUTH 错误,检查命令必须同步带上密码。
变体:纯会话缓存场景可以关掉持久化(去掉 appendonly),性能更好,反正丢了重新登录就行;要哨兵高可用则要三节点加 sentinel 容器,配置量级完全不同。
⚠️ 密码与健康检查是连体婴:改密码时忘记同步 healthcheck 里的 -a 参数,容器会被判定不健康,依赖它的服务全部排队等待——这类问题日志里通常看不出明显异常,改配置时多留个心眼。
五、Memcached 模板
Memcached 是资历最老的内存缓存,只做一件事:键值缓存。它没有持久化、没有数据结构、没有鉴权,换来的是极致的简单与性能:
services: memcached: image: memcached:1.6 container_name: memcached restart: always ports: - "11211:11211" command: memcached -m 128 healthcheck: test: ["CMD", "memcached-tool", "127.0.0.1:11211", "stats"] interval: 30s timeout: 5s retries: 3
memcached:1.6:官方镜像,1.6 是目前的主力稳定版。-m 128:限制可用内存 128MB,超过后按 LRU 淘汰旧数据。不设这个参数会默认吃满可用内存。- 无数据卷:Memcached 的数据只存在于内存,容器重启全部清空,这是特性不是缺陷——它只缓存可重建数据,比如页面片段、计算结果。
与 Redis 的分工:团队里我们习惯把 Memcached 留给"丢了完全无感"的纯缓存,把 Redis 留给需要数据结构、需要持久化、需要做分布式锁的场合。两个都用纯缓存功能时,选 Redis 一个就够,少一个组件少一份运维。
分布式缓存的客户端视角。Memcached 和 Redis 集群的"分布式"都发生在客户端:客户端按一致性哈希把键分到不同实例,某个实例挂掉只影响落在它上面的键。这意味着扩容缩容不是加个容器那么简单,客户端实例列表要同步更新,否则哈希环变化会引发大面积缓存穿透。单机场景不用操心这个,但规划时要知道:缓存集群的容量是"实例数乘单实例内存",扩容要同时改 compose 和客户端配置两处,少改一处就会出现部分键反复穿透数据库。
六、生产化的几个细节
模板能跑通,但四个组件各有几个只有上了真实业务才遇得到的配置点:
RabbitMQ 的虚拟主机与权限。默认 vhost 是根路径,所有用户都挤在里面,隔离性差。管理面板里建一个以项目命名的 vhost,再把应用账号的权限限定到该 vhost 的读写:生产者给 configure 加 write,消费者给 read,谁也不能删队列。账号按应用分,一个应用一个账号,出事时从管理面板的活跃连接能一眼看出是哪个应用在捣乱。
Kafka 的分区与保留策略。单 broker 演示不在乎分区,但写业务前要明白:topic 的分区数决定并行度,消费组里的每个消费者分管一部分分区,消费者数量超过分区数时,多出来的消费者闲着。创建 topic 时定分区数,事后扩容分区数可以,但会打乱键的分布。数据保留用 KAFKA_LOG_RETENTION_HOURS: 168 这类参数控制,默认七天;消息不会被消费掉就消失,是到期清理,这个心智模型和 RabbitMQ 完全不同。
Redis 的 RDB 触发条件。--appendonly yes 走 AOF 后,RDB 快照仍然可以同时开,两者不是互斥的。RDB 的触发条件通过 save 参数配置,默认的 save 900 1 表示 900 秒内至少 1 次写就落盘一次快照,重启动加载快、占用空间小;AOF 记录每条写操作,丢数据窗口小但文件大。混合模式是折中:AOF 重写时生成 RDB 格式的基座。缓存场景关持久化,需要恢复能力的场景开 AOF,这个选择要在模板阶段就定下来,因为改持久化策略通常要重启服务。
同机跑多实例 Redis。一个项目要独立的 Redis 命名空间时,可以复制服务块改端口:redis-cache 映射 6380、redis-session 映射 6381,各自挂自己的卷、配自己的密码。端口和卷名不冲突,两个实例互不干扰。这个做法也适用于临时起一个纯净 Redis 验证想法,用完 docker compose rm -f redis-cache 连卷一起删。
生产者确认与消费幂等。消息队列的可靠性是两端的约定:RabbitMQ 里生产者要开 publisher confirms,确认消息真的进队列;Kafka 生产者设 acks=all。消费者这边,网络抖动会导致"处理完没来得及提交,队列又投递一次",所以消费逻辑必须幂等——同一消息处理两次结果一致。模板解决不了幂等,它取决于业务代码,但选型时就该知道:RabbitMQ 适合"每条都要处理、允许少量重复",Kafka 适合"海量事件、按序重放"。
组件参数对照
| 组件 | 镜像 | 业务端口 | 管理端口 | 持久化 | 典型用途 |
|---|---|---|---|---|---|
| RabbitMQ | rabbitmq:3.9-management | 5672 | 15672 | 队列与元数据 | 任务分发、通知 |
| Kafka | apache/kafka:3.7.0 | 9092 | 无 | 分区日志 | 流处理、事件总线 |
| Redis | redis:7.0 | 6379 | 无 | RDB 或 AOF | 缓存、会话、锁 |
| Memcached | memcached:1.6 | 11211 | 无 | 无 | 纯缓存加速 |
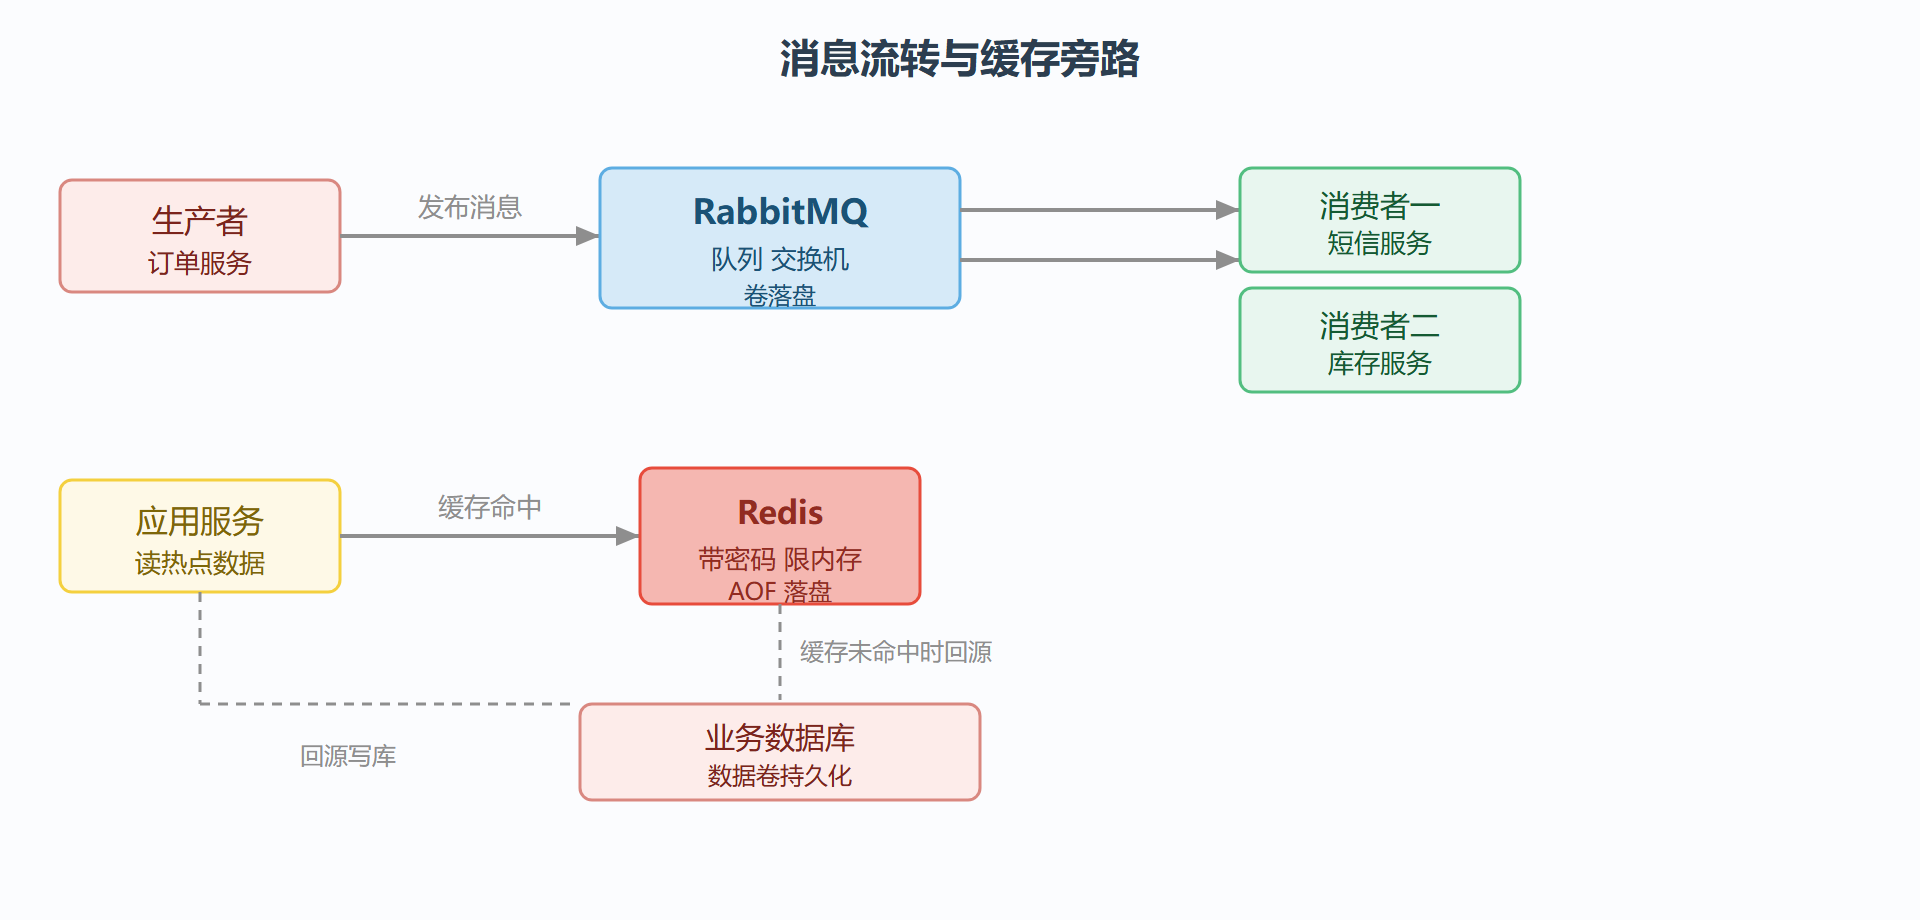
图 3-4 消息流转与缓存旁路拓扑图
温故知新
- 队列做解耦,缓存做加速:两个方向的需求不要混用组件
- RabbitMQ 默认账号必须显式设置:guest 只能从回环访问,容器外连不上
- Kafka 的坑在 advertised listeners:客户端连不上先检查这里
- 单 broker 副本因子只能设 1:多副本先确认 broker 数量
- KRaft 是新部署首选:少一套 ZooKeeper,单节点模板更简单
- Redis 三件套:密码、maxmemory 加淘汰策略、持久化策略
- Memcached 只放可重建数据:无持久化是定位而不是缺陷
- 改密码要同步改健康检查:漏改一个 -a 参数,容器就永远不健康
下一节换个视角,看看怎么用模板把开发和测试环境武装起来——热重载、mock 依赖、一次性测试库都在那里。