4.6 CI/CD 流程集成
4.6 CI/CD 流程集成
本节摘要:CI/CD 流程集成把部署从"人肉操作"变成"代码驱动的流水线"。Compose 在其中的角色是"环境即代码":同一份 compose 文件同时定义开发、测试、生产环境,从根上消除环境差异。核心内容有三块:典型流水线的构建、测试、部署五步;用基础文件加覆盖文件组织多环境;与 Jenkins、GitLab CI、GitHub Actions 的集成思路。本节给出多环境文件组合的完整示例、环境对照表和一张流水线阶段图。
先说结论
- 能解释"环境即代码"的含义,说清 Compose 为什么能保证测试环境一致性
- 能写出典型流水线的五步及每步对应的 compose 命令
- 能用基础文件加覆盖文件的组合组织开发、测试、生产三套环境
- 能描述与 Jenkins、GitLab CI、GitHub Actions 的集成思路,理解共通的模式
一、Compose 在 CI 里的角色:环境即代码
CI/CD 最难的不是自动化,是"自动化出来的环境跟预期一致"。传统做法里,测试环境靠运维手工搭建,生产环境又是另一套配置,环境差异制造了大量"在我机器上好好的"式的返工。Compose 把这个问题结构性地解决了:应用的环境被写进 docker-compose.yml,一份文件同时定义开发、测试、生产,环境差异被压缩到"覆盖文件"这一个受控入口。
这套思路有几个直接的好处。构建流程被简化成一个命令:docker-compose build 按依赖关系一次构建整个应用,不用逐个镜像手动构建。测试可以并行:为每个服务定义测试命令,用 docker-compose run 在干净容器里跑,互不干扰。回滚变得容易:compose 文件和镜像都进版本控制,出问题时切回上一个提交、拉起旧镜像就行。环境一致性还有一个隐性收益——新成员入职、换机器、灾难恢复,都是"拉代码、起服务"两个动作,不再依赖某个人的记忆。
二、典型流水线:提交、构建、测试、推送、部署
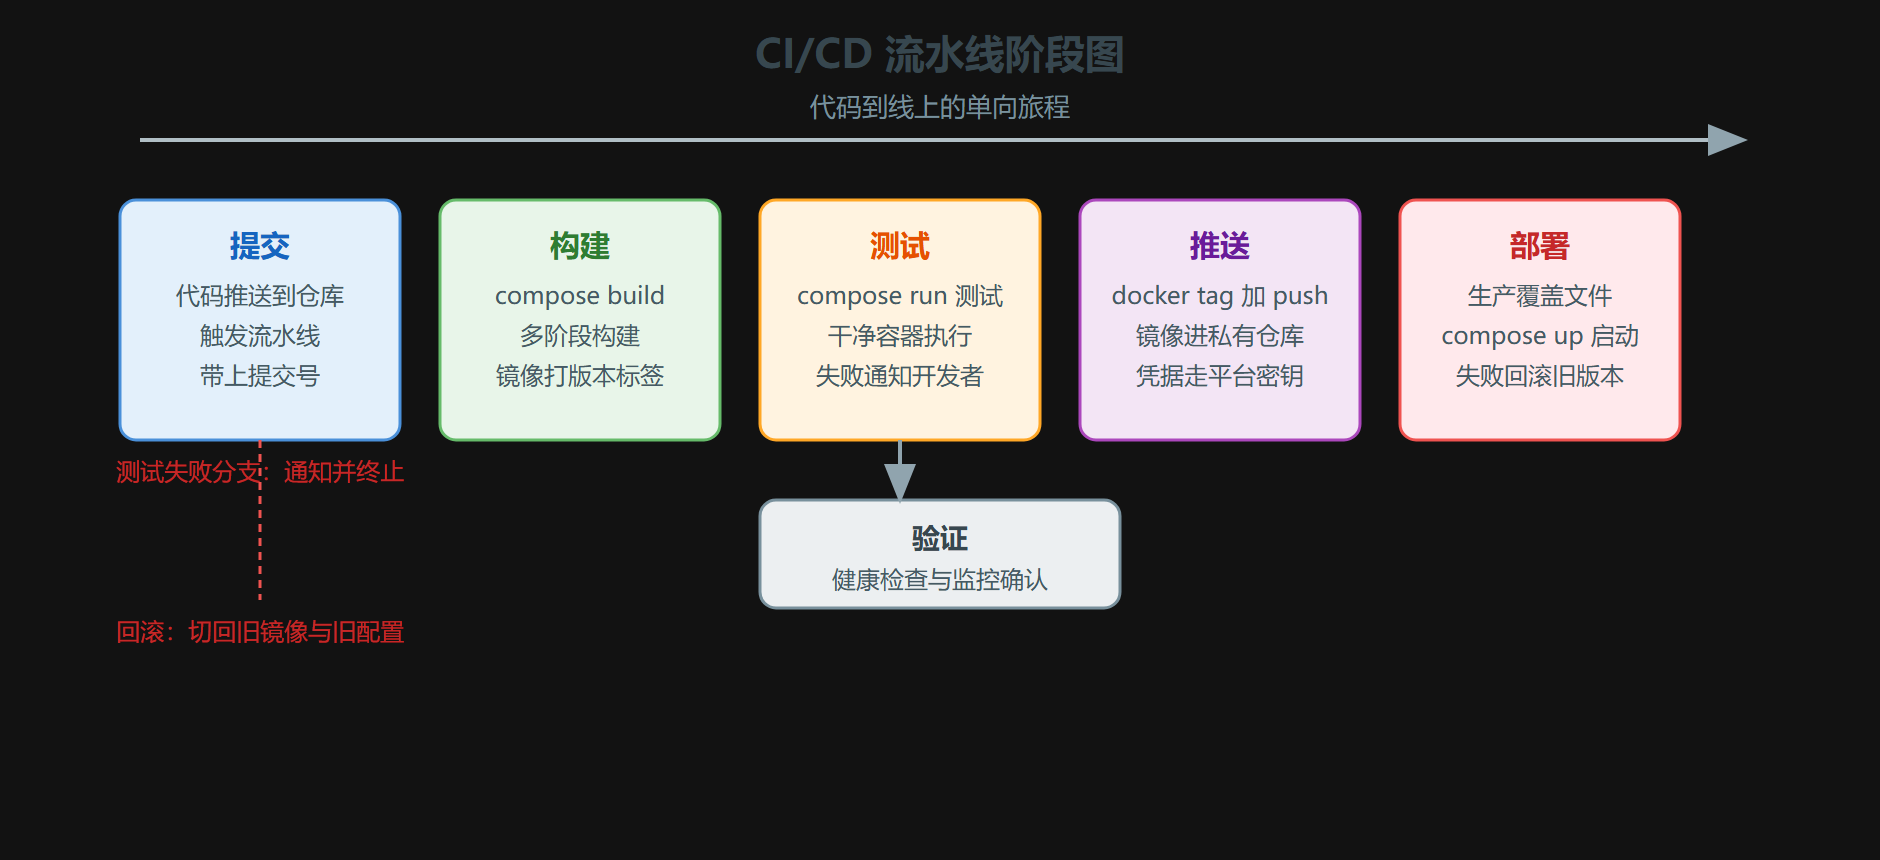
一条典型的 Compose 流水线有五步,每一步对应明确的命令。
提交。 开发者把代码推到版本库,CI 系统监听变更后触发流水线。构建。 CI 执行 docker-compose build 构建镜像。如果镜像要进仓库,先登录:docker login 带上仓库地址与凭据,然后用 docker tag 给镜像打上带版本号的标签(比如用提交号),再 docker push 推上去。测试。 CI 执行 docker-compose run --rm app npm test 这类命令在容器里跑测试。为了保证测试环境干净,习惯是在测试前执行一次 docker-compose down 清场,测试结束后再 down 一次回收。推送。 测试通过后把打好 tag 的镜像推到镜像仓库,失败则通知开发者并终止。部署。 最后在目标环境执行 docker-compose -f docker-compose.prod.yml up -d 启动应用。测试失败走通知分支,成功才继续,这是流水线的闸门逻辑。
回滚在这里变成了廉价操作:保留上一版镜像的 tag 和上一版 compose 文件,up -d 换回旧 tag 即可。前提是镜像 tag 里带不可变标识(提交号或版本号),别用 latest 覆盖来覆盖去——latest 一覆盖,旧版本就找不回来了。
三、多环境组织:base 加 override
多环境是 CI/CD 里最容易写乱的部分。我们的做法是"一个基础文件加按环境的覆盖文件":基础文件只写所有环境共通的东西,环境差异全部放在覆盖文件里。
基础文件 docker-compose.yml,放服务定义、依赖关系、数据卷这些跨环境不变的内容:
version: "3.9" services: app: build: context: . dockerfile: Dockerfile environment: - DB_HOST=db depends_on: - db ports: - "8080:8080" db: image: postgres:14 volumes: - db_data:/var/lib/postgresql/data volumes: db_data:
开发覆盖文件 docker-compose.override.yml,放本地才需要的东西:源码热挂载、调试端口、本地日志级别。Compose 有个默认行为:当前目录存在 docker-compose.override.yml 时,docker compose up 会自动叠加它,开发者不需要额外指定参数。
生产覆盖文件 docker-compose.prod.yml,放生产才需要的东西:固定镜像版本、资源限制、重启策略、secrets 注入。生产环境不依赖自动叠加,而是显式组合:
docker compose -f docker-compose.yml -f docker-compose.prod.yml up -d
-f 可以出现多次,后面的文件覆盖前面的同名配置。三套环境的差异,用一张表就能看清:
| 环境 | 文件组合 | 典型差异 | 触发方式 |
|---|---|---|---|
| 开发 | 基础文件自动叠加开发覆盖 | 源码挂载、调试端口、宽松日志 | 本地手动 up |
| 测试 | 基础文件加测试覆盖 | 测试专用数据库、资源限额 | CI 流水线触发 |
| 生产 | 基础文件加生产覆盖 | 固定 tag、限额、secrets、重启策略 | 流水线部署阶段 |
多环境组合的关系图,mermaid 画一遍:
四、与主流 CI 工具的集成思路
Jenkins、GitLab CI、GitHub Actions 三家工具各有特点,但接 Compose 的模式是共通的,理解了模式,具体平台只是语法差异。
先说共通的三个要点。第一,流水线里要能跑 Docker 命令:Jenkins 通常用 agent 或 Docker 插件提供 Docker 环境,GitLab CI 的经典做法是用 Docker in Docker 服务,GitHub Actions 的 runner 本身就在容器里,需要按平台方式配置 Docker 访问。第二,凭据不要写死在流水线文件里:镜像仓库账号、服务器 SSH 密钥、数据库密码,一律放平台自带的密钥存储(secret 管理),流水线里只引用变量名。第三,部署执行方式一般是两种:流水线直接 SSH 到目标服务器执行 docker compose up -d,或者目标服务器跑一个代理进程监听发布请求——前者简单直接,后者适合服务器不开放 SSH 的场景。
三家工具的差异在于组织方式。Jenkins 是自托管老牌,流水线用 Jenkinsfile 描述,插件生态成熟,适合已经自建 CI 体系的团队;GitLab CI 和代码仓库同源,配置文件 .gitlab-ci.yml 跟着仓库走,天然支持 merge request 触发;GitHub Actions 的 workflow 同样跟仓库走,市场生态大、模板多。选择依据不是"哪个好",而是"代码在哪、团队熟哪个"。
最后一条实践建议:把流水线的阶段定义和 compose 文件放进同一个仓库。这样"环境定义"和"发布过程"一起版本化,任何一次发布都能追溯到对应的代码、镜像和配置文件。
CI/CD 的完整阶段,用泳道图画出来,方便对号入座:
CI/CD 流水线阶段图
五、测试环境的细节与常见坑
流水线的闸门在测试阶段,测试环境的搭建方式直接决定闸门靠不靠谱。我们的做法是:测试阶段用 compose 拉起与被测代码同版本的全套依赖——数据库、缓存、消息队列都起真实的,不用 mock 替身。命令套路是 docker compose -f docker-compose.yml -f docker-compose.test.yml up -d 起环境,测试用例用 docker compose run --rm 在干净容器里执行,跑完再 down 掉回收。测试数据初始化要幂等:每次环境重建后能重复执行,不会因为上次的残留数据导致测试结果漂移。
这个环节有几个常见坑。端口冲突:CI 机器上同时跑多个项目的测试,大家默认端口一样,互相踩。测试环境一律用随机或按项目隔离的端口映射,或者干脆不映射端口,测试容器走内部网络。测试依赖外部网络:测试用例里请求外部服务,网络抖动一次挂一次,测试环境要能离线跑。忘了 down:测试结束不回收容器,CI 机器上残留一堆容器占资源,攒几个月机器就废了。环境变量泄漏:测试配置里硬编码了生产地址,测试期间把数据写进生产库——测试环境的数据库连接串必须显式指向测试库,宁可测试挂掉也不要误写生产。
流水线本身还有两个容易被低估的环节。镜像安全扫描:构建完成后、推送前扫一遍镜像漏洞,高危直接阻断发布,这条和 4.2 的依赖扫描呼应,扫描规则和基础镜像更新频率挂钩,别等漏洞公开了才想起来补。发布验证:部署完成后不是结束,还要做健康检查确认——探活接口、日志无异常、监控指标正常,验证失败自动触发回滚。我们习惯把验证步骤写进流水线而不是靠人盯,人盯的验证步骤在凌晨发版时总是被跳过。
六、流水线的速度与失败处理
流水线除了正确性,还要快——流水线慢了,开发者就会想办法绕过它,这是 CI 文化崩塌的开始。三个提速手段最有效。构建缓存持久化:CI 每次从零构建等于抛弃了 4.3 讲的缓存收益,把 Docker 构建缓存挂到 CI 机器上的持久卷,二次构建命中依赖层,时间能省一半以上。只测受影响的部分:全量测试跑半小时,改动只涉及前端就只跑前端测试,按变更路径裁剪测试集,闸门照样有效。并行阶段:构建、静态检查、单元测试互不依赖的步骤并行执行,总耗时按最长的那个算,而不是所有步骤之和。
失败处理同样要设计。失败即通知:构建或测试失败第一时间通知提交者,通知里带上失败阶段和日志链接,别让开发者自己去翻。失败产物可查:失败的构建日志、测试报告要留存至少一周,事后复盘要靠它们。失败不静默重试:流水线失败后自动重试一次可以接受,但重试要打日志标记,连续失败两次就该告警到人——静默重试会把间歇性问题掩盖成偶发。
最后提醒一句:流水线的每一步都应该有明确的失败动作,要么终止,要么回滚,要么通知。没有失败动作的步骤,等于没有闸门。
⚠️ 流水线里别用 latest 覆盖镜像。每次构建都用 latest 推同一个标签,旧版本就被覆盖掉了,回滚时找不到"上一个版本"。用提交号或版本号做不可变标签,latest 只做"当前最新"的软链接。
💡 override 自动叠加是双刃剑。开发时它省事,但生产机器上若残留了 override 文件,up 会悄悄叠加它——所以生产部署一律用显式 -f 组合,并在服务器上只保留生产覆盖文件。
核心回顾
- 环境即代码:同一份 compose 文件贯穿三套环境,差异收口到覆盖文件。
- 一条命令构建全栈:docker-compose build 按依赖关系构建整个应用。
- 测试在干净容器里跑:compose run 加 --rm,测试前后各 down 一次。
- 镜像标签要不可变:提交号或版本号做 tag,latest 只作软链接。
- 多环境用 base 加 override:开发覆盖自动叠加,生产覆盖显式 -f 组合。
- 集成模式三共通:Docker 环境、凭据走平台密钥、SSH 或代理执行部署。
- 工具选择看代码托管位置:Jenkins 自托管、GitLab CI 同源、GitHub Actions 生态大。
- 流水线与 compose 同仓:环境定义和发布过程一起版本化,发布可追溯。
下一节回答本章最大的问题——单机不够用了,往 Swarm 还是 Kubernetes 走?