并查集
3.4 并查集:动态连通性的终结者
本节摘要:并查集是"结构极简、优化极美"的典范。本节从朴素双亲表示的线性退化讲起,依次引入按秩合并与路径压缩两大优化,用朋友圈数量问题完整演示流程,并解释它为什么能以近乎常数的均摊复杂度处理海量合并与查询。
只做两件事,做到极致
本章压轴结构的前缀树专治前缀查询,并查集专治的问题更抽象:动态连通性。场景是平面上有一堆元素,不断收到两种请求——把两个元素归为一伙(合并),以及问两个元素是不是一伙(查询)。图论语言说:支持加边的图,随时问两点是否连通。看上去平淡无奇,但海量请求之下(十的九次方级别),每步省一点点就是能与不能的分界,而并查集交出的均摊复杂度近乎常数,是算法史上最漂亮的成绩单之一。
朴素想法很直白:给每个元素记个"组号",合并时把一组的组号全改成另一组的。查询是 O(1),合并却是 O(n)——要改一整组的号。反过来用树形表示:每个节点记一个父指针,组就是一棵树,根是组的代表。查询=沿父指针爬到根,比较两棵树的根是否相同;合并=把一棵树的根挂到另一棵树的根下。但朴素的树形表示有个致命退化:总把左树挂到右树下,链会越挂越长,查询退化成 O(n)。
class DSU: def __init__(self, n): self.parent = list(range(n)) # 初始各自成组,父指向自己 self.rank = [0] * n # 秩:树高的上界 def find(self, x): while self.parent[x] != x: x = self.parent[x] return x def union(self, a, b): ra, rb = self.find(a), self.find(b) if ra == rb: return False # 已同组 if self.rank[ra] < self.rank[rb]: ra, rb = rb, ra self.parent[rb] = ra # 矮树挂到高树下 if self.rank[ra] == self.rank[rb]: self.rank[ra] += 1 return True d = DSU(6) d.union(0, 1) d.union(1, 2) d.union(3, 4) print(d.find(0) == d.find(2)) # 输出 True(0 与 2 已连通) print(d.find(0) == d.find(3)) # 输出 False
一、两大优化:一条递归与一个纪律
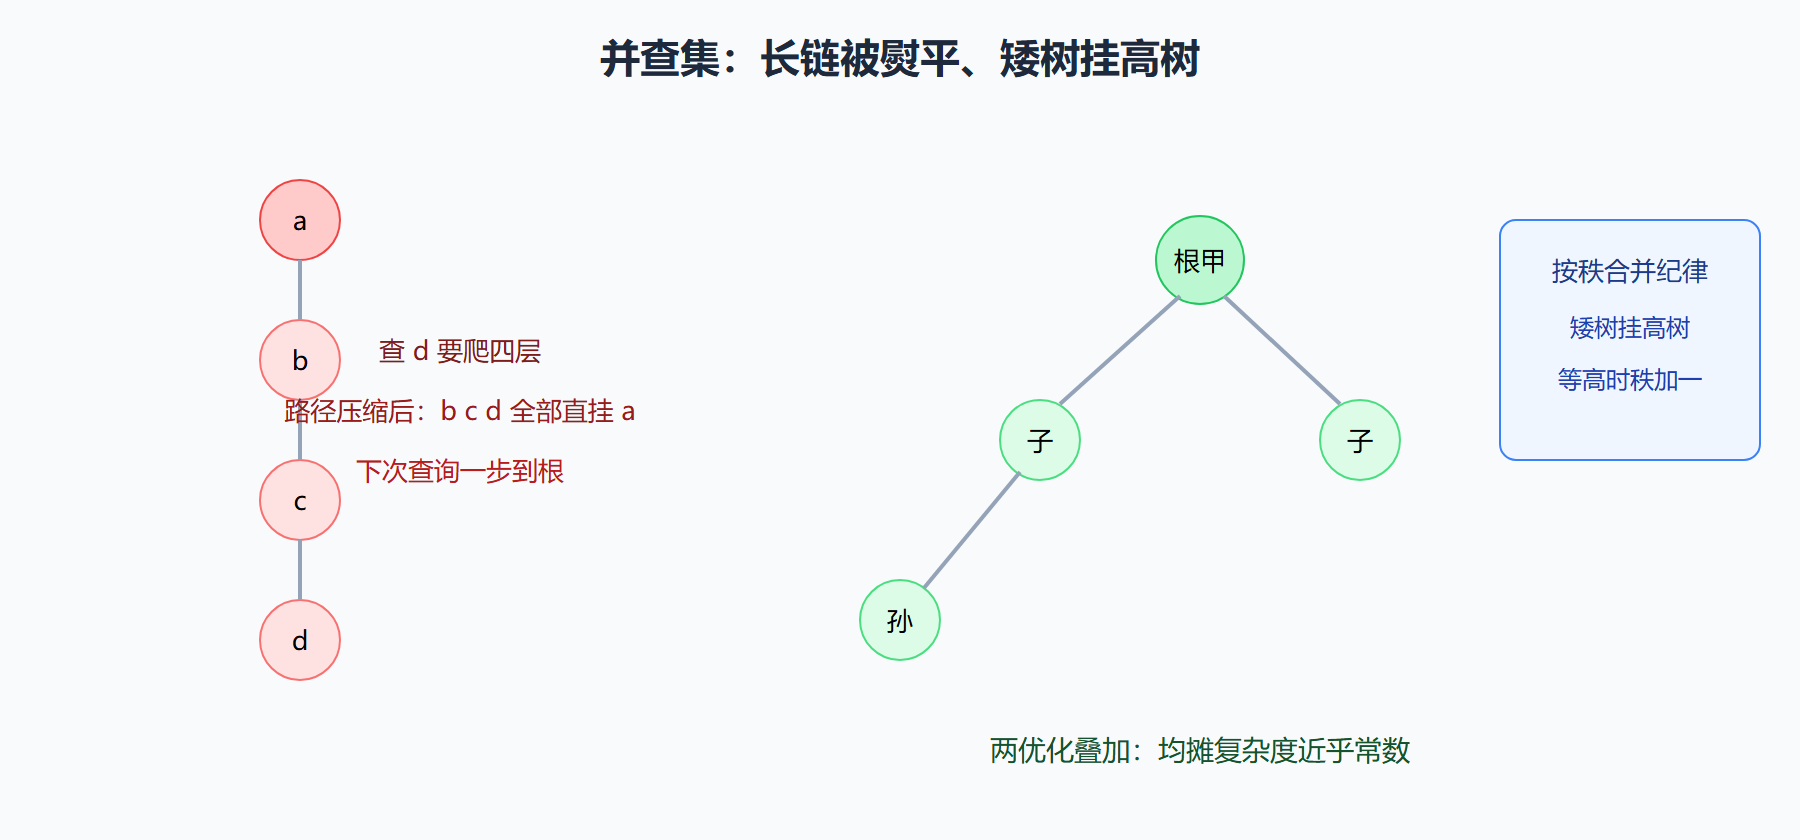
优化一是路径压缩,改在 find 上:爬到根之后,顺手把沿途每个节点的父指针直接改成根。下次任何人从这条路上爬,一步到根。递归版只有一行额外代码,效果却是沿途整条链被"熨平"。优化二是按秩合并,改在 union 上:永远把矮树挂到高树下,保证树高不失控——两者叠加后,树高在均摊意义下增长得极慢。把递归 find 换成路径减半的迭代版,可以规避深递归的栈问题:
def find_iter(self, x): while self.parent[x] != x: self.parent[x] = self.parent[self.parent[x]] # 路径减半 x = self.parent[x] return x
两优化齐备后的复杂度结论值得背下来:n 次操作的总耗时是 O(n 乘 alpha(n)),alpha 是反阿克曼函数——它增长慢到对现实世界的任何 n 都不超过四,因此工程上视为常数。这个结论的解释角度:单次操作仍可能很贵(爬条长链),但任何单次的昂贵都会让后续无数次变便宜,把昂贵摊到海量便宜上,均摊就近乎常数。这与第一章讲过的动态扩容均摊 O(1) 是同一种分析思想,串起来了。
二、实战:朋友圈数量
经典应用:n 个人,给定若干"认识"关系,朋友的朋友也算朋友,问最终形成几个朋友圈。初始人人自成一个集合,每条认识关系做一次合并,合并真正发生(两个根不同)时朋友圈数减一。第 547 题的标准解法:
def find_circle_num(friend): n = len(friend) dsu = DSU(n) count = n for i in range(n): for j in range(i + 1, n): if friend[i][j] == 1 and dsu.union(i, j): count -= 1 # 合并成功,圈子少一个 return count friend = [ [1, 1, 0], [1, 1, 0], [0, 0, 1], ] print(find_circle_num(friend)) # 输出 2
同一套结构稍加变形就能覆盖一大类题:岛屿数量(相邻陆地合并,数最终集合个数)、冗余连接(加边时两端已连通,这条边就是多余的)、账户合并(邮箱归并到人)、最小生成树的克鲁斯卡尔算法(边排序加并查集判环)。识别信号非常固定——题目在问"是否同属一组"或"分组个数",且分组关系动态到达,就用并查集。
两大优化如何驯服树高
四、进阶应用:最小生成树里的并查集
克鲁斯卡尔最小生成树是并查集最著名的联合作战,值得完整走一遍:把所有边按权重升序排序,逐条考察,若边的两端尚未连通(两个根不同)就选入生成树并合并,否则跳过。并查集在这里的职责单一而关键——高效回答"加入这条边会不会成环",等价于"两端是否已连通"。排序 O(m log m) 主导总复杂度,其后 m 次合并与查询在近乎常数的均摊下几乎免费。
def kruskal(n, edges): parent = list(range(n)) def find(x): while parent[x] != x: parent[x] = parent[parent[x]] # 路径减半 x = parent[x] return x total, count = 0, 0 for w, a, b in sorted(edges): ra, rb = find(a), find(b) if ra != rb: parent[ra] = rb total += w count += 1 if count == n - 1: # 生成树已满,提前收工 break return total edges = [(1, 0, 1), (4, 0, 2), (3, 1, 2), (2, 1, 3), (5, 2, 3)] print(kruskal(4, edges)) # 输出 6(选权 1、3、2 的三条边)
边用"权重加两端"的元组表示,排序天然按权重优先。反例演练也有价值:把 break 条件删掉程序照样出对的结果,但会把剩余所有边都白查一遍——数据量大时这就是超时与通过的分界。识别信号再复述一次:题目出现"连通""分组""最少代价把所有点连起来",先想图论模型,再想并查集能不能顶上,最后才考虑更重的最短路或最小生成树模板。
本节要点回顾
- 问题信号:动态加边加"是否同组"或"分组个数"之问,直接上并查集;
- 朴素树形的退化:无纪律合并把链越挂越长,查询退化到 O(n);
- 路径压缩在 find 里、按秩合并在 union 里,两者叠加近乎常数均摊;
- 反阿克曼函数是结论性名词,对现实规模可视为不超过四的常数;
- 克鲁斯卡尔最小生成树是并查集最著名的联合作战,值得完整实现一次。
本章结构链收官。最后一章回到考场与工程:边界怎么守、空间怎么压、这些结构在真实系统里挂在哪。