5.1 文件处理与综合实战
5.1 文件处理与综合实战
本节摘要:真实程序几乎都要和文件打交道——读配置、写日志、处理数据。本节讲清楚文件读写的基本操作、
with语句的资源管理、编码问题的处理,再用一个"日志分析"综合项目把前四章的知识点串起来。通过分层练习,把"从需求到可运行代码"的完整落地能力练出来。
学习目标
阅读完本节,你应当能够:
- 用
open和with正确地读取和写入文本文件 - 处理文件编码问题(UTF-8 与 GBK)
- 逐行读取大文件,避免一次性加载进内存
- 把函数、字典、异常处理组合起来,完成一个综合小项目
- 独立完成一道涉及文件处理的练习题
问题与直觉
到目前为止,你写的程序有个共同特点:数据都是临时的。程序一关,所有变量、列表、字典全都没了。下次再跑,又得重新输入或重新生成。这在真实场景里是行不通的——记账软件得把账目存下来,日志分析工具得读取历史日志,配置管理得读配置文件。
文件读写解决的就是"数据持久化"的问题:把数据写到文件里保存,需要时再读回来。这是程序从"一次性玩具"走向"实用工具"的关键一步。
但文件操作也有它的麻烦:文件可能不存在、可能没权限读、编码可能不对、读写到一半可能出错。这些"现实世界的意外",正是第 2 章异常处理的用武之地。本节的综合项目会把文件读写、异常处理、数据结构、函数组织全用上——你会发现前面学的知识点,在这里自然地拼成一个完整的工具。
核心原理
2.1 文件读写的基本三步
# 写文件:打开 → 写 → 关闭 f = open("note.txt", "w", encoding="utf-8") f.write("第一行\n") f.write("第二行\n") f.close() # 读文件:打开 → 读 → 关闭 f = open("note.txt", "r", encoding="utf-8") content = f.read() print(content) f.close()
open 的第二个参数是模式:"r" 读、"w" 写(覆盖已有内容)、"a" 追加。encoding="utf-8" 指定编码——中文场景一定要显式指定编码,否则在不同系统上可能用默认编码(Windows 常是 GBK)导致乱码。
2.2 with 语句:自动关闭
手动 open 再 close 的最大问题是:万一中间出错了,close 不会被执行,文件就漏关了,可能丢数据或锁住文件。with 语句保证无论是否出错都自动关闭:
# 推荐:with 自动管理 with open("note.txt", "r", encoding="utf-8") as f: content = f.read() # 离开 with 块,f 自动关闭,哪怕上面抛了异常 # 等价于手动 try/finally,但简洁得多
💡 关键直觉:凡是"打开-使用-关闭"模式的资源,一律用
with。这不是可选优化,是基本规范——把"忘记关闭"这类错误从代码层面杜绝。
2.3 三种读取方式
with open("data.txt", encoding="utf-8") as f: # 1. 一次性读全部:适合小文件 text = f.read() # 2. 逐行读取:适合大文件,省内存 for line in f: process(line.strip()) # 3. 读成列表,每行一个元素 lines = f.readlines()
处理大文件(日志、数据集)时,逐行读取是默认选择,因为它不把整个文件加载进内存。
2.4 编码问题
文本文件本质是字节序列,编码决定"字节怎么解释成字符"。中文场景最常见的坑:
# 文件是 UTF-8 保存的,但你没指定编码,Windows 默认用 GBK 读 f = open("中文.txt") # 可能 UnicodeDecodeError 或乱码 # 正确:显式指定编码 f = open("中文.txt", encoding="utf-8")
遇到 UnicodeDecodeError,先想"文件实际是什么编码"——大多数现代文件是 UTF-8,但 Windows 上有些老文件是 GBK。读不了就换个编码试,或用 errors="ignore" 跳过无法解码的字节(会丢字符,谨慎用)。
工程实践要点
3.1 写文件时的换行
不同操作系统的换行符不同:Linux 是 \n,Windows 是 \r\n。Python 默认会做转换(文本模式下 \n 写出时在 Windows 上变成 \r\n),通常不用操心。但写跨平台数据文件时要注意一致性。
3.2 文件路径
# 用原始字符串或正斜杠,避免反斜杠转义 with open(r"F:\data\log.txt", encoding="utf-8") as f: ... # 或用正斜杠(Python 在 Windows 上也接受) with open("F:/data/log.txt", encoding="utf-8") as f: ...
更推荐用 pathlib 或 os.path 拼接路径,能自动处理跨平台差异:
from pathlib import Path p = Path("data") / "log.txt" # 自动用当前系统的分隔符
⚠️ 常见坑:在普通字符串里写 Windows 路径
"F:\new\test.txt",\n和\t会被当成转义字符。要么用原始字符串r"...",要么用正斜杠。
3.3 追加 vs 覆盖
# "w" 模式:覆盖,文件已有内容会被清空! with open("log.txt", "w") as f: f.write("新内容") # 旧内容没了 # "a" 模式:追加,在文件末尾继续写 with open("log.txt", "a") as f: f.write("追加的内容") # 旧内容保留
写日志这类"只增不改"的场景用 "a";重新生成整个文件用 "w"。写文件前先想清楚该用哪个模式,用错模式导致数据丢失是很难恢复的。
3.4 综合项目:日志分析
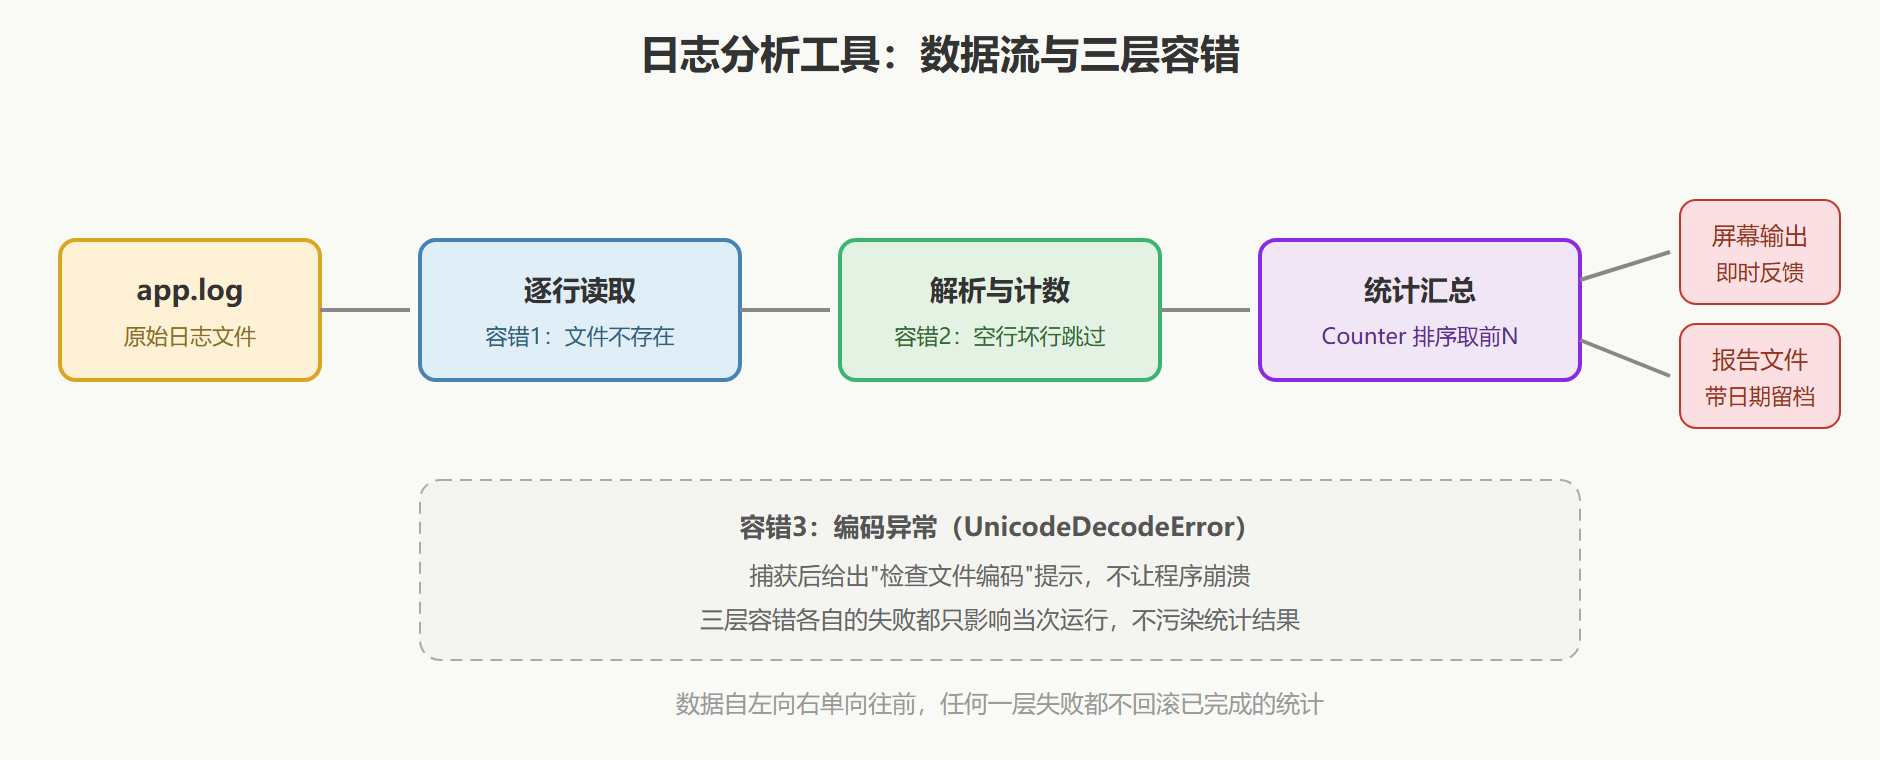
把前面学的串起来,做一个"读取日志文件、统计每个级别的出现次数、输出报告"的小工具。这个项目综合了文件读取、字典计数(或 Counter)、异常处理、函数组织:
from collections import Counter def analyze_log(path): """读取日志,统计各级别出现次数,返回 Counter""" level_counter = Counter() try: with open(path, encoding="utf-8") as f: for line in f: # 逐行读,省内存 # 假设日志格式:[时间] [级别] 消息 parts = line.split() if len(parts) >= 2: level = parts[1].strip("[]") # 取出级别 level_counter[level] += 1 except FileNotFoundError: print(f"日志文件 {path} 不存在") except UnicodeDecodeError: print("编码问题,请检查文件编码") return level_counter def report(counter): """打印统计报告""" print("=== 日志级别统计 ===") for level, count in counter.most_common(): print(f"{level}: {count} 次") # 使用 stats = analyze_log("app.log") report(stats)
注意这个项目的结构:analyze_log 负责读和统计,report 负责输出。职责分离让每个函数好写好测,将来要改输出格式(比如改成写文件而不是打印),只动 report 一处。
分层练习
基础题:读写备忘录
题面:写一个程序,提供两个功能:①把用户输入的一行文字追加到 memo.txt;②读取并打印 memo.txt 的全部内容。用菜单让用户选择。
思路点拨:while 循环显示菜单,追加用 "a" 模式,读取用 "r" 模式。都用 with。
参考骨架:
def add_memo(text): with open("memo.txt", "a", encoding="utf-8") as f: f.write(text + "\n") def show_memo(): try: with open("memo.txt", encoding="utf-8") as f: print(f.read()) except FileNotFoundError: print("还没有任何备忘") # TODO: 加菜单循环,调用上面两个函数
进阶题:成绩文件统计
题面:给定一个成绩文件 scores.txt,每行一个"姓名,分数"(如 小明,85)。读取文件,计算平均分、最高分和对应姓名、按分数从高到低排序输出。
思路点拨:逐行读、split(",") 拆姓名和分数、转 int。用列表存 (姓名, 分数) 元组,sorted 排序,max 找最高。
参考骨架:
def load_scores(path): records = [] with open(path, encoding="utf-8") as f: for line in f: line = line.strip() if not line: continue name, score = line.split(",") records.append((name, int(score))) return records records = load_scores("scores.txt") avg = sum(s for _, s in records) / len(records) top = max(records, key=lambda x: x[1]) ranked = sorted(records, key=lambda x: x[1], reverse=True) print(f"平均分 {avg:.1f}") print(f"最高 {top[0]} {top[1]} 分") for name, score in ranked: print(f"{name}: {score}")
💡 思考延伸:如果文件里有空行或格式错误的行(比如缺了逗号),上面的代码会崩。加上异常处理和格式校验,让它能跳过坏行而不是整个崩溃——这是健壮性的体现。
挑战题:简易通讯录
题面:实现一个命令行通讯录,支持:①添加联系人(姓名、电话);②按姓名查找电话;③列出所有联系人;④退出时保存到文件 contacts.txt,下次启动自动加载。
思路点拨:用字典存 {姓名: 电话},启动时读文件加载,退出时写文件保存。每个功能写成一个函数,主程序用菜单循环。这是文件读写 + 字典 + 函数组织 + 异常处理的综合题。
参考骨架:
def load_contacts(path): contacts = {} try: with open(path, encoding="utf-8") as f: for line in f: name, phone = line.strip().split(",") contacts[name] = phone except FileNotFoundError: pass # 第一次运行,文件不存在,返回空字典 return contacts def save_contacts(contacts, path): with open(path, "w", encoding="utf-8") as f: for name, phone in contacts.items(): f.write(f"{name},{phone}\n") # TODO: 实现菜单循环、添加、查找、列出功能 contacts = load_contacts("contacts.txt") # ... 用户操作 ... save_contacts(contacts, "contacts.txt")
⚠️ 常见坑:退出时才保存,如果程序中途崩溃,本次修改就丢了。更稳的做法是每次添加后立即追加保存,但要注意别和"启动时全量加载"冲突。这是真实工程里要权衡的"性能 vs 可靠性"问题。
追问与答疑
数据该存文本文件还是学用数据库? 初学阶段,文本文件足以支撑所有练习,且有个被低估的优点:肉眼可读、肉眼可改,出问题时直接打开文件排查。文本格式的天花板大约在"几万行、单机、单人写"这个量级——超过它就该考虑 SQLite(标准库自带,零安装)。判断信号有三个:需要按条件查部分数据(文本只能全读再筛)、多个程序同时写(文本会互相覆盖)、数据间有关联(扁平的行表达不了关系)。在那之前别急着上数据库,先用文本把"建模-读写-容错"的基本功练扎实。
日志格式解析为什么这么容易出空指针? 因为真实日志远比练习里的样例脏:空行、半行(程序崩溃时的截断)、格式升级后的历史行、多空格分隔。工程上常用的防御套路是"宽进严出"——解析失败不抛错,记一个失败计数并跳过,最后在报告里呈现"共 N 行,成功 M 行,跳过 K 行"。用户看到跳行数异常会自己查文件,而程序不会因为一行脏数据全军覆没。这个套路在成绩统计、通讯录加载两道题里都可以直接套用,建议动手改一版。
什么时候该把输出也写进文件? 只要结果超过一屏,或需要留档对比,就写文件。实践模式是"报告双通道":统计结果既打印到屏幕(即时反馈),也写入带日期的输出文件(留档)。日志分析工具跑一周后,你自然想对比"这周和上周的 ERROR 数量",届时留档的价值就显现了。写输出文件记得用 "w" 模式配合带时间戳的文件名,避免覆盖历史报告。
图:日志分析工具的数据流与容错层
补充练习:日志行过滤器
题面:写一个函数 filter_log(path, keyword),逐行读取日志文件,返回所有包含指定关键词的行组成的列表;文件不存在时返回空列表并打印提示。再写一段调用代码,把过滤结果写入新文件,文件名在原名后加"过滤后"三个字。
思路点拨:读取用逐行模式配合 if keyword in line 收集;文件不存在捕获对应异常。写出时文件名拼接用字符串加法即可。整题没有新知识,练的是"读-滤-写"三段结构的组织。
参考骨架:
def filter_log(path, keyword): hits = [] try: with open(path, encoding="utf-8") as f: for line in f: if keyword in line: hits.append(line.rstrip("\n")) except FileNotFoundError: print(f"找不到 {path}") return hits result = filter_log("app.log", "ERROR") with open("app过滤后.log", "w", encoding="utf-8") as f: for line in result: f.write(line + "\n") print(f"共筛出 {len(result)} 行")
写完检查两个细节:读到的行末尾带回车,收集时该不该去掉?写回时每行又补了回车——一去一补是否对称?这类"行尾符往返"的小事,是文件处理里最常见的对不齐来源。第二个细节是编码:读和写都显式指定了 UTF-8,若漏写,在另一台默认编码不同的机器上跑同一份代码,筛出的中文内容可能变成乱码。编码参数写起来只有十几个字符,省下的是跨机器排查的整个下午。
实战复盘
- 文件读写三步:打开、操作、关闭;用
with自动关闭,杜绝漏关。 - 模式
r读、w覆盖写、a追加写;写前想清楚该用哪个,用错会丢数据。 - 中文场景必须指定
encoding="utf-8";遇到UnicodeDecodeError先排查编码。 - 大文件逐行读:
for line in f省内存,别无脑read()。 - Windows 路径用原始字符串或正斜杠:避免反斜杠转义。
- 综合项目要职责分离:读、处理、输出各自独立的函数,方便维护和测试。
- 真实数据要考虑异常:文件不存在、格式错误、编码问题,都该有处理而不是让程序崩。
下一节我们练几道经典算法题,并谈谈如何用工程化思维组织稍大的代码。