3.5 区块链数据存储与管理:成品仓与检索台账
3.5 区块链数据存储与管理:成品仓与检索台账
区块链存储分为彼此分工的数层:原始区块文件(不可变的成品库房)、键值数据库(高效检索的台账)、状态树(当前余额与合约存储的折叠快照)以及各种索引。管理难题只有一个——无限追加与有限磁盘的矛盾,对策是修剪、快照与分层归档。本节拆解各层职责,模拟状态读写与修剪策略,并给出节点运维的容量账本。
某天凌晨,全节点磁盘告警
某天凌晨,某条公链的全节点运维收到磁盘告警:同步才数月,数据目录已经吃掉数百吉字节,照此增速下季度就要加盘。加盘只是缓兵之计——账本永不停止追加,磁盘却是有限的。这个矛盾不是运维疏忽,而是设计使然:完整验证要求保留"能独立重放全部历史"的证据链。存储管理的全部艺术,就在于回答"哪些证据必须留、哪些可以扔、扔了之后还验证什么"。
先把成品仓的货架分层看清楚,再谈扔东西的规则。
存储分层:每层回答一个查询
原始区块层:区块以文件序列的形式近乎只读地躺着,按高度切分、顺序追加。它回答"第某高度的区块原文是什么"。键值台账层:通用键值数据库按哈希与高度建索引,回答"这个哈希对应哪个区块、这笔交易在哪个位置"。状态层:当前全网状态的树形结构(账户余额、合约存储、随机数计数器),回答"此刻谁有多少钱"。状态树不存历史,每个新区块产生一棵新根——旧根保留若干检查点后即可丢弃,这正是"状态可修剪而历史不可伪造"的技术前提(树的指纹结构让新旧状态共享未变分支,存储上有增量效果)。索引层:地址到交易的反向索引、事件日志索引,多为节点可选组件,服务于区块浏览器类查询。
图 3-5 存储分层货架:各层回答一个查询
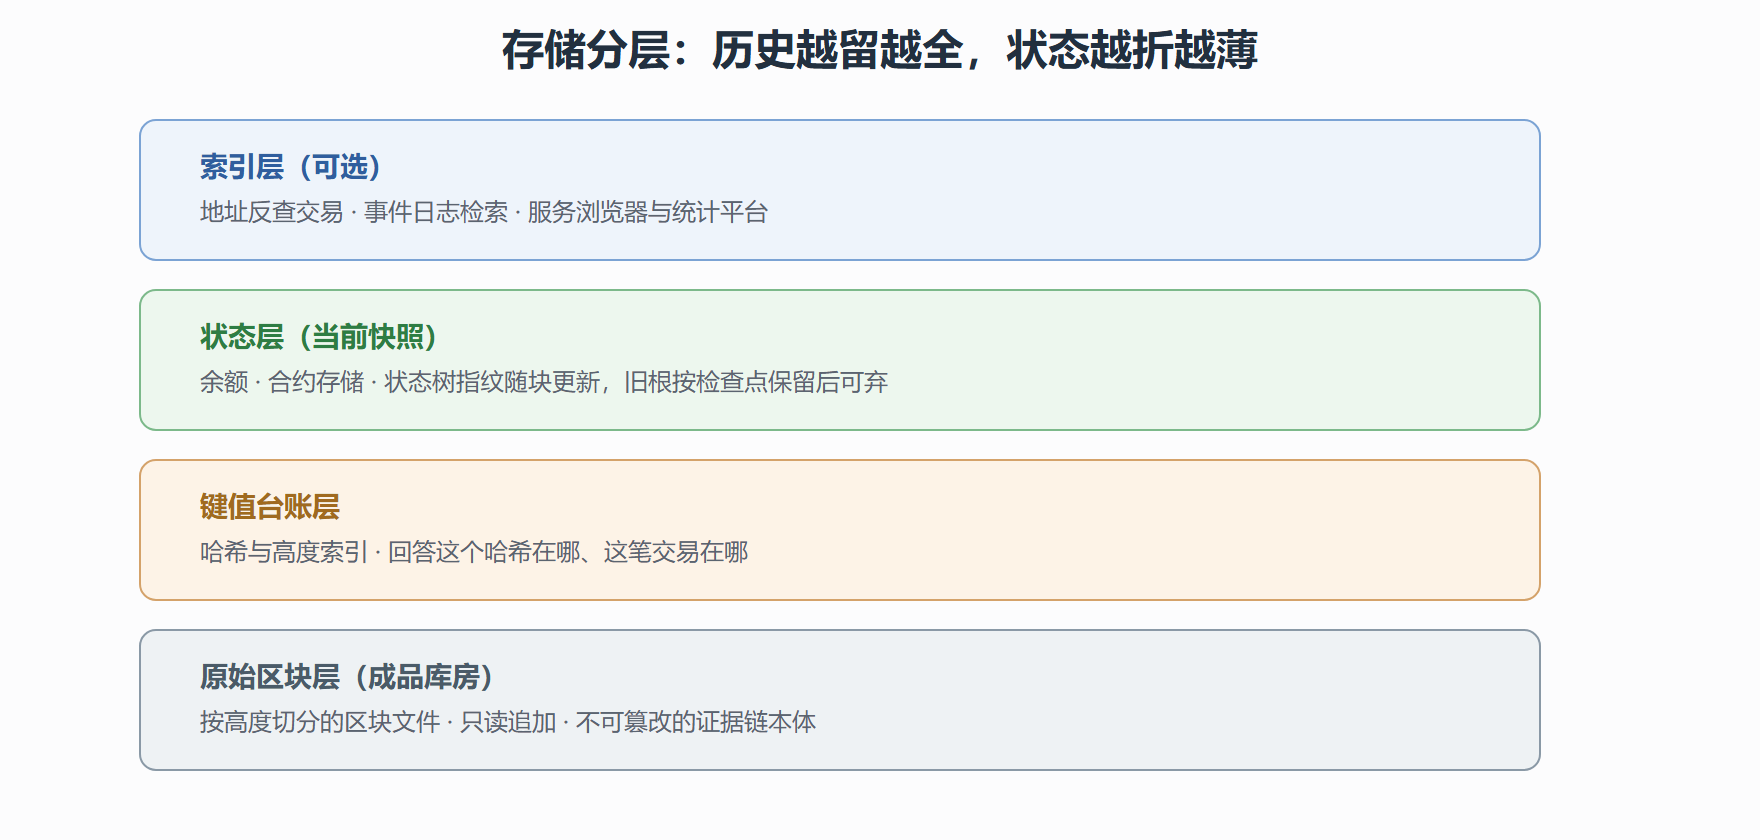
各层的修剪策略不同:区块层可按窗口丢弃区块体(保留头),状态层靠新根共享旧分支增量演进,索引层随时可重建——可重建的数据都可以扔,不可重建的证据才必须留,这是存储管理的总纲。
用代码把"状态读写 + 增量指纹"的最小形态搭出来:
import hashlib class StateStore: """最小状态存储:嵌套树形结构 + 内容指纹""" def __init__(self): self.accounts = {} # 地址 -> {余额, 随机数} def fingerprint(self) -> str: """状态指纹 = 全部账户状态的有序哈希(真实链为树根)""" blob = "".join( f"{addr}:{a['balance']}:{a['nonce']}" for addr, a in sorted(self.accounts.items())) return hashlib.sha256(blob.encode()).hexdigest()[:16] def apply(self, tx: dict) -> str: """执行一笔交易:检查随机数防重放,改状态,返回新指纹""" acct = self.accounts.setdefault(tx["from"], {"balance": 0, "nonce": 0}) assert acct["nonce"] == tx["nonce"], "随机数不符:重放或乱序" assert acct["balance"] >= tx["amount"] + tx["fee"], "余额不足" acct["balance"] -= tx["amount"] + tx["fee"] acct["nonce"] += 1 to = self.accounts.setdefault(tx["to"], {"balance": 0, "nonce": 0}) to["balance"] += tx["amount"] return self.fingerprint() state = StateStore() state.accounts["alice"] = {"balance": 1000, "nonce": 0} root1 = state.apply({"from": "alice", "to": "bob", "amount": 100, "fee": 1, "nonce": 0}) root2 = state.apply({"from": "alice", "to": "bob", "amount": 100, "fee": 1, "nonce": 1}) print("状态指纹演进:", root1, "->", root2) print("余额:", state.accounts["alice"], state.accounts["bob"])
注意交易里那个"随机数"字段(账户交易计数器):它不是加密用途的随机数,而是严格递增的序号,专防同一笔签名交易被重放两次——状态层的第一道防线。
修剪策略模拟:什么可以扔
修剪的本质是在"验证能力"与"磁盘占用"之间做交易。全能力节点(归档节点)保留一切;修剪节点保留近期区块与当前状态,丢弃更早的区块体(区块头与焊缝保留,安全性主干不伤);轻节点只留区块头。用模拟对比策略的磁盘曲线:
def simulate_growth(blocks: int, block_kb: int, state_kb_per_block: int): """对比归档与修剪节点的数据量增长""" archive, pruned = [], [] history = 0 for h in range(1, blocks + 1): history += block_kb # 历史只增不减 state = min(h * state_kb_per_block, 200_000) # 状态增长趋缓 archive.append(history + state) pruned.append(min(history, block_kb * 288) + state) # 只留近一段区块体 return archive, pruned arch, prun = simulate_growth(blocks=1000, block_kb=2000, state_kb_per_block=120) for h in (100, 500, 1000): a, p = arch[h - 1] / 1e6, prun[h - 1] / 1e6 print(f"高度 {h:>4}: 归档 {a:5.2f} GB | 修剪 {p:5.2f} GB | 差 {a/p:4.1f} 倍")
输出的剪刀差会随时间无限拉大——归档节点的数据量是历史线性函数,修剪节点被钉在"近期窗口 + 当前状态"上。真实公链生态由此分化:归档节点由专业服务商与基金会运营(浏览器、分析平台需要历史明细),普通验证者跑修剪配置,钱包用轻模式。生态分工而非技术奇迹,消化了无限追加。
另一个值得写进笔记的机制是快照:定期把当前状态树整体固化,新节点同步时从最近的快照起跑、只回放之后的区块,免去了从创世重放全程。快照的正确性锚定在链上登记的状态根,因此"从快照加入"并不削弱信任——你验证的是焊缝与状态指纹的衔接,而非重放每一个历史步骤。
工程现实:容量账本与选型
给一份节点运维的容量账本框架,评估不同配置的投入:
| 节点配置 | 保留内容 | 容量量级(成熟公链) | 恢复方式 |
|---|---|---|---|
| 归档 | 全部历史 + 全部历史状态 | 数太字节级,持续增长 | 快照 + 校验,或全量同步 |
| 全节点(修剪) | 全部区块头 + 近期区块体 + 当前状态 | 数百吉字节级 | 近期快照 + 回放 |
| 轻节点 | 区块头链 | 数十兆字节级 | 即插即用 |
⚠️ 三个现场坑。其一,把键值数据库的压缩与账本修剪混为一谈:压缩只是把同一份数据变小,修剪是扔掉部分验证能力,安全语义完全不同。其二,快照来源必须可校验:来路不明的快照等于把信任外包给下载站,正规流程要求快照根与链上登记一致。其三,固态盘的写放大与键值库的压实机制相互作用,成熟公链的节点普遍要求企业级存储耐久度——用消费级盘跑验证节点,坏盘时间线常常比预期激进得多。
💡 存储层的判词:历史越留越全,状态越折越薄。区块文件负责"不可抵赖的过去",状态树负责"可验证的现在",索引负责"问得到的问题"——三层各司其职,谁也不越界替谁扛活。
攻防边界:存储层的威胁姿势
存储层的攻击面低调但真实:数据投毒(喂给新同步者假区块或假快照,防御靠头部锚定与根校验)、状态膨胀攻击(用微额交易塞满状态树,让所有节点的状态层被迫膨胀,防御靠状态租金类机制——对占用状态的存储收费,逼垃圾数据自然过期)、以及物理层的磁盘损耗。这些威胁的共性是不攻密码学、专攻经济性与运维耐心,防御思路也一贯:把资源占用定价,让攻击者为自己的每一字节付费。
车间全部设施交付完毕:账本组织、数据单元、传输网络、自动机床、成品仓库。下一章走进熔炉工段——全厂温度最高的地方,共识机制将从"为什么需要"讲到"怎么选型",从烧电竞赛讲到押注表决。