4.2 性能瓶颈与密文膨胀的量化
4.2 性能瓶颈与密文膨胀的量化
本节摘要:同态系统的性能问题集中在两本账上:时间账(数论变换、重线性化、旋转、自举的相对成本)与空间账(密文膨胀倍数、密钥体积、带宽压力)。本节逐项给出量级数字与推导,分析"时间去了哪里"的剖析方法,讨论什么负载适合摊销、什么负载会被摊销反噬,并给出性能调优的优先级清单。
时间账:一个乘法的内部剖析
把一次密文乘法拆开看时间去向,会发现教科书里的一句话"密文相乘"在工程里是四段流水:张量积(多项式乘法,靠数论变换,负负得正的正变换与逆变换各若干次)、位分解(把大系数按比特拆成几十份小系数)、密钥交换(分解结果与重线性化密钥的批量乘加)、模归约。四段的占比随实现与硬件浮动,但量级格局稳定:数论变换类运算(正逆变换)占一半上下,密钥交换相关的批量乘加占三成以上,剩下是分解与归约杂项。这个格局直接给出两条结论:其一,优化数论变换就是优化一切(第四节的主题);其二,重线性化是乘法贵于加法的主因,能省则省——例如连乘多个密文时,用"明文与密文混合"的表达(把部分项作为明文系数乘入)可以显著减少重线性化次数。
各操作的成本比例值得背下来做心算(以单线程中央处理器为基准的量级):密文加法最便宜,记为一;明文乘密文约一到三;密文乘法(含重线性化)约十到五十(视维度与链位);旋转约与密文乘法同档;自举高出基础乘法三到五个数量级(布尔线毫秒级单门、近似线数百毫秒级整批)。用这套比例可以快速估算负载:一个四层多项式变换(隐私推理的典型激活)约等于十几次乘法加几次旋转,四千零九十六维度的单线程耗时以百毫秒计;同样负载换到 GPU 上按两个数量级加速预期做规划。
空间账:膨胀不是传说
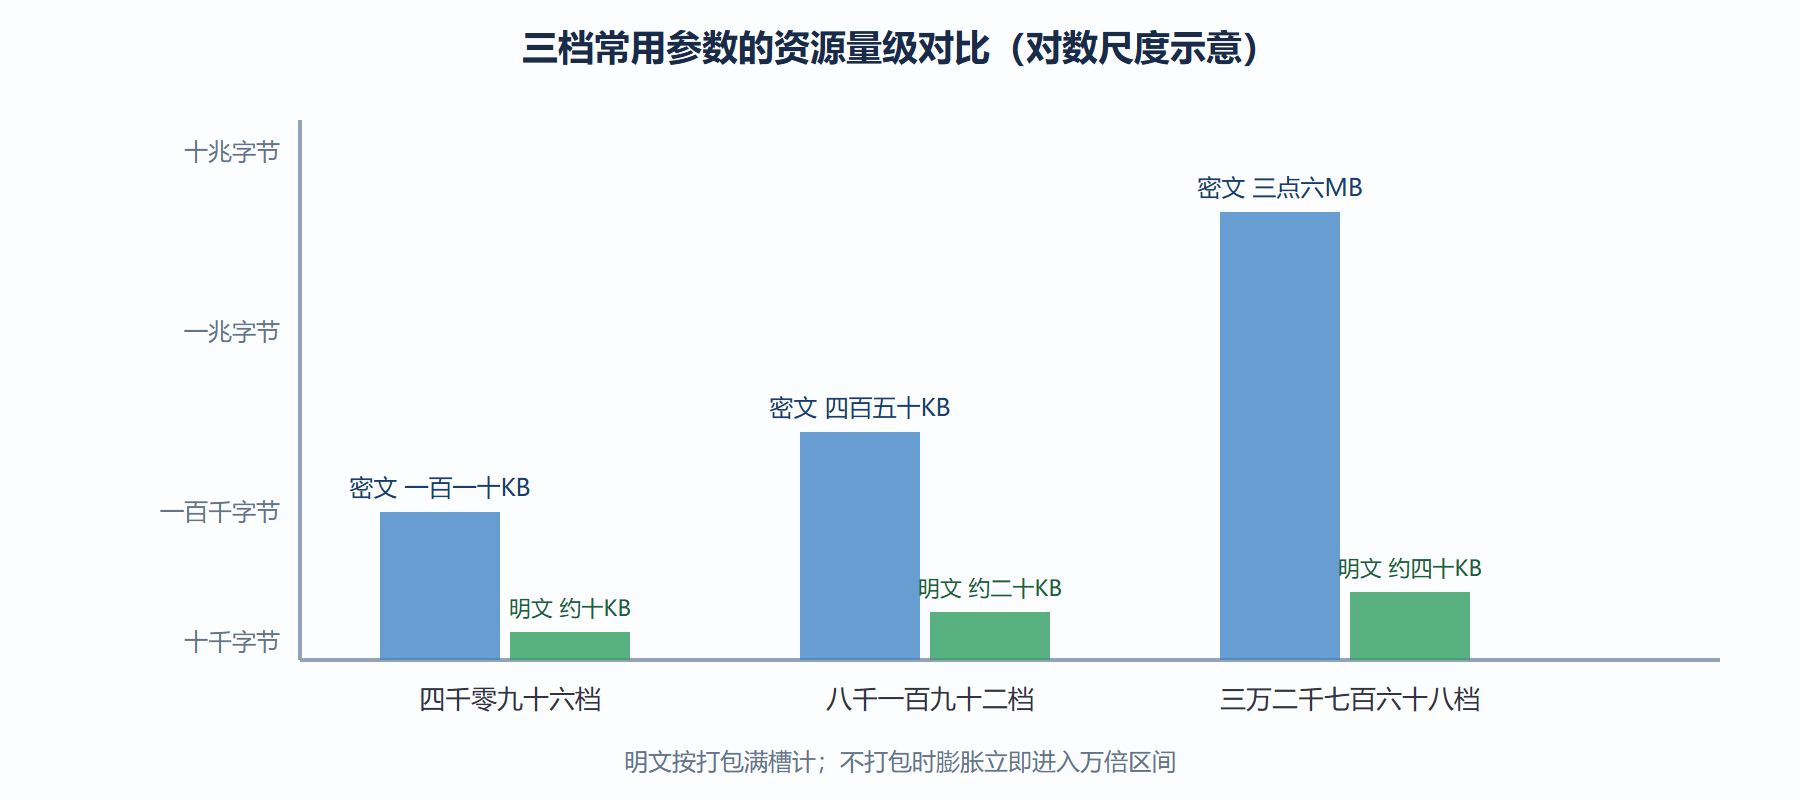
密文膨胀的数字必须亲手算一遍才有体感。公式很简单:密文是两条系数多项式,每系数占系数模数的比特数,所以密文字节数约等于二乘维度乘系数模数比特数再除以八。代入常用档:四千零九十六维度、一百零九比特模数,约一百一十千字节;八千一百九十二维度、二百一十八比特模数,约四百五十千字节;三万二千七百六十八维度、四百三十八比特模数,约三点六兆字节。明文侧按槽位数乘每槽比特数算:四千零九十六槽乘二十比特约一万字节。膨胀倍数(密文比明文)在一百一十千字节对一万字节这一档约十倍出头,但若不打包(逐个加密小整数),膨胀立即跳到万倍级——又一次说明打包是生死线。
密钥侧的账同样要算:重线性化密钥的条数等于分解位数(几十条),每条尺寸与密文同档,总量以兆字节计;伽罗瓦密钥按旋转步数生成,全量旋转密钥可达数十兆字节(有专门压缩技术);自举密钥再加一份。一个完整的"运行时公钥包"在实用配置下以几十到几百兆字节起步,这是客户端与服务器握手时真实传输与驻留内存的量。带宽规划失败的团队几乎都是只算了密文没算密钥包。
图:常用参数档的密文尺寸与膨胀
| 资源项 | 常用量级(四千至八千维度档) | 说明 |
|---|---|---|
| 单密文 | 一百一十至四百五十千字节 | 依维度与模数 |
| 明文载荷(打包后) | 五至二十千字节 | 槽位数乘每槽比特 |
| 膨胀倍数 | 打包下约十到二十倍 | 不打包可达万倍 |
| 重线性化密钥 | 兆字节级 | 条数等于分解位数 |
| 全量旋转密钥 | 数十兆字节 | 可用特定步长压缩 |
| 自举密钥包 | 数十兆字节 | 含多组自举材料 |
摊销的边界:什么负载不适合
摊销是打包时代的核心叙事,但它有明确的边界条件:负载必须能重排成定长向量、且运算以槽内为主。两类负载会被摊销反噬。第一类是分支密集的逻辑:大量比较、过滤、条件更新,槽内的数据相关性让向量重排变得低效,此时布尔线的门并行反而是正解。第二类是小规模高频交互:每次请求只算几十个数,密文打包的四千槽大多是填充浪费,密钥包的传输成本更无法摊销——这类负载的经典解法是把协议改成批量接口,或者退回部分同态方案(Paillier 的线性聚合便宜得多)。
性能调优的优先级清单因此有固定形状:第一步永远是负载向量化与批处理接口化(收益一到两个数量级,零硬件成本);第二步是电路层优化——减少乘法深度、用低次逼近、复用旋转结果(收益常数倍到数倍);第三步才是表示层与硬件层(残差系统、向量化指令、GPU,各一到两个数量级)。跳过前两步直接买硬件,是把最贵的杠杆用在了最便宜的环节。
⚠️ 常见坑:性能压测只测吞吐不测尾延迟。自举与密钥生成的耗时呈现长尾分布,平均延迟好看而分位延迟崩坏,在线服务接口尤其要按尾延迟验收。
排错案例:一个真实的性能解剖
给一个完整案例收束本节。某加密统计服务的接口耗时超出预算十倍,解剖过程:先测各阶段耗时占比,发现百分之七十耗在旋转;读代码发现矩阵乘向量按朴素逐元素实现,旋转次数是槽位数量级;改用对角线法后旋转次数降为维度一半并大幅复用,接口耗时降到原来的八分之一;再把批处理接口从十条一批改满四千槽,整体再降一个数量级——全程没有动硬件与参数。这个案例的教训写进设计守则:性能解剖的第一问永远是"旋转与自举占比多少",第二问是"批次打满了吗",第三问才轮到"参数档与硬件"。
- 要点一:一次密文乘法的耗时四段流水里数论变换占一半上下,重线性化是乘法贵的主因;操作成本比例表支持心算估算
- 要点二:膨胀要亲手算——密文约二乘维度乘模数比特除以八;密钥包几十到几百兆字节是带宽规划的隐藏大头
- 要点三:摊销有边界,分支密集与小规模高频负载会被反噬;调优优先级是向量化、电路优化、再硬件
- 要点四:性能解剖三问——旋转自举占比、批次是否打满、参数与硬件——按序排查成本最低
四、与膨胀共处的存储架构
密文膨胀不是可以优化消失的 bug,而是需要架构共处的物理事实,给三套共处方案。方案一,分层存储:原始密文落冷存储,参与计算的热数据驻留内存池,计算完即弃——同态计算的特点是密钥与参数常驻、密文流动性强,存储分层对它天然友好。方案二,流式计算:把大数据集切成批次,内存里只保持当前批次与累积结果,云端推理场景几乎都这么跑——代价是批间调度与打包策略要精细设计。方案三,压缩与截断:CKKS 的密文系数可以重打包(seed 收缩,同一随机源的密文只存种子),配合模切换把多余层级及时剪掉,膨胀系数能压回一个数量级——这是最容易被忽略的白捡优化。三案之外补一条采购视角:评估云上同态服务时,把内存规格与密文膨胀的乘积折算成单位计算成本,这比看裸的每秒运算数诚实得多——膨胀决定了你能把多大的问题塞进一台机器,塞不进去,再快的算力也只是橱窗里的展品。