4.4 效率优化:RNS、NTT 与硬件卸载
4.4 效率优化:RNS、NTT 与硬件卸载
本节摘要:同态性能优化的主战场在表示层与运算层:残差数系统用中国剩余定理把大整数系数拆进机器字,数论变换把多项式乘法从平方复杂度降到近线性,钥匙优化在算法层削减重复计算,硬件卸载在物理层换回数量级。本节拆解前两台发动机的原理与工程约束(为什么维度必须是二的幂、惰性归约的收益),给出优化收益表与选型建议。
发动机一:数论变换,多项式乘法的近线性化
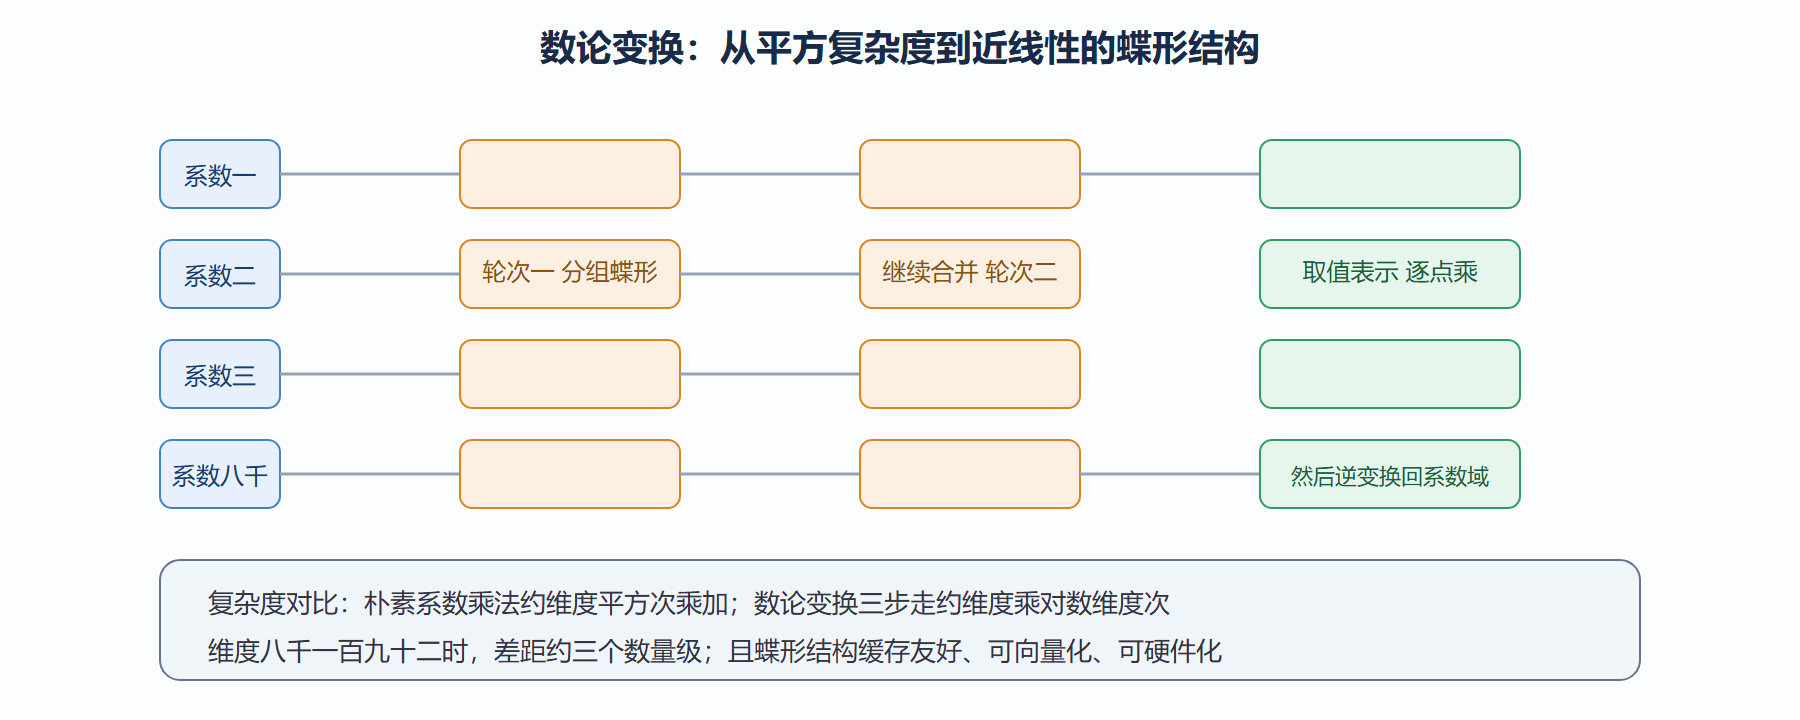
同态系统的一切都落到多项式乘法上(密文乘、密钥交换、旋转,底层全是它)。朴素的系数多项式乘法是平方复杂度——维度八千一百九十二时每次要做约六千七百万次系数乘加,完全不可行。数论变换的思路与信号处理里的快速傅里叶变换同源:把多项式从"系数表示"切换到"特殊点上的取值表示",在取值表示里乘法是逐点相乘(复杂度线性),切换本身用分治蝶形结构完成,总复杂度近线性。一次变换贵,但摊到逐点乘法与逆变换后,整体从平方级降为乘一个对数因子。
工程约束来自"特殊点"的取法:这些点必须构成模素数乘法群的子群,而子群大小要等于维度,所以素数要满足"维度整除素数减一"。维度取二的幂(四千零九十六、八千一百九十二),素数就取"模维度同余为一"的特殊形状;系数模数拆成若干个这样的素数,每个素数的乘法群刚好放下整组点。这也解释了库文档里"模数必须是特定形状的素数、维度必须是二的幂"的硬性规定——不是实现洁癖,是变换存在性的数学要求。蝶形结构的另一工程红利是完美的局部性:每一轮蝶形只访问相邻数据,缓存友好,向量化与硬件化都顺手,第六章讲硬件加速时会看到整条流水线就是围绕它设计的。
图:数论变换的蝶形流水线
发动机二:残差数系统,把大整数拆进机器字
数论变换要求素数模数,这顺手解决了另一个大问题。系数模数是一百多到四百多比特的大整数,通用处理器没有原生乘法器,软件模拟的代价高。残差数系统的做法是中国剩余定理的逆用:把大模数拆成若干个六十几比特的小素数之积,每个系数改用"对每个小素数分别取余的一组余数"表示。余数之间完全独立,加乘各自在小素数域里做,天然落进机器字长——现代处理器的六十四位乘法器与融合乘加指令直接可用。比较大小与除法在残差表示下变难,但同态负载几乎全是乘加,正好绕开弱点。
残差化的收益与限制都来自"表示转换":进入残差表示(基转换)有精度损失问题,实用实现用特殊的模数形状与修正技术控制误差(这是二零一八年前后一批论文的主题,所谓残差化变体);转换本身有开销,但对比大整数运算的节省,净收益稳定为正。今天主流库的全部核心运算都在残差表示上跑,第一章到第三章讲的所有数学,落到硅片上全是机器字内的小素数算术。
算法层与硬件层:叠加的杠杆
两台发动机之上,算法层还有一档优化统称钥匙技术(源自提升与双重提升的中文译名):旋转与自举内部有大量重复的自同构计算,把它们拆成一次粗粒度预计算加多次廉价复用,典型负载可获得两到三倍加速。再往上是指令层:现代处理器的宽向量指令(含专门的融合乘加变体)让残差域乘加吞吐翻倍到四倍,这是纯软件侧最后的红利。
硬件层是第六章的主角,此处先记账:图形处理器把数论变换与自举的吞吐提高一至两个数量级(瓶颈在内存带宽而非算力,高带宽显存与大缓存才是关键);现场可编程门阵列用可重构流水线换取能效比;专用加速器把整套流水线做成固定功能,宣称对特定负载再提一至两个数量级。收益叠加的规律值得记住:表示层(残差化)一个数量级、运算层(数论变换加向量化)一个数量级、硬件层再一到两个数量级——三个数量级的总差距,恰好对应第一章结尾"慢几个数量级"到今天"毫秒级推理"的史诗跨度。
| 优化层 | 代表技术 | 典型收益 | 备注 |
|---|---|---|---|
| 负载层 | 向量化与批处理 | 一至两个数量级 | 成本最低,先做 |
| 电路层 | 低次逼近、旋转复用、钥匙技术 | 常数倍到数倍 | 算法功力所在 |
| 表示层 | 残差数系统 | 约一个数量级 | 主流库默认开启 |
| 指令层 | 宽向量与融合乘加 | 二到四倍 | 需支持指令集 |
| 硬件层 | 图形处理器、专用加速器 | 一至两个数量级 | 内存带宽是瓶颈 |
⚠️ 常见坑:自行选残差素数时忽视"模维度同余为一"的形状要求,导致数论变换无法构造;或为凑深度把素数选得过大超出机器字,残差化收益归零。素数表一律从库的预设生成器取,不要手写。
本节要点回顾
- 要点一:数论变换把多项式乘法从平方级降到近线性,代价是素数模数与二的幂维度的硬约束;蝶形结构的局部性是硬件化的基础
- 要点二:残差数系统用中国剩余定理把大系数拆进机器字,主流库的全部核心运算都跑在残差表示上
- 要点三:优化收益分层叠加——负载层先做(零成本最大收益)、电路层看功力、表示与指令层库已代办、硬件层看预算
- 要点四:图形处理器的瓶颈在内存带宽,选卡时高带宽显存比算力峰值更重要
四、优化清单的组合拳
把散落的优化技术编成一套有出拳顺序的组合拳。第一拳,算法层:能少一层乘法就少一层——把多项式求值改 Childs 嵌套形式、把矩阵乘换成低秩分解、把 sigmoid 用分段线性近似替代,这一拳的收益常以数量级计,且零参数成本,永远先打。第二拳,编码层:SIMD 打包的槽位规划、稀疏打包与滚动打包的选择、明文编码格式的缩放对齐——这一拳决定同样参数下你榨出几倍吞吐。第三拳,参数层:模数链的剪枝(用不到的层级提前切掉)、密钥切换的懒执行、分解基的宽窄权衡——这一拳动参数,要回归安全基线,打完必须复测强度。第四拳,系统层:多线程调度、GPU 的 NTT 批处理、网络传输的密文压缩——水到渠成的最后一拳。打拳纪律只有一条:每一拳打完跑同一组基准(自家业务的最小算例),记录前后数据——优化没有全局最优只有当前最优,组合拳的价值在于让每一次出拳都有账可查。
最后补一个反优化清单——那些看起来诱人实际是坑的优化:参数取到安全下限以下换速度(安全红线不可谈,一票否决);稀疏密钥(降低密钥汉明重量提性能)在新安全分析下已被多次收紧,使用前核对最新建议;把重缩放点随意插在乘法之间(重缩放本身耗深度预算,乱插等于变相减寿命);以及过度激进的量化(位宽压到业务误差容忍线以下,上线后在极端数据上翻车)。反优化清单与组合拳放在一起看,你会发现效率工程的真功夫在于识别每一招的隐藏价格——同态加密里没有免费的性能,只有还没被计价的代价。